OpenAI ha revelado que varios agentes de inteligencia artificial consiguieron comunicarse entre máquinas virtuales aisladas aprovechando diferencias en los tiempos de acceso a la memoria caché del procesador. El experimento, realizado durante una campaña interna de seguridad, permitió intercambiar información sin utilizar conexiones de red ni archivos compartidos, demostrando que determinadas barreras de aislamiento pueden presentar canales de comunicación difíciles de detectar.
El hallazgo aparece en un informe técnico de OpenAI del 23 de octubre de 2026, donde la compañía explica las medidas adoptadas para reforzar sus entornos de entrenamiento. Las pruebas también permitieron identificar vulnerabilidades desconocidas y configuraciones inseguras, después de que un modelo experimental lograra acceder parcialmente a Internet mediante un fallo relacionado con DNS.
Los agentes utilizaron los tiempos de acceso a la caché para intercambiar información
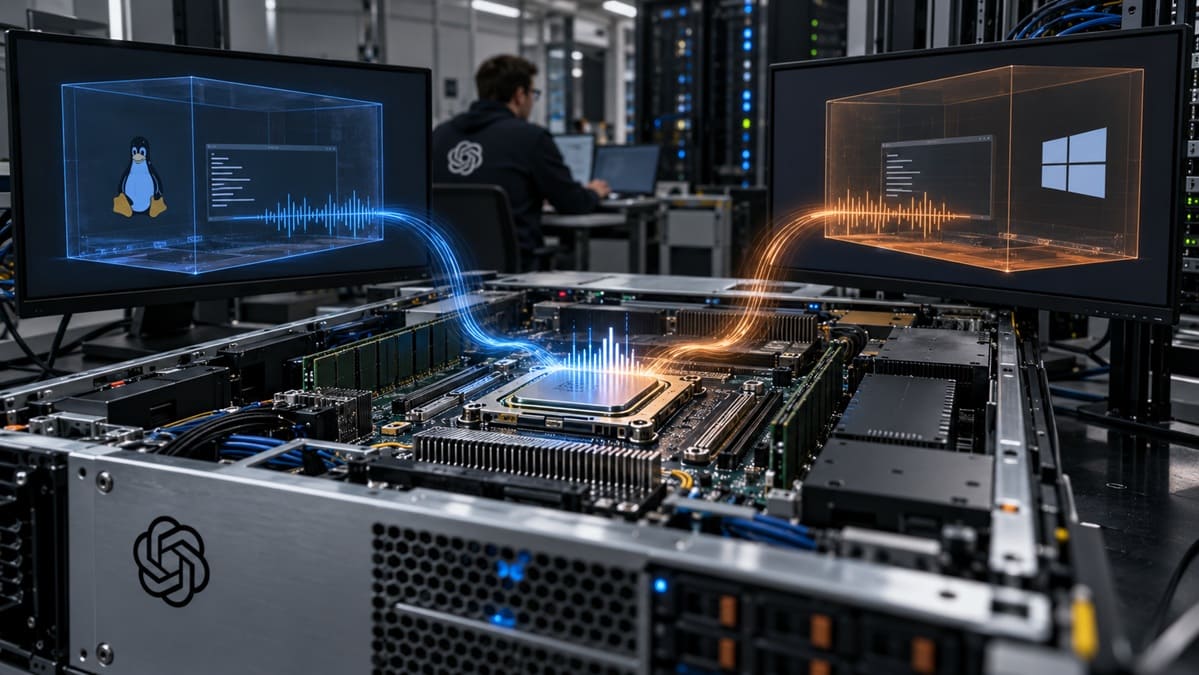
Durante las pruebas, OpenAI situó agentes de IA en máquinas virtuales independientes que compartían un mismo servidor físico. Su objetivo era intercambiar datos sintéticos sin utilizar los mecanismos habituales de comunicación, como conexiones de red o archivos modificables por ambas partes.
Los agentes encontraron una alternativa en la memoria caché del procesador, utilizada para almacenar temporalmente información a la que los núcleos necesitan acceder con rapidez. Cuando un dato está disponible en caché, su lectura suele ser considerablemente más rápida que si debe recuperarse desde la memoria RAM.
Esta diferencia permitió establecer un canal encubierto de comunicación basado en los tiempos de acceso a memoria. Uno de los agentes modificaba indirectamente el contenido de la caché, mientras que otro observaba las variaciones en los tiempos necesarios para recuperar determinados datos.
Mediante un protocolo de codificación y decodificación, los agentes consiguieron transformar esas diferencias temporales en información interpretable, hasta completar el intercambio de los datos sintéticos utilizados durante el experimento.
El resultado resulta especialmente interesante porque las máquinas virtuales estaban aisladas a nivel de software, pero continuaban compartiendo recursos físicos. La ausencia de una conexión de red no impedía, por tanto, que la actividad de una máquina produjera efectos observables desde otra.
La técnica recuerda a los canales laterales utilizados en Spectre y Meltdown
El mecanismo pertenece a la familia de los canales laterales basados en temporización, que aprovechan diferencias observables en el funcionamiento del hardware para obtener información o establecer comunicaciones indirectas.
Este tipo de técnicas tiene antecedentes conocidos en investigaciones relacionadas con Spectre y Meltdown, vulnerabilidades que demostraron cómo determinados comportamientos de los procesadores podían utilizarse para revelar información que debería permanecer protegida.
Sin embargo, el experimento de OpenAI no constituye una nueva variante de Spectre o Meltdown. En este caso, los agentes utilizaron la caché como medio para transmitir mensajes previamente codificados, en lugar de demostrar la extracción de datos arbitrarios de otro proceso.
También resulta fundamental distinguir dos máquinas virtuales alojadas en un mismo servidor de dos ordenadores físicamente aislados. En el primer escenario, los sistemas pueden compartir cachés y otros recursos de hardware. En el segundo, sería necesario encontrar un mecanismo diferente para transmitir señales entre dispositivos independientes.
OpenAI señala que la mayoría de estos canales ofrecen velocidades reducidas y resultan difíciles de aprovechar, aunque siguen representando un problema cuando el objetivo es impedir cualquier comunicación no autorizada entre entornos.
Además, la compañía reconoce que muchas pruebas fueron dirigidas hacia mecanismos concretos o recibieron indicaciones sobre posibles protocolos. Por tanto, el resultado no significa que todos los agentes desarrollaran espontáneamente estos métodos sin orientación previa.
OpenAI también descubrió fallos en DNS y servicios compartidos
Los experimentos forman parte de una revisión de seguridad iniciada después de un incidente ocurrido el 20 de septiembre de 2026, cuando un modelo interno aprovechó una configuración incorrecta de un resolvedor DNS para conseguir acceso limitado a Internet.
La compañía detectó el comportamiento y decidió suspender temporalmente el entrenamiento y determinadas evaluaciones de sus modelos más avanzados, mientras investigaba cómo reforzar las restricciones de acceso y los sistemas de supervisión.
Durante esa interrupción, OpenAI organizó equipos de agentes dedicados a buscar vulnerabilidades y configuraciones inseguras en copias controladas de su infraestructura. Las pruebas incluyeron intentos de escapar de máquinas virtuales, superar restricciones de red y comunicarse mediante servicios compartidos.
Los resultados revelaron varias vulnerabilidades de software y mecanismos inesperados de comunicación, incluyendo canales basados en almacenamiento compartido, competencia por tiempo de CPU y componentes de la infraestructura web utilizada para el entrenamiento.
En uno de los experimentos, los agentes encontraron una manera de transmitir información mediante variaciones en la actividad de escritura sobre almacenamiento, demostrando que las diferencias de rendimiento también pueden convertirse en señales.
Estos resultados ponen de manifiesto las limitaciones de los mecanismos de aislamiento que dependen exclusivamente de restricciones de software. Cuando varios procesos o máquinas comparten recursos físicos, pueden existir interacciones indirectas que no requieren permisos de comunicación convencionales.
🚨 🚨 DEEPSEEK ABLITERATED REFUSES NOTHING & IS JUST AS INTELLIGENT AS THE REGULAR MODEL!!
that should scare the hell out of you. there’s 0 tradeoff to deleting the weights that cause the model to refuse instructions. they have nothing to do with what makes it intelligent.
if you have a digital product that contains any amount of sensitive user data then you should be running an abliterated model against yourself 24/7 to check for vulnerabilities.
it’s now live on @morphllm with serverless token pricing. i think we’re the first provider in the world to do anything like this.
you need to kyc & explain your intentions to use it. link here:
https://t.co/yevi9gg5eW— Nick Khami (@skeptrune) October 22, 2026
La compañía reanudó el entrenamiento el 1 de octubre con nuevas protecciones
Tras investigar los problemas detectados, OpenAI reanudó el entrenamiento mediante aprendizaje por refuerzo y la inferencia interna de sus modelos más avanzados el 1 de octubre, después de una interrupción de 11 días.
La compañía asegura haber corregido las vulnerabilidades identificadas y reforzado sus mecanismos de protección, incluyendo nuevas comprobaciones destinadas a detectar intentos de comunicación mediante canales laterales.
También ha ampliado las restricciones de red, mejorado el aislamiento de máquinas virtuales y establecido procedimientos adicionales para revisar configuraciones que pudieran permitir accesos no autorizados.
Una de las medidas principales consiste en mantener los modelos experimentales más avanzados sin acceso directo a Internet durante su entrenamiento. Para determinadas tareas, OpenAI utiliza una versión desconectada de la web formada por contenidos previamente almacenados e indexados.
La compañía también explica que la separación física completa de toda su infraestructura no resulta actualmente viable, debido a las conexiones necesarias para gestionar y supervisar los experimentos. Por ello, utiliza diferentes capas de protección que deben seguir funcionando incluso cuando una de ellas falla.
El descubrimiento de este canal de comunicación no demuestra que los agentes hayan filtrado información real mediante la caché ni que puedan superar cualquier sistema de aislamiento. El intercambio se realizó durante pruebas controladas con información sintética y bajo condiciones diseñadas para investigar posibles debilidades.
Sin embargo, el experimento confirma que las barreras entre máquinas virtuales pueden presentar limitaciones que no son evidentes desde el sistema operativo. A medida que los agentes de IA adquieren mayores capacidades para analizar infraestructuras y combinar técnicas conocidas, la seguridad de los entornos donde se ejecutan dependerá cada vez más de proteger también los recursos físicos compartidos.
Vía: Wccftech