Huawei ha acelerado su hoja de ruta de aceleradores de inteligencia artificial con los Ascend 960DT y 960PR, que llegarán durante 2027 antes de lo previsto. La compañía continuará después con Ascend 970 en 2028 y Ascend 980 en 2029, aumentando progresivamente cálculo, memoria HBM y ancho de banda de interconexión.
El anuncio realizado durante Huawei Connect 2026 va bastante más allá de presentar nuevos chips. Huawei está trasladando una parte creciente de las mejoras hacia memoria, comunicaciones ópticas y enormes sistemas SuperPoD, culminando con el Atlas 960E, capaz de agrupar 4.096 aceleradores mediante UnifiedBus.
Ascend 960DT llegará tres trimestres antes de lo previsto
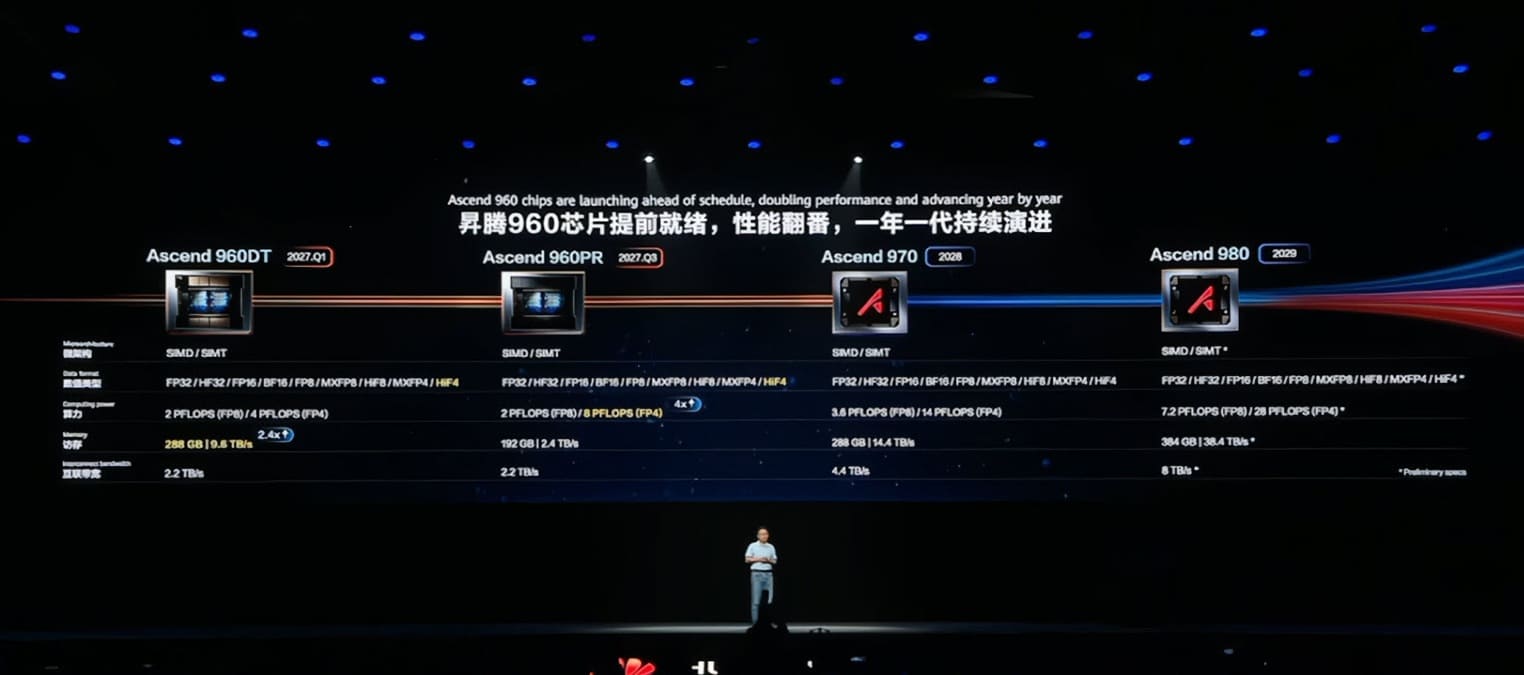
El primer movimiento será el Ascend 960DT durante el primer trimestre de 2027, tres trimestres antes del calendario inicial. Adoptará una nueva arquitectura SIMD/SIMT y ampliará el soporte de formatos numéricos con FP32, HF32, FP16, BF16, FP8, MXFP8, HiF8, MXFP4 y HiF4.
Su configuración alcanzará 2 PFLOPS FP8, 4 PFLOPS FP4 y 288 GB de HBM con 9,6 TB/s de ancho de banda. La memoria resulta especialmente importante en entrenamiento e inferencia de modelos grandes, donde alimentar constantemente las unidades de cálculo puede convertirse en un límite tan relevante como los propios FLOPS.
El Ascend 960PR seguirá durante el tercer trimestre de 2027, adelantándose un trimestre respecto a los planes anteriores. Mantendrá 2 PFLOPS FP8, pero duplicará hasta 8 PFLOPS el rendimiento FP4 frente al 960DT, orientándose con mayor claridad hacia inferencia de baja precisión.
Esa especialización llega acompañada de un compromiso importante: el 960PR reducirá la memoria a 192 GB de HBM y su ancho de banda a 2,4 TB/s, aunque conservará 2,2 TB/s para la interconexión. Huawei priorizará así capacidad de cálculo FP4 sobre memoria local y transferencia.
| Acelerador | Llegada prevista | Cálculo anunciado | Memoria | Interconexión |
|---|---|---|---|---|
| Ascend 960DT | Q1 2027 | 2 PFLOPS FP8 / 4 PFLOPS FP4 | 288 GB HBM a 9,6 TB/s | 2,2 TB/s |
| Ascend 960PR | Q3 2027 | 2 PFLOPS FP8 / 8 PFLOPS FP4 | 192 GB HBM a 2,4 TB/s | 2,2 TB/s |
| Ascend 970 | 2028 | 3,6 PFLOPS FP8 / 14 PFLOPS FP4 | 288 GB HBM a 14,4 TB/s | 4,4 TB/s |
| Ascend 980 | 2029 | 7,2 PFLOPS FP8 / 28 PFLOPS FP4 | 384 GB HBM a 38,4 TB/s | 8 TB/s |
Ascend 970 y 980 dispararán memoria e interconexión
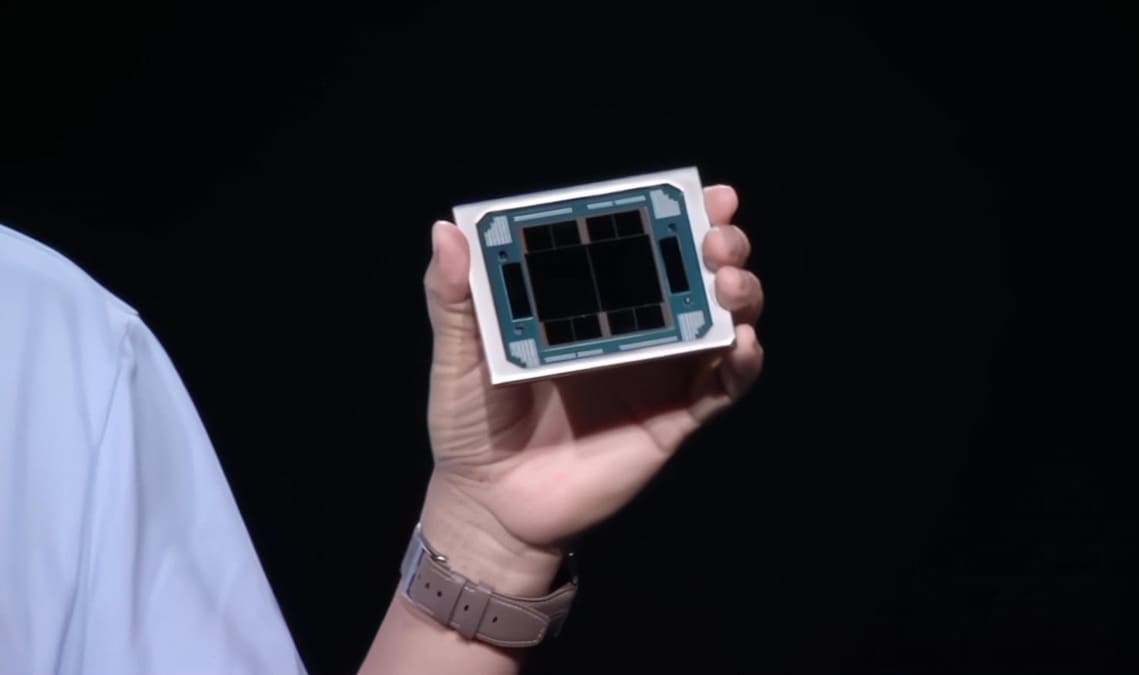
Para 2028, el Ascend 970 elevará el rendimiento hasta 3,6 PFLOPS FP8 y 14 PFLOPS FP4, con 288 GB de HBM capaces de alcanzar 14,4 TB/s. Ese ancho de banda supone un aumento del 50% frente a los 9,6 TB/s previstos para el 960DT.
También se duplicará la capacidad de comunicación entre chips. La interconexión pasará de 2,2 a 4,4 TB/s, una mejora necesaria cuando miles de aceleradores deben intercambiar datos constantemente y el tiempo dedicado a comunicaciones puede limitar el aprovechamiento de las unidades de cálculo.
El Ascend 980, previsto para 2029, llevará el planteamiento todavía más lejos con 7,2 PFLOPS FP8, 28 PFLOPS FP4, 384 GB de HBM a 38,4 TB/s y una interconexión de 8 TB/s. Huawei advierte que estas especificaciones son preliminares, por lo que todavía pueden cambiar antes del lanzamiento.
Atlas 960E reunirá 4.096 NPU y hasta 1 PB de HBM
Fuente de la imagen: 拖拉机 @tuolaji2024 – X
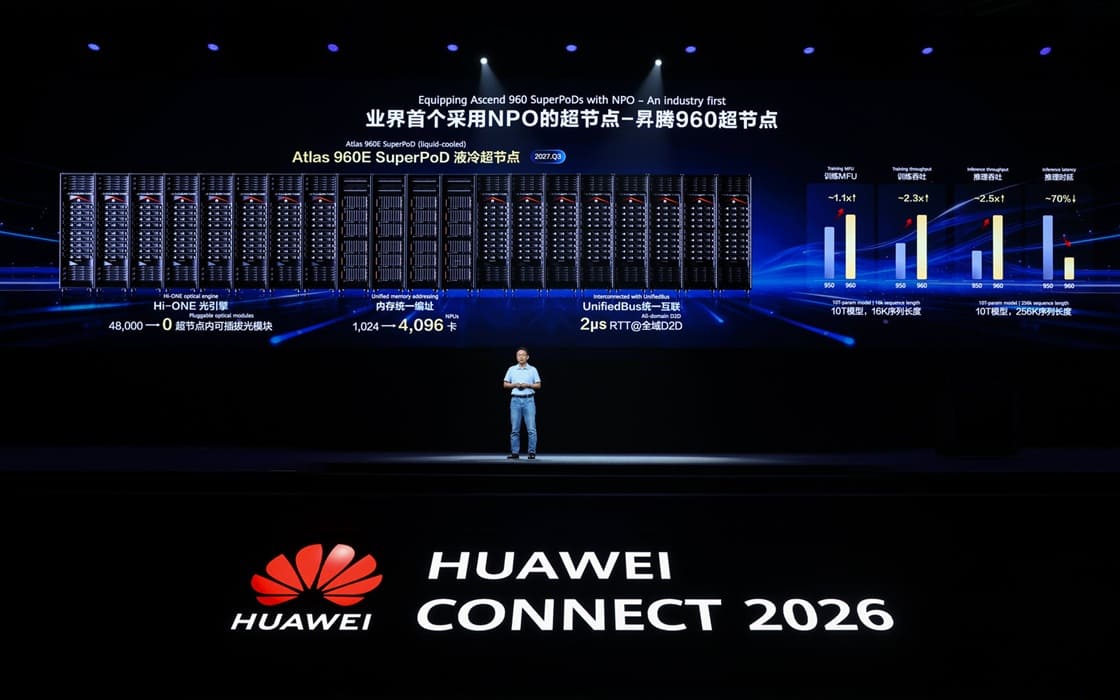
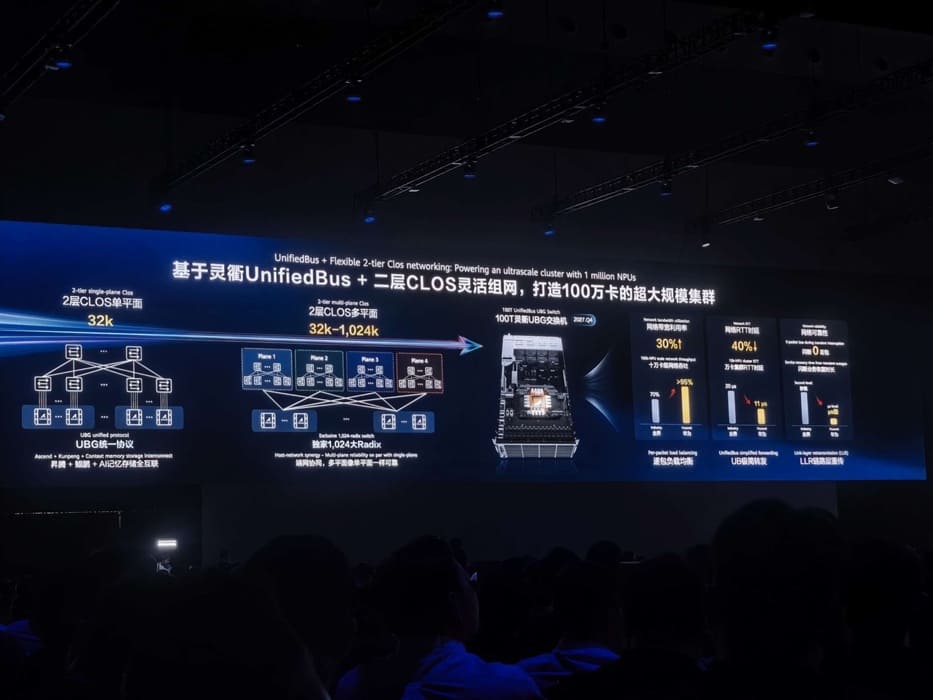
La otra gran pieza de la hoja de ruta es el Atlas 960E SuperPoD, previsto para el tercer trimestre de 2027 con refrigeración líquida. Un único sistema podrá integrar 4.096 NPU mediante direccionamiento unificado de memoria y alcanzar 8 EFLOPS FP8 o 16 EFLOPS FP4.
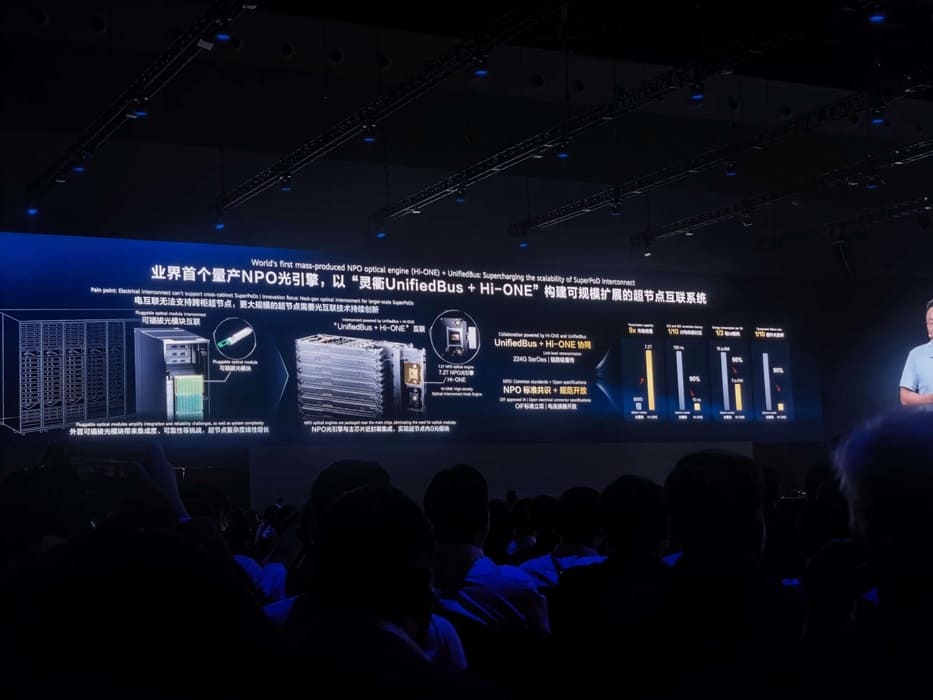
Huawei estrenará además óptica NPO mediante su motor Hi-ONE. Cada motor óptico alcanza 7,2 Tbit/s y acerca las comunicaciones ópticas al encapsulado, reduciendo la dependencia de grandes cantidades de módulos ópticos enchufables convencionales.
El sistema empleará aproximadamente 5.500 módulos Hi-ONE en lugar de decenas de miles de transceptores 800G, una reorganización que, según Huawei, permitirá ahorrar más de 550 kW. La compañía también anuncia una disponibilidad del 99,8%.
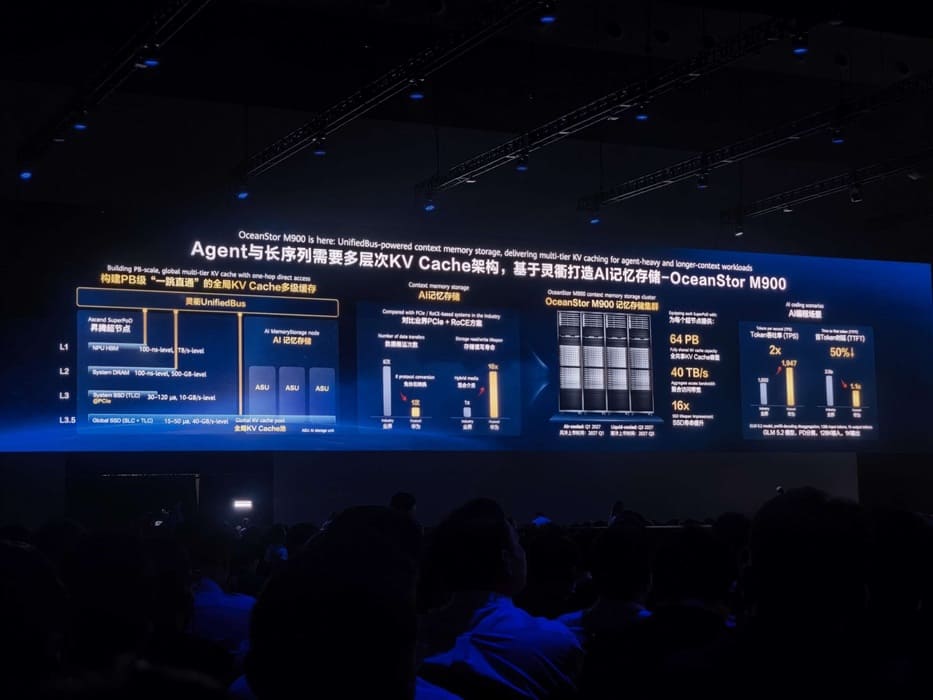
La memoria alcanza otra escala completamente distinta. Un Atlas 960E podrá integrar alrededor de 1 PB de HBM, mientras el direccionamiento unificado pretende permitir que miles de NPU compartan recursos de forma mucho más estrecha que en una agrupación convencional de servidores independientes.
UnifiedBus será precisamente la pieza encargada de conectar ese conjunto. Huawei anuncia una latencia RTT de aproximadamente 2 microsegundos en comunicaciones D2D, buscando que el crecimiento en número de aceleradores no quede neutralizado por tiempos excesivos de intercambio de datos.
Huawei afirma hasta 2,5 veces más rendimiento en inferencia
Fuente de la imagen: 拖拉机 @tuolaji2024 – X
Frente al Atlas 950, Huawei asegura que el Atlas 960E ofrecerá hasta 2,3 veces más rendimiento de entrenamiento con un modelo de 10 billones de parámetros y secuencias de 16K. Son cifras propias de la compañía para una carga concreta, no una mejora universal aplicable a cualquier modelo.
En inferencia, utilizando el mismo tamaño de modelo pero un contexto de 256K, Huawei eleva la mejora hasta 2,5 veces y habla de una reducción cercana al 70% en la latencia. El salto muestra cuánto pretende ganar la compañía mediante memoria e interconexión, además de aumentar la potencia individual de cada NPU.
OceanStor M900 amplía el KV Cache desde la memoria hasta los SSD
Fuente de la imagen: 拖拉机 @tuolaji2024 – X
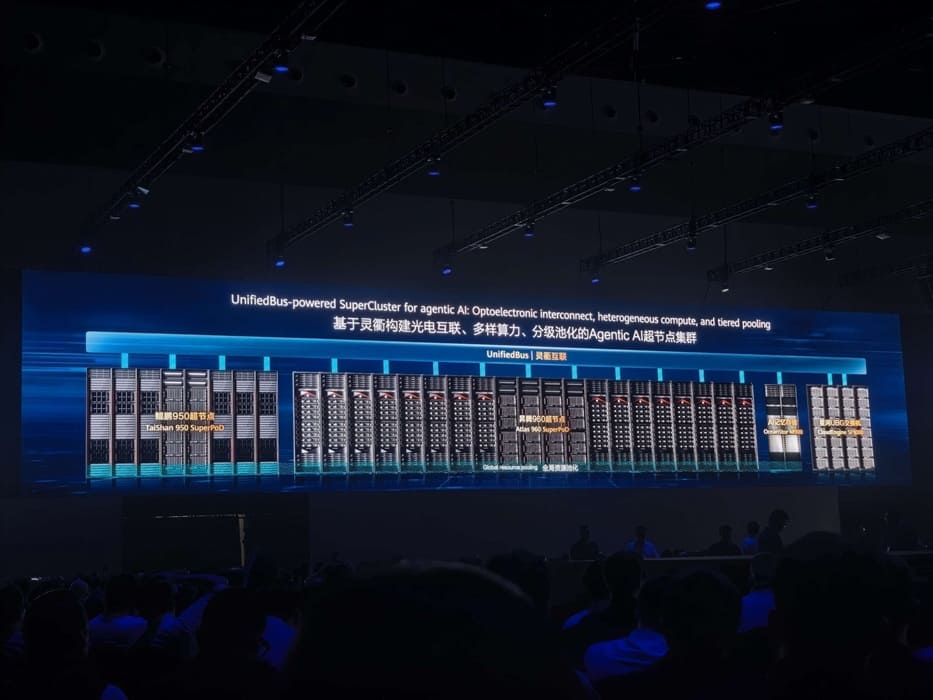
Huawei también ha presentado OceanStor M900, una plataforma capaz de ampliar el KV Cache desde HBM y memoria principal hacia almacenamiento SSD. La idea es conservar mucha más información generada durante la inferencia sin dedicar cantidades prohibitivas de memoria de alta velocidad exclusivamente a esta función.
Un único clúster podrá proporcionar hasta 64 PB de capacidad y 40 TB/s de ancho de banda agregado. La arquitectura permite además acceso directo desde las NPU hacia los SSD, evitando conversiones de protocolo y el paso intermedio por la CPU.
Según las cifras oficiales, la latencia de acceso puede reducirse desde milisegundos hasta aproximadamente 60 microsegundos, un descenso cercano al 90%. Huawei asegura además que la capacidad útil de KV Cache disponible por NPU puede pasar de escalas de gigabytes a terabytes.
La ventaja potencial aumenta cuanto mayores son las ventanas de contexto. Reutilizar claves y valores ya calculados evita repetir trabajo durante la inferencia, de manera que ampliar el KV Cache puede mejorar el aprovechamiento de las NPU, aunque los SSD continúen siendo mucho más lentos que la HBM.
Huawei quiere escalar el sistema completo, no únicamente el chip
Fuente de la imagen: 拖拉机 @tuolaji2024 – X
La hoja de ruta muestra un ciclo anual entre Ascend 960, 970 y 980, pero la evolución más agresiva aparece precisamente en memoria, interconexión y escala del sistema. Los PFLOPS crecen rápidamente, aunque Huawei intenta que el movimiento de datos avance al mismo ritmo.
Ese planteamiento responde a un límite fundamental de los grandes clústeres de IA: duplicar la capacidad de cálculo de una NPU no sirve de mucho si permanece esperando memoria o datos procedentes de otros aceleradores. Cuantas más unidades se conectan, más importante resulta controlar esos tiempos muertos.
El Atlas 960E resume por ello la estrategia mejor que cualquier chip aislado. Huawei pretende combinar 4.096 NPU, alrededor de 1 PB de HBM, óptica NPO y UnifiedBus dentro de un único sistema, apostando por escalar toda la infraestructura en lugar de depender únicamente de acelerar cada nuevo die.
Vía: Wccftech