Vulsar AI ha publicado la primera versión de su benchmark de escritura creativa, enfrentando 24 modelos de lenguaje y escritores humanos a través de 475 prompts. GPT-6 Astra ocupa la primera posición general con un 87,8% de predicted win rate, ligeramente por encima del 86,6% obtenido por el grupo de escritores aficionados utilizado como referencia. Los responsables recalcan que los escritores profesionales continúan claramente por delante.
El resultado necesita una precisión importante: ese 87,8% no significa que Astra escriba mejor que un humano el 87,8% de las veces. Vulsar utiliza un modelo de recompensa entrenado específicamente con preferencias humanas para estimar qué textos tendería a preferir un grupo amplio de lectores. La propia organización advierte de que la escritura creativa es subjetiva y que el ranking no pretende anticipar las preferencias de cada lector individual.
GPT-6 Astra alcanza un 87,8% frente al 86,6% de los escritores aficionados
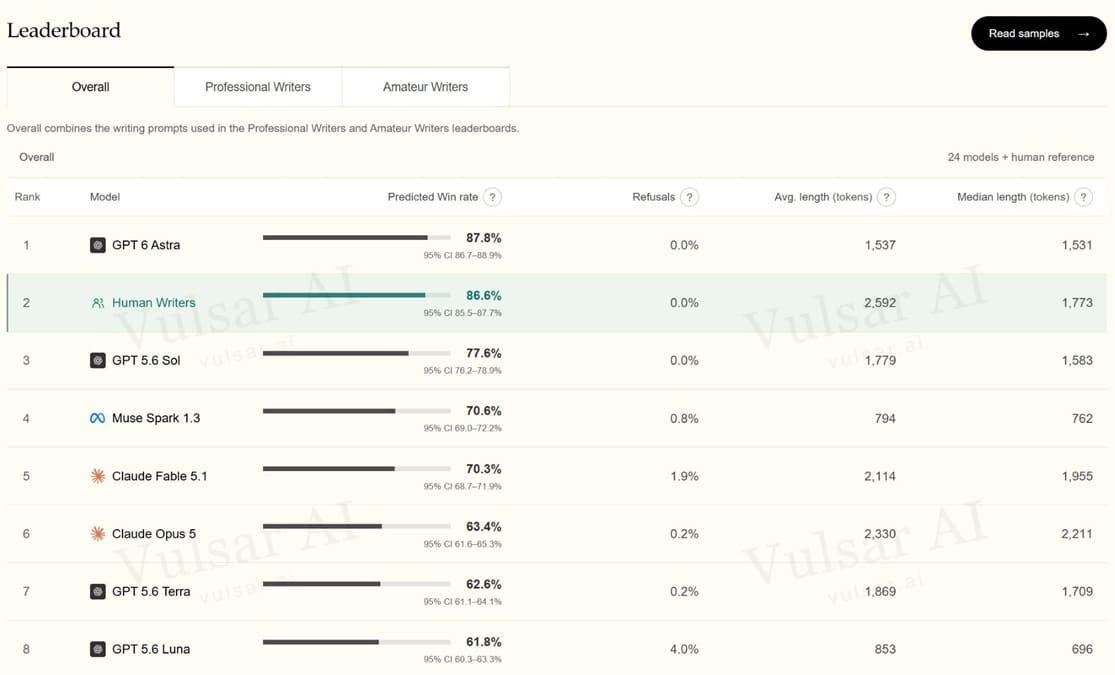
Dentro de la clasificación general, GPT-6 Astra obtiene un 87,8% de predicted win rate, frente al 86,6% del conjunto de escritores humanos aficionados. La diferencia es de solo 1,2 puntos porcentuales, por lo que el resultado resulta mucho más interesante como señal de proximidad que como una supuesta superioridad aplastante de la IA.
Por detrás aparece GPT-5.6 Sol con un 77,6%, mientras Claude Fable 5.1 alcanza un 70,3%. El descenso muestra que el rendimiento observado no se extiende por igual a todos los modelos avanzados: solo la parte más alta del benchmark consigue acercarse o superar la referencia amateur.
Esta diferencia también evita una conclusión demasiado amplia sobre “la IA frente a los escritores”. Vulsar separa deliberadamente a los participantes por nivel y señala que los escritores profesionales mantienen una ventaja amplia cuando se evalúan de forma independiente. El benchmark mide, por tanto, hasta dónde han llegado determinados modelos frontera, no que la escritura profesional haya quedado superada.
Fuente de la imagen: Vulsar
El benchmark utiliza preferencias predichas, no una nota objetiva de calidad literaria
Vulsar utiliza un reward model personalizado entrenado con datos de preferencias humanas sobre escritura creativa. En lugar de asignar simplemente una nota sobre gramática, vocabulario o cumplimiento de instrucciones, intenta predecir qué respuesta preferiría un conjunto de lectores al comparar diferentes textos.
Eso tiene una ventaja clara: la escritura creativa no puede reducirse fácilmente a respuestas correctas o incorrectas como ocurre en matemáticas o programación. Ritmo, voz, atmósfera, estructura o impacto emocional son propiedades donde una comparación de preferencias puede resultar más informativa que comprobar coincidencias con una solución concreta.
Pero también introduce una limitación importante. El benchmark mide la capacidad de convencer al modelo de recompensa, aunque este haya sido entrenado con elecciones humanas. Si ese evaluador desarrolla preferencias sistemáticas por determinada estructura, longitud o estilo, los modelos capaces de reproducirlas pueden obtener mejores resultados sin ser necesariamente superiores para todos los géneros o lectores.
Este punto ya ha generado discusión entre usuarios de LocalLLaMA, donde algunos plantean complementar las comparaciones A/B con medidas estructurales de diversidad temática, repetición y comportamiento estilístico. Es una crítica pertinente porque un único ranking comprime muchas propiedades diferentes de la escritura en una sola cifra.
Fuente de la imagen: Vulsar
Los modelos más pequeños se desploman en generación creativa larga
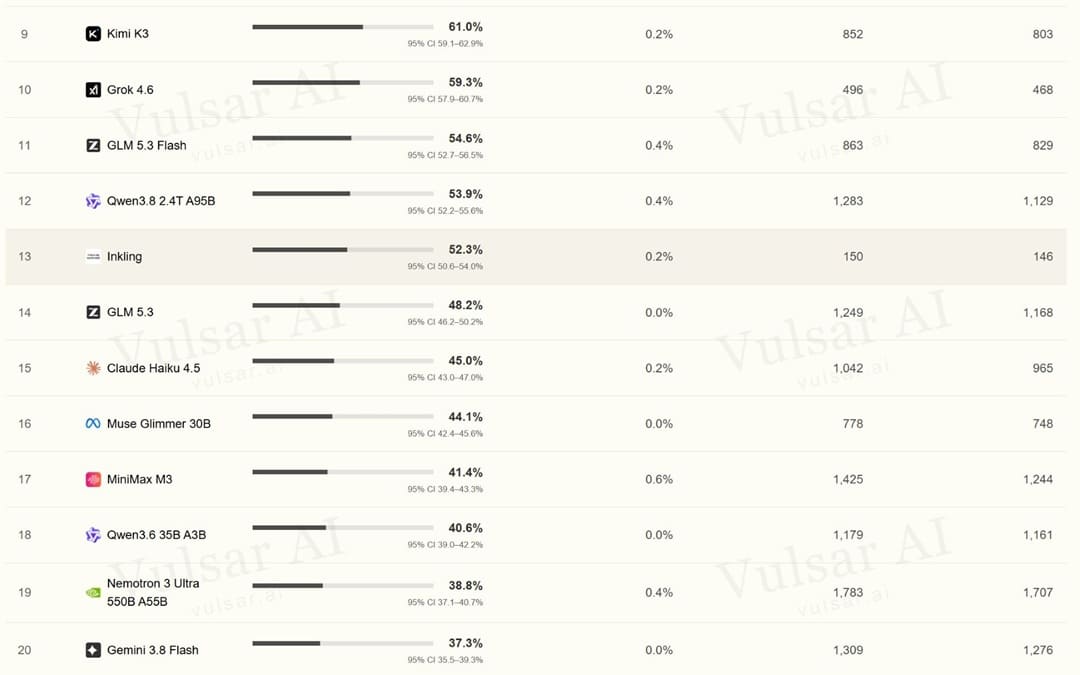
La distancia crece rápidamente al abandonar los modelos frontera. Claude Opus 5, Kimi K3 y Grok 4.6 quedan aproximadamente dentro de la franja del 50-65%, mientras varios modelos más compactos caen muy por debajo.
Qwen3.8-27B obtiene un 23,2%, DeepSeek V4.1 Flash alcanza un 19,8% y Gemma 4 26B A4B termina en el 10,9%. La diferencia resulta especialmente interesante porque algunos de estos modelos pueden ofrecer resultados muy sólidos en razonamiento o tareas técnicas, pero ese rendimiento no se traslada automáticamente a escritura creativa extensa.
La comunidad ha señalado precisamente problemas de pérdida de coherencia, reiteración de expresiones y degradación de la narrativa conforme aumenta la longitud. Mantener personajes, tono, causalidad y evolución narrativa durante varios capítulos exige algo diferente a producir una escena convincente de unos cientos de palabras.
Por eso el benchmark aporta una dimensión que muchas pruebas convencionales no capturan: un modelo puede resolver problemas complejos y aun así mostrar dificultades para sostener una voz narrativa durante miles de tokens. Rendimiento lógico y calidad literaria no avanzan necesariamente al mismo ritmo.
Los humanos escribieron bastante más texto por prompt
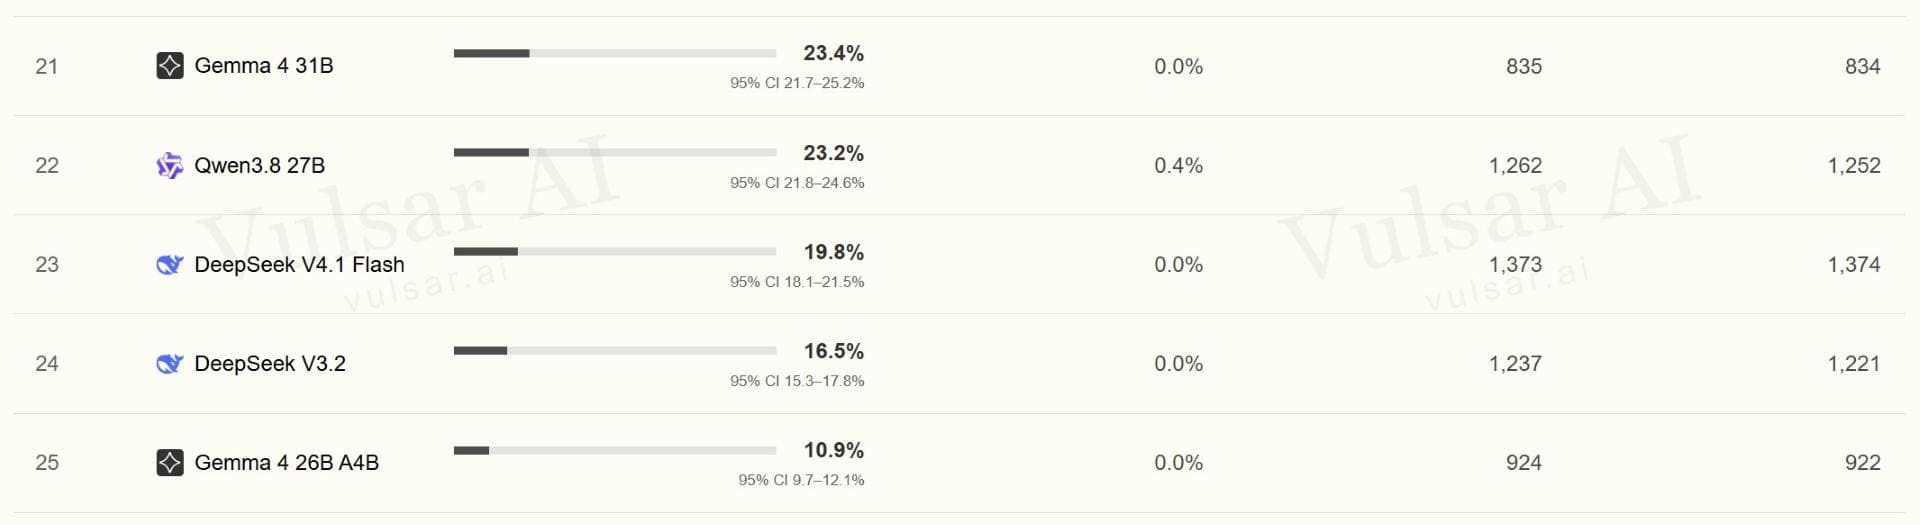
Los participantes humanos produjeron de media 2.592 tokens por prompt, frente a 1.537 tokens de GPT-6 Astra. Claude Fable 5.1 alcanzó 2.114 tokens, acercándose más al volumen generado por los escritores.
La longitud por sí sola no equivale a mayor calidad, pero resulta relevante en un benchmark de generación extensa. Mantener estructura y coherencia durante 2.500 tokens implica gestionar más personajes, detalles y dependencias narrativas que hacerlo durante aproximadamente 1.500.
También introduce un posible factor de comparación. Un texto más largo tiene más oportunidades de cometer errores, repetirse o perder ritmo, mientras una respuesta más corta puede concentrar las partes más efectivas. Por ello, el número de tokens debería analizarse junto al predicted win rate y no como una estadística independiente.
Fuente de la imagen: Vulsar
El resultado no demuestra que GPT-6 Astra pueda sustituir a un escritor profesional
La propia presentación de Vulsar es mucho más limitada: los mejores modelos frontera ya pueden superar al grupo de escritores aficionados utilizado en esta prueba, mientras el grupo profesional continúa liderando claramente.
Tampoco se están midiendo muchas tareas esenciales del trabajo profesional, como reescribir tras una devolución editorial, mantener una novela completa durante decenas de capítulos, investigar hechos, negociar cambios de tono o tomar decisiones creativas durante semanas o meses. El benchmark analiza outputs generados a partir de 475 prompts, no todo el proceso de escribir y revisar una obra.
GPT-6 Astra sí representa el modelo más reciente de OpenAI y la compañía lo posiciona con mejoras amplias en seguimiento de instrucciones, trabajo profesional y generación de documentos, por lo que su posición elevada en una prueba específica de escritura resulta coherente con ese avance general, aunque Vulsar sea una evaluación independiente y distinta de los benchmarks publicados por OpenAI.
El dato más interesante no es, por tanto, que “la IA ya escriba mejor que los humanos”, sino que un modelo frontera ha alcanzado el nivel de preferencia predicha de escritores aficionados talentosos mientras permanece una brecha clara frente a profesionales. Además, la fuerte caída observada entre Astra y modelos más pequeños indica que, por ahora, la escritura creativa larga sigue separando bastante a la primera línea de modelos del resto del mercado.
Vía: Wccftech