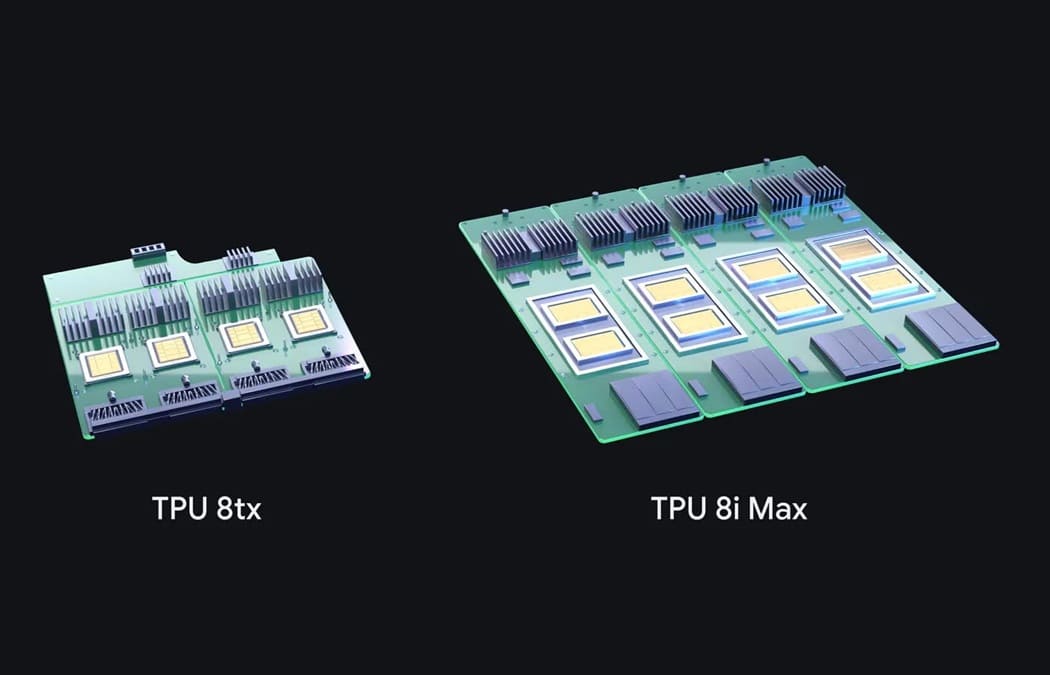
Google ha ampliado su catálogo de aceleradores para inteligencia artificial con TPU 8tx y TPU 8i Max, dos nuevas configuraciones de sistemas basadas en su arquitectura de octava generación. La primera está orientada al procesamiento seguro de información confidencial, mientras que la segunda combina dos chips en un mismo encapsulado para aumentar la capacidad de cálculo y el ancho de banda de memoria.
Ambas propuestas complementan las TPU 8t y TPU 8i, presentadas anteriormente para el entrenamiento de modelos y las tareas de inferencia. A diferencia de una nueva generación de procesadores, Google reutiliza diseños de silicio existentes y modifica su integración, conectividad y capacidades, una estrategia que permite adaptar la infraestructura a distintas necesidades sin desarrollar un chip completamente nuevo.
TPU 8tx combina procesadores AMD EPYC con computación confidencial
La TPU 8tx utiliza el mismo silicio que TPU 8t, pero incorpora una configuración específica para ejecutar modelos de inteligencia artificial con información sensible. Está dirigida principalmente a empresas reguladas, administraciones públicas y organizaciones que necesitan proteger tanto sus datos como los parámetros de sus modelos durante el procesamiento.
Para conseguirlo, Google combina sus aceleradores con procesadores AMD EPYC de quinta generación, que actúan como CPU anfitrionas del sistema. La arquitectura aprovecha mecanismos de seguridad implementados mediante hardware, incluidas las capacidades AMD Secure Encrypted Virtualization (SEV), para extender la protección de información al entorno de computación acelerada.
La diferencia respecto al cifrado convencional reside en proteger los datos también mientras se utilizan para realizar cálculos. Normalmente, la información puede mantenerse cifrada durante su almacenamiento y transmisión, pero necesita procesarse dentro de un entorno de ejecución. La computación confidencial busca reducir la exposición de esos datos incluso durante esa fase.
Google también ha incorporado la interconexión Boardfly, desarrollada para TPU 8i, con el objetivo de reducir las demoras de comunicación entre aceleradores. Según sus estimaciones, TPU 8tx consigue hasta el doble de reducción de latencia respecto a TPU 8t, manteniendo una penalización de rendimiento prácticamente nula por las funciones adicionales de seguridad.
La compañía no ha publicado suficientes resultados independientes para determinar cómo se comporta esa mejora en diferentes modelos. Además de la inferencia, el sistema admite ajuste fino con información privada, destilación de modelos y aprendizaje por refuerzo, permitiendo combinar distintas operaciones sin trasladar necesariamente los datos entre clústeres separados.
TPU 8i Max duplica la capacidad de cálculo y el ancho de banda HBM
La segunda incorporación, TPU 8i Max, aborda una limitación diferente: la cantidad de información que los aceleradores pueden procesar y transferir simultáneamente. Su diseño integra dos chips TPU 8i dentro de un único encapsulado, manteniendo la arquitectura original y ampliando los recursos disponibles.
Según Google, esta configuración proporciona el doble de capacidad de cálculo, el doble de memoria SRAM y el doble de ancho de banda HBM respecto a una TPU 8i individual. Se trata de incrementos en recursos de hardware, que no implican necesariamente duplicar el rendimiento efectivo de cualquier aplicación.
La ampliación está pensada para modelos que trabajan con ventanas de contexto de millones de tokens, como sistemas capaces de analizar grandes repositorios de código, documentos extensos o secuencias prolongadas de vídeo. En estas situaciones, el movimiento de información entre memoria y procesadores puede limitar el aprovechamiento de la capacidad de cálculo.
Al integrar dos chips en un mismo encapsulado, Google también pretende aumentar la densidad de computación por rack, aprovechando el espacio existente en sus centros de datos. No obstante, la compañía no ha publicado comparativas independientes sobre consumo energético, escalabilidad o rendimiento por vatio para las nuevas configuraciones.
TorchTPU, TPU Sync y nuevas herramientas para reducir las limitaciones del software
La ampliación de hardware llega acompañada de herramientas destinadas a facilitar el uso de estos aceleradores. Google ha liberado el código de TorchTPU, una iniciativa que permite ejecutar aplicaciones PyTorch y modelos de Hugging Face directamente sobre sus TPU, junto con soporte para motores de inferencia como vLLM y SGLang.
También ha presentado TPU Sync, una capa de gestión que coordina la memoria HBM de los aceleradores, la DRAM de los servidores, el almacenamiento compartido y la red. Su objetivo es trasladar información entre distintos niveles de memoria para evitar que las cargas de trabajo con contextos extensos dependan exclusivamente de la capacidad disponible en cada chip.
Google asegura que determinadas operaciones de transferencia de caché KV pueden experimentar reducciones superiores al 90% en la latencia y el tiempo hasta el primer token, aunque estos resultados corresponden a las condiciones evaluadas por la compañía. No deben interpretarse como una mejora general aplicable a todos los modelos de inteligencia artificial.
Otra incorporación es Agent Compute Engine, un sistema que suspende sesiones de agentes de IA cuando permanecen inactivas y desplaza temporalmente su estado fuera del acelerador. Esta función busca reducir la capacidad de cálculo desaprovechada mientras los agentes esperan respuestas de herramientas externas, bases de datos o usuarios.
Por último, Google amplía sus herramientas de gestión distribuida mediante Cloud Pathways y GKE Dynamic Slicing. La primera permite coordinar sistemas TPU distribuidos desde un controlador, mientras que la segunda utiliza conmutación óptica para modificar dinámicamente la distribución de los recursos entre diferentes cargas de trabajo.
Google apuesta por configuraciones especializadas frente a nuevos chips
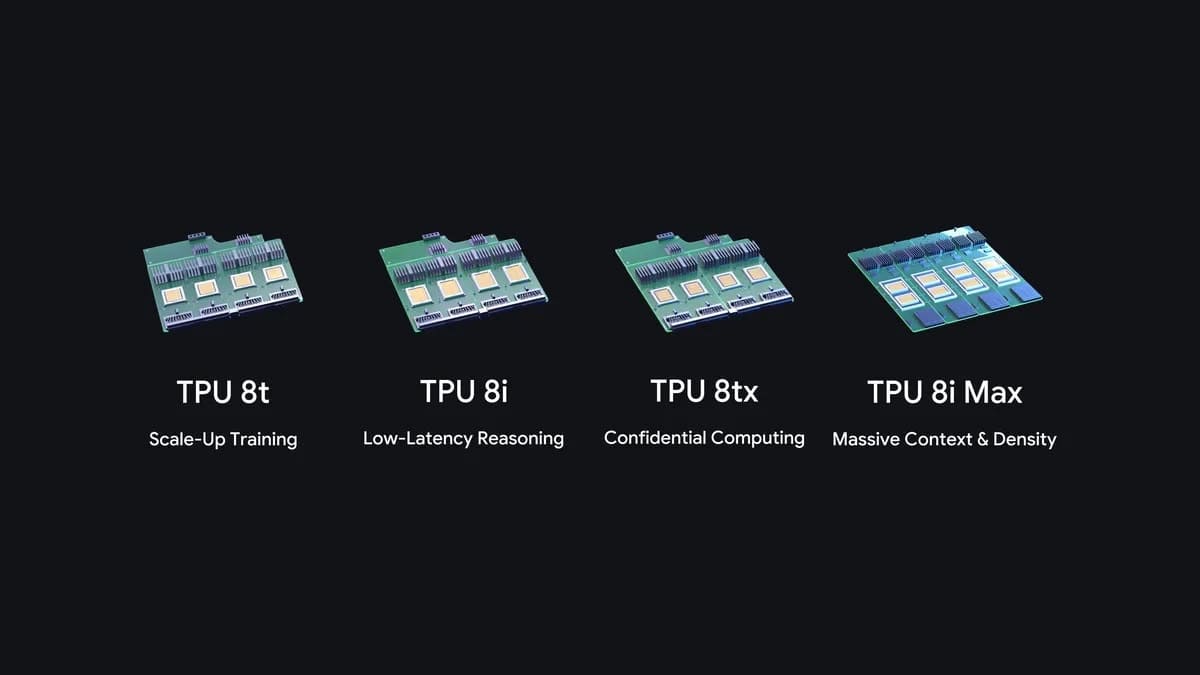
Las cuatro configuraciones de octava generación responden a necesidades diferenciadas: TPU 8t para entrenamiento, TPU 8i para razonamiento de baja latencia, TPU 8tx para computación confidencial y TPU 8i Max para contextos extensos y mayor densidad de cálculo.
Este enfoque permite utilizar una base tecnológica común con modificaciones en el encapsulado, las conexiones y el software. Sin embargo, Google todavía no ha detallado precios ni un calendario comercial específico para las nuevas configuraciones, aspectos necesarios para valorar su competitividad frente a otros aceleradores utilizados en centros de datos.
La principal novedad de TPU 8tx y TPU 8i Max no reside en introducir una arquitectura completamente nueva, sino en adaptar los recursos existentes a dos limitaciones concretas de la inteligencia artificial: la seguridad de los datos durante su procesamiento y el acceso a grandes volúmenes de memoria. Su impacto real dependerá del rendimiento que consigan ofrecer en cargas de trabajo empresariales y de su coste de implementación.
Vía: TechPowerUp