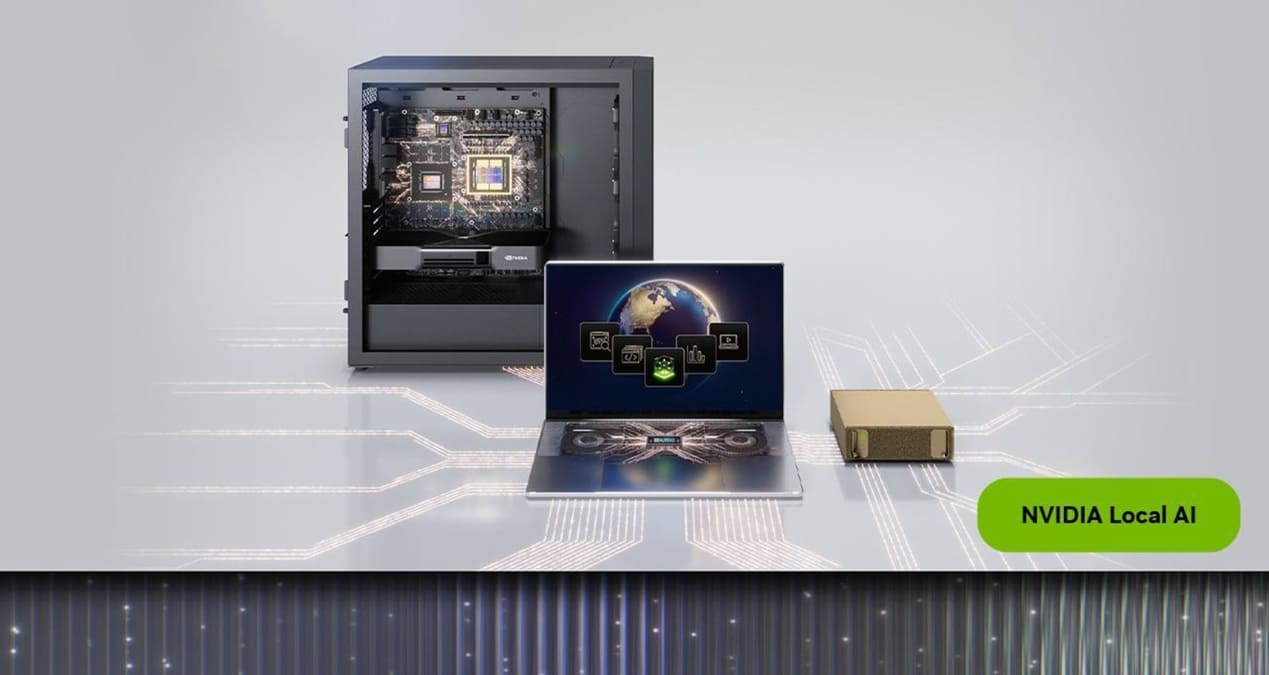
NVIDIA ha anunciado durante GTC Berlín 2026 una actualización de sus plataformas de inteligencia artificial local que permite agrupar hasta ocho sistemas DGX Spark en un mismo clúster, duplicando el límite anterior de cuatro equipos. Esta configuración alcanza una capacidad conjunta de hasta 1 TB de memoria unificada, destinada a ejecutar modelos de mayor tamaño y distribuir cargas de trabajo entre varios dispositivos.
La compañía también ha presentado optimizaciones de inferencia para DGX Spark, DGX Station y RTX PRO 6000 Blackwell, con mejoras de rendimiento de entre el 20% y el 40% en determinados modelos de IA. Los anuncios incluyen la llegada de DGX Spark con 64 GB el 23 de octubre, nuevas herramientas de gestión y compatibilidad con modelos de lenguaje preparados para ejecutarse localmente.
DGX Spark admite clústeres de ocho equipos con hasta 1 TB de memoria
La principal novedad es la posibilidad de conectar hasta ocho unidades DGX Spark mediante NVIDIA ConnectX-7, utilizando las herramientas de configuración de clústeres de la compañía. Anteriormente, el soporte estaba limitado a cuatro sistemas, por lo que esta actualización duplica el número de equipos que pueden trabajar conjuntamente.
La capacidad de memoria depende de las configuraciones utilizadas. Ocho DGX Spark de 64 GB suman 512 GB, mientras que una agrupación de ocho unidades de 128 GB alcanza 1.024 GB, equivalentes aproximadamente a 1 TB. Estas cifras representan la memoria total instalada en los equipos, no una ampliación física de la memoria individual de cada dispositivo.
Para aprovechar esta capacidad, los modelos y las aplicaciones deben admitir ejecución distribuida entre varios sistemas. El intercambio de información también introduce dependencias del rendimiento de la red, por lo que un clúster de ocho equipos no proporciona automáticamente ocho veces el rendimiento de una unidad.
NVIDIA plantea esta configuración para modelos de lenguaje de gran tamaño, contextos extensos y múltiples agentes trabajando simultáneamente. Entre los ejemplos menciona GLM 5.3, un modelo cuyas necesidades de memoria pueden superar la capacidad de una única estación compacta.
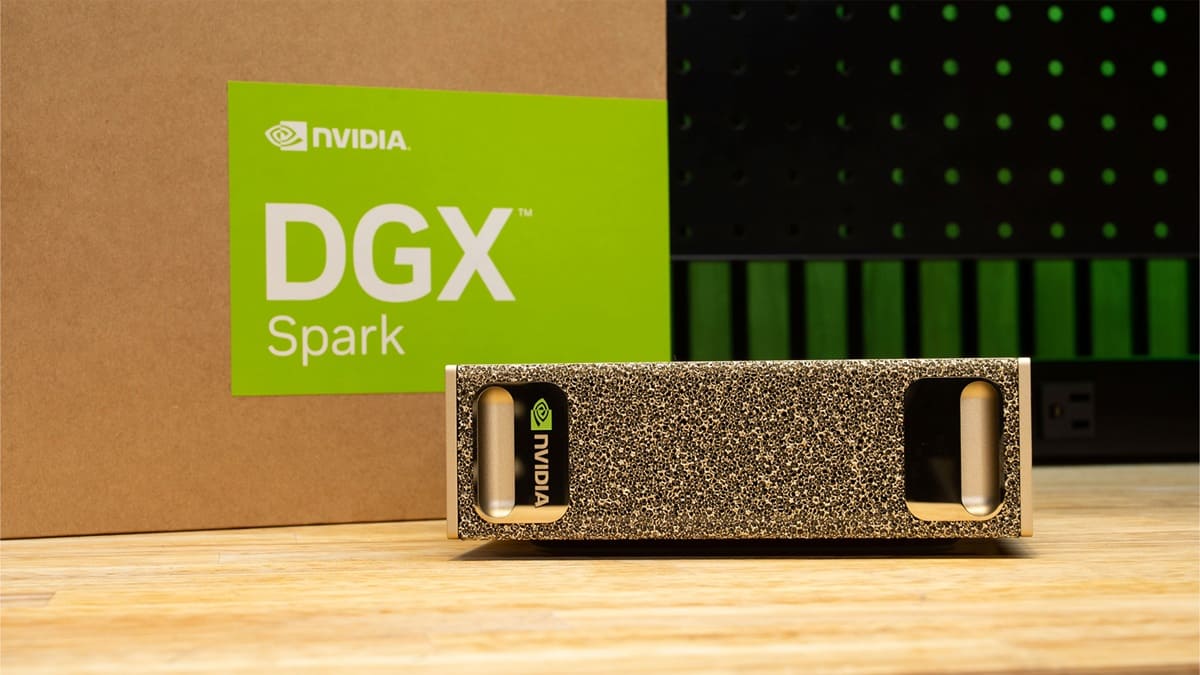
DGX Spark de 64 GB llegará el 23 de octubre y NVIDIA Sync facilitará los clústeres
La compañía ha confirmado que las primeras configuraciones DGX Spark de 64 GB comenzarán a distribuirse el viernes 23 de octubre mediante fabricantes como Acer, Dell, GIGABYTE, HP y MSI. Esta variante amplía las opciones disponibles frente a los sistemas de 128 GB, aunque ofrece menos margen para ejecutar modelos especialmente exigentes.
Entre los modelos compatibles se encuentran Nemotron 3.5 Bolt 74B en su versión de 24 GB, Qwen3.8 27B y Gemma 4 26B-A4B. Su funcionamiento dependerá del formato de cuantización utilizado y de la memoria adicional necesaria para gestionar el contexto, las cachés y las aplicaciones.
Por ahora, los clústeres de ocho DGX Spark requieren configuración manual. NVIDIA ha anunciado que NVIDIA Sync incorporará soporte simplificado para ocho equipos antes de terminar octubre, junto con una nueva herramienta denominada Model Launcher.
Esta aplicación permitirá descargar modelos y contenedores adaptados al hardware disponible, además de conectarlos con el entorno de desarrollo OpenCode. La actualización de octubre también incorpora Wi-Fi Assistant para modificar conexiones inalámbricas en modo dispositivo y nuevas funciones de asistencia para mantenimiento y resolución de problemas.
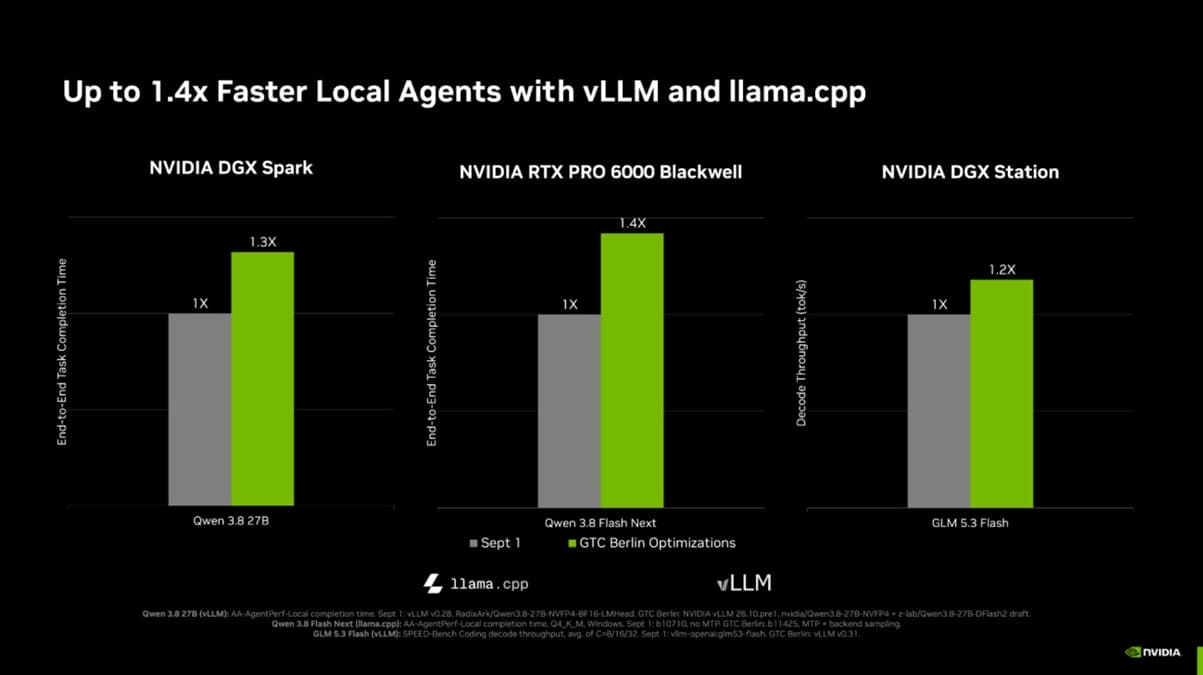
NVIDIA mejora hasta un 40% la inferencia con vLLM y llama.cpp
Además de ampliar la capacidad de memoria, NVIDIA ha trabajado con las comunidades de código abierto de vLLM y llama.cpp para mejorar la ejecución local de modelos de lenguaje. Las optimizaciones afectan principalmente a la decodificación especulativa y al procesamiento inicial de los datos, conocido como prefill.
Las mejoras anunciadas varían según el hardware, el modelo utilizado y el motor de inferencia:
| Plataforma | Modelo de IA | Mejora anunciada |
|---|---|---|
| DGX Spark | Qwen3.8 27B | Hasta 30% |
| DGX Station | GLM 5.3 Flash | Hasta 20% |
| RTX PRO 6000 Blackwell | Qwen3.8 Flash Next | Hasta 40% |
Resultados comunicados por NVIDIA para cargas de trabajo concretas. No representan mejoras generales para todos los modelos.
En DGX Spark, las optimizaciones de vLLM combinan una decodificación especulativa más rápida con nuevos kernels FlashInfer para la atención lineal de Qwen. Por su parte, RTX PRO 6000 Blackwell utiliza mejoras de llama.cpp relacionadas con la predicción de varios tokens, reduciendo el trabajo necesario en determinadas operaciones.
Estas técnicas pueden acelerar la generación de respuestas sin modificar necesariamente los pesos del modelo, aunque el resultado depende de la longitud del contexto, las peticiones procesadas y la configuración de ejecución. Por tanto, las cifras publicadas no deben interpretarse como incrementos garantizados en cualquier aplicación de IA.
Recursive Flint y nuevos modelos cuantizados para ejecutar IA local
NVIDIA también ha anunciado la disponibilidad de Recursive Flint, un modelo de programación desarrollado por Recursive Superintelligence. Utiliza una arquitectura Mixture of Experts (MoE) con 40.000 millones de parámetros totales, de los cuales 2.500 millones permanecen activos por token.
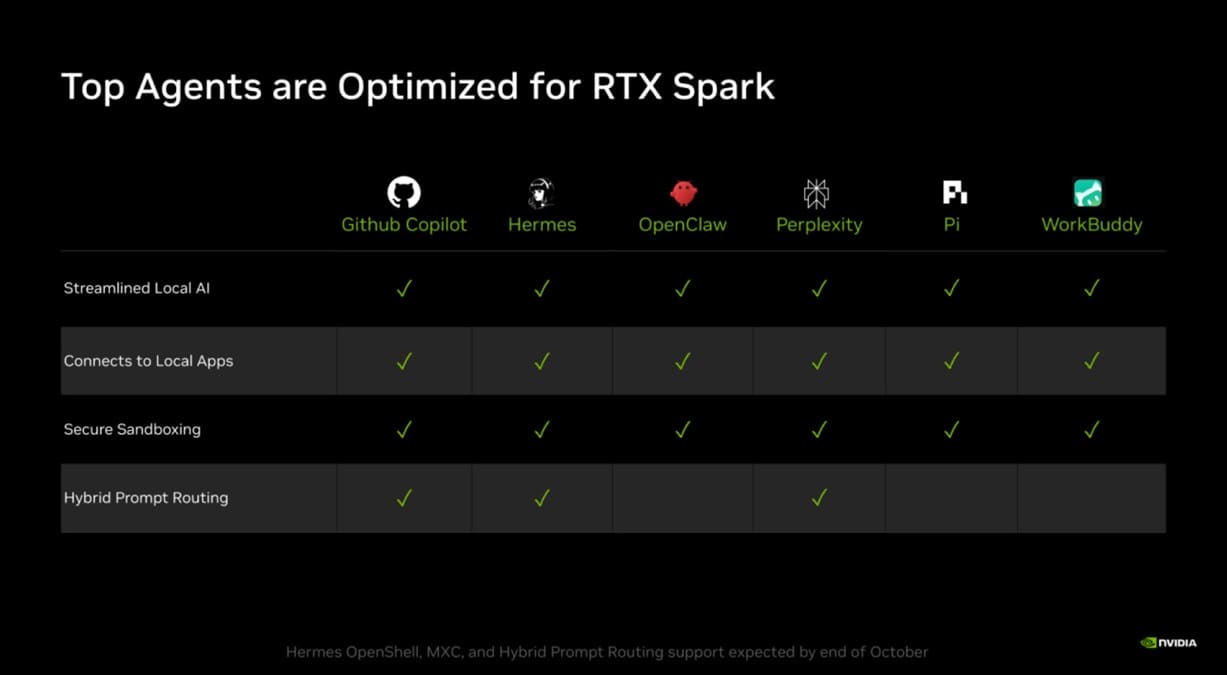
El modelo está optimizado para tareas de programación mediante agentes y puede ejecutarse en RTX Spark, DGX Spark y tarjetas GeForce RTX y RTX PRO compatibles. Sus pesos se distribuyen bajo licencia Apache 2.0, lo que permite a los desarrolladores utilizarlo y adaptarlo a diferentes proyectos.
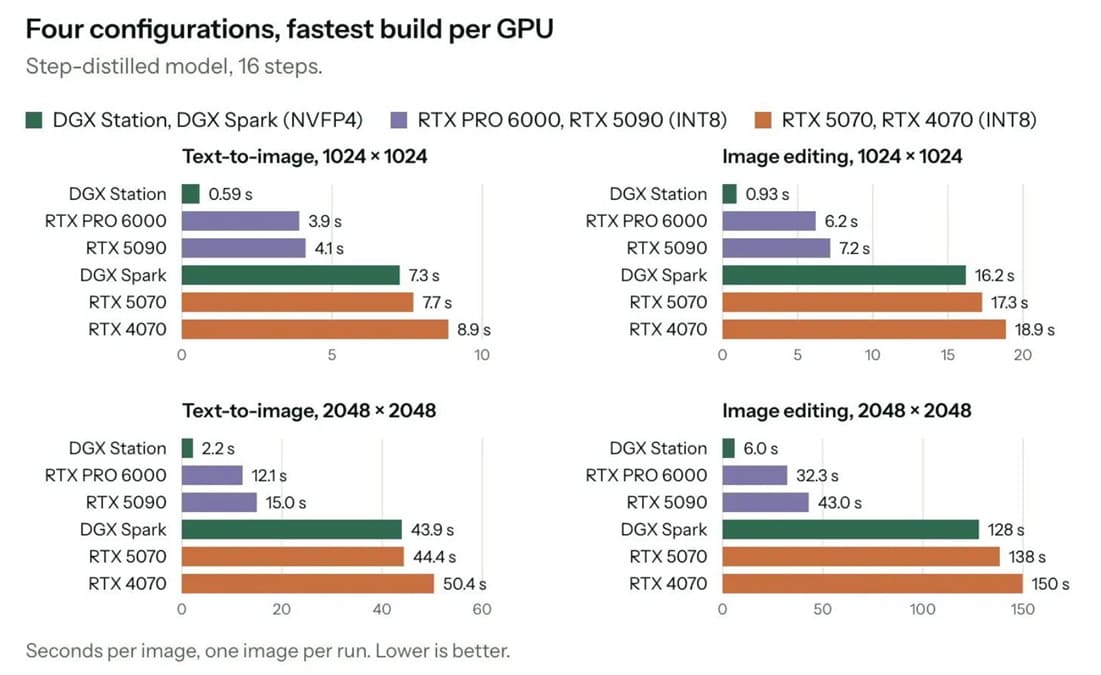
Otra novedad es la publicación de checkpoints cuantizados en FP4 para reducir el consumo de memoria durante la inferencia. Entre ellos aparecen Qwen3.8-Flash-Next-FP4-Local, preparado para un DGX Spark de 128 GB o una RTX PRO 6000, y GLM-5.3-Flash-FP4-Local, destinado a configuraciones de dos sistemas.
La cuantización permite almacenar los parámetros utilizando menos bits, liberando espacio para la caché KV y los contextos de mayor longitud. Sin embargo, puede introducir diferencias de precisión frente a los modelos originales, por lo que el fabricante deberá demostrar el equilibrio entre consumo de memoria y calidad de las respuestas.
DGX Station para Windows llegará en diciembre con nuevas herramientas empresariales
La actualización también afecta a DGX Station, que dispone de 748 GB de memoria coherente y hasta 20 petaflops de potencia de cálculo para IA, según NVIDIA. La compañía ha anunciado nuevas integraciones de administración con herramientas como Microsoft Intune, Splunk, Puppet y Tanium.
Además, DGX Station para Windows comenzará a distribuirse en diciembre de 2026, con soporte para aplicaciones profesionales de diseño, simulación e ingeniería. NVIDIA también prepara funciones para compartir modelos locales entre diferentes usuarios y tres flujos de trabajo de código abierto destinados a robótica.
Con estos anuncios, DGX Spark amplía su capacidad de ejecución distribuida hasta ocho equipos, mientras que las mejoras de vLLM y llama.cpp buscan aprovechar mejor el hardware existente. El incremento máximo del 40% corresponde específicamente a RTX PRO 6000 Blackwell, y su repercusión en otras configuraciones dependerá de los modelos utilizados y de futuras pruebas independientes.
Vía: Wccftech