Los próximos aceleradores NVIDIA Rubin utilizarían mayoritariamente memoria HBM4 de 12 capas (12-Hi), a pesar de las informaciones que apuntaban a un mayor interés del fabricante por configuraciones de 8 capas. La decisión permitiría mantener las especificaciones anunciadas para esta arquitectura, que contempla hasta 288 GB de memoria HBM4 y un ancho de banda de 22 TB/s por GPU.
La información procede de DIGITIMES, que recoge las conclusiones de Counterpoint Research sobre los planes de NVIDIA y sus proveedores. Mientras tanto, la escasez de memoria amenaza con encarecer todavía más los aceleradores de inteligencia artificial. TrendForce prevé que el precio medio combinado de HBM aumente un 121% interanual en 2027, impulsado por las restricciones de suministro y la llegada de productos más avanzados.
NVIDIA Rubin seguiría apostando por HBM4 de 12 capas
Según Counterpoint Research, la mayoría de los aceleradores basados en Rubin conservarán las configuraciones HBM4 de 12 capas previstas originalmente. Esta conclusión contrasta con las informaciones anteriores que apuntaban a un posible cambio hacia módulos de 8 capas para reducir las dificultades de fabricación y mejorar la disponibilidad de memoria.
La decisión tendría sentido desde el punto de vista técnico. Los modelos de inteligencia artificial más exigentes necesitan combinar una elevada capacidad con un gran ancho de banda, especialmente cuando deben manejar contextos extensos, grandes volúmenes de datos y numerosas solicitudes simultáneas. Reducir la cantidad de memoria disponible podría limitar algunas de estas aplicaciones.
Además, las especificaciones oficiales de NVIDIA ya contemplan configuraciones HBM4 de 12 capas, por lo que mantenerlas no supondría una modificación de sus planes iniciales. Lo que todavía se desconoce es qué proporción de aceleradores podría incorporar versiones de menor capacidad y si estas llegarían a comercializarse como variantes diferenciadas.
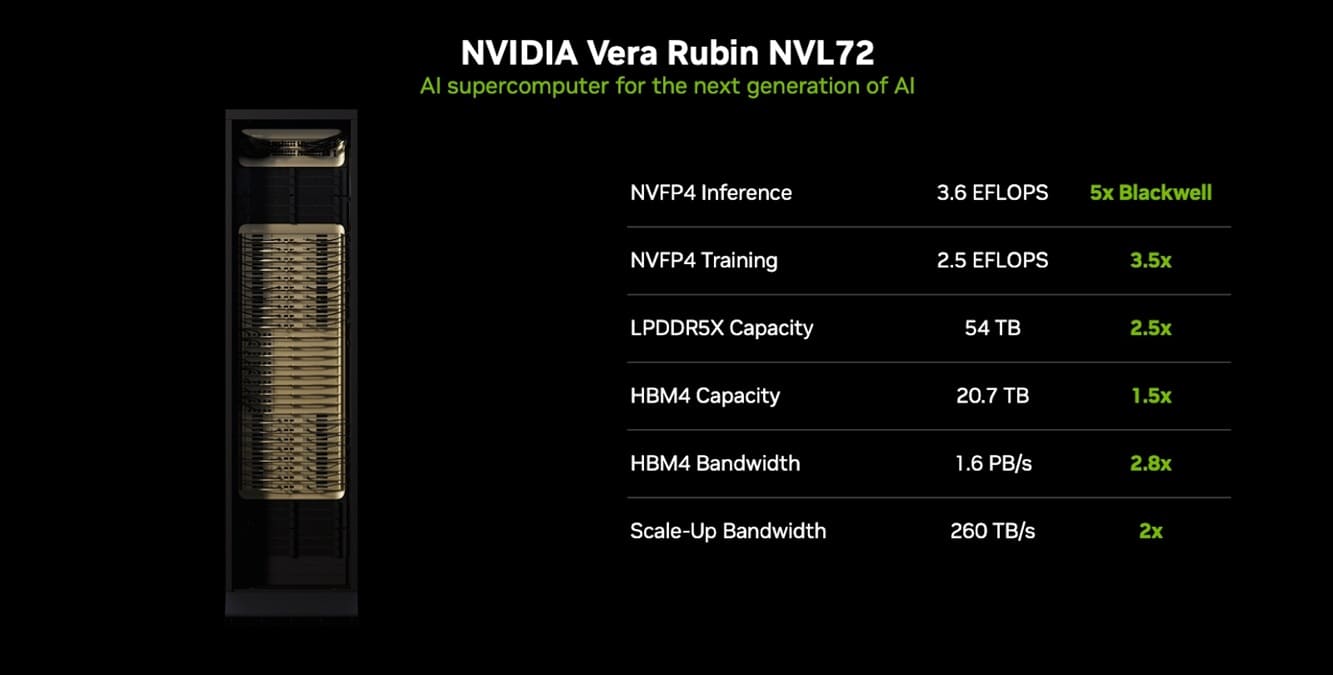
Comparativa de especificaciones entre los sistemas NVIDIA Vera Rubin NVL72 y Blackwell NVL72. Fuente de la imagen: NVIDIA.
Hasta 288 GB HBM4 y 22 TB/s, casi el triple de ancho de banda que Blackwell
La arquitectura Rubin introduce memoria HBM4 con una interfaz de 2.048 bits, duplicando la anchura utilizada por HBM3E. Este cambio, combinado con los nuevos controladores de memoria, permite alcanzar un ancho de banda considerablemente superior al de la generación anterior.
Las cifras oficiales de NVIDIA muestran la evolución entre ambas arquitecturas:
| Característica | Blackwell | Rubin |
|---|---|---|
| Tecnología de memoria | HBM3E | HBM4 |
| Ancho de banda por GPU | 8 TB/s | Hasta 22 TB/s |
| Mejora del ancho de banda | — | Hasta 2,75 veces |
| Capacidad máxima anunciada para Rubin | — | 288 GB |
La mejora resulta especialmente importante durante la inferencia de modelos de IA, donde las operaciones de cálculo necesitan acceder constantemente a los datos almacenados. Un procesador puede disponer de una elevada potencia de cálculo, pero su rendimiento efectivo queda condicionado por la velocidad a la que recibe la información necesaria.
Por esta razón, reducir la capacidad de HBM4 no sería una decisión basada exclusivamente en el ahorro económico. NVIDIA también tendría que valorar las consecuencias sobre el tamaño de los modelos ejecutables, las necesidades de memoria y el rendimiento de sus aceleradores en aplicaciones profesionales.
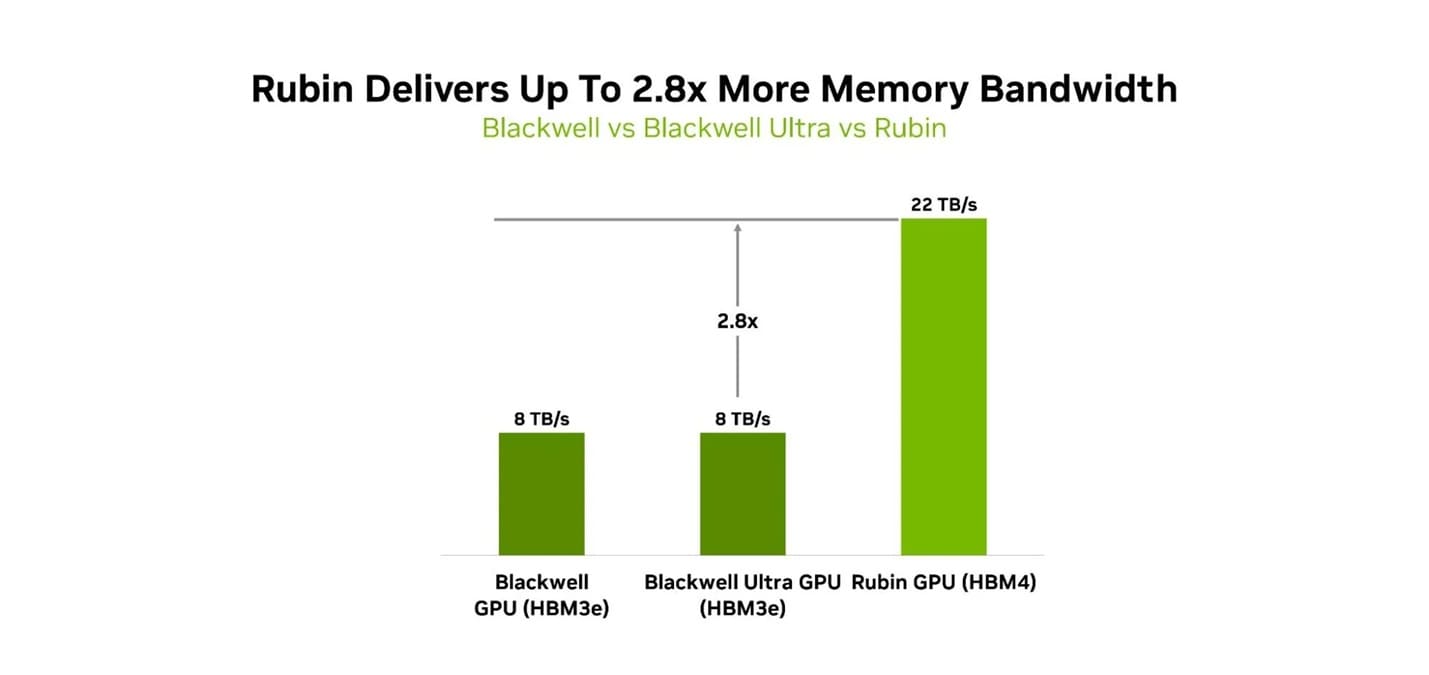
Rubin ofrece un ancho de banda de memoria muy superior al de Blackwell gracias al uso de HBM4. Fuente de la imagen: NVIDIA.
Las HBM4 de 8 capas podrían aliviar los problemas de fabricación
En agosto, ZDNet Korea informó de que NVIDIA había solicitado a Samsung Electronics y SK hynix aumentar el suministro de memoria HBM4 de 8 capas durante la segunda mitad de 2026. La petición estaría relacionada con las dificultades de fabricación, el rendimiento de producción y la disponibilidad de componentes.
La fabricación de HBM4 de 12 capas exige apilar y unir doce chips DRAM, un procedimiento que introduce mayores exigencias técnicas que las configuraciones de menor altura. A ello se suma la complejidad de la interfaz de 2.048 bits, que obliga a los fabricantes a ajustar sus procesos para alcanzar niveles de producción suficientes.
Utilizar HBM4 de 8 capas (8-Hi) permitiría fabricar módulos con menos chips DRAM y aprovechar mejor una producción limitada. Con una cantidad determinada de memoria disponible, los fabricantes podrían abastecer a más aceleradores, aunque cada uno dispondría de una capacidad inferior a la prevista para configuraciones de mayor altura.
Ambas informaciones, por tanto, no tienen por qué ser contradictorias. NVIDIA podría aumentar sus pedidos de HBM4 de 8 capas para determinados productos sin abandonar las configuraciones de 12 capas en la mayoría de los aceleradores Rubin. Sin embargo, la compañía todavía no ha confirmado cambios en su estrategia de suministro.
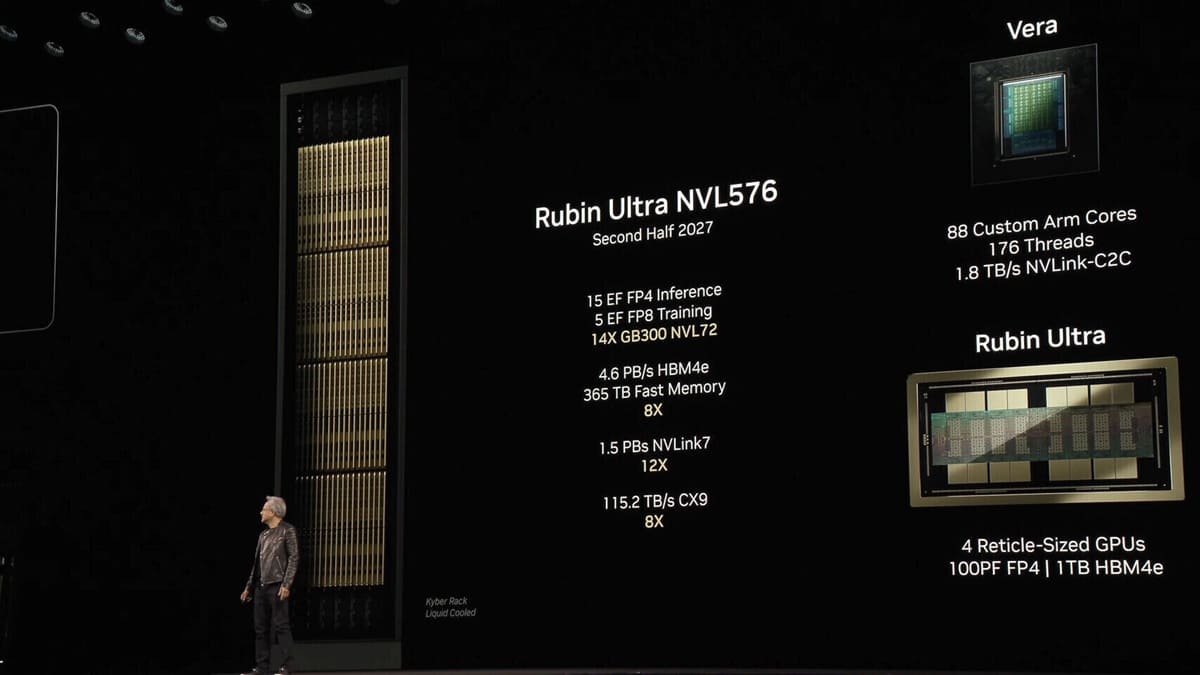
Counterpoint también señala que no ha encontrado evidencias de una adopción de HBM de 4 capas (4-Hi) en aceleradores de IA personalizados mediante ASIC. Por su parte, las especificaciones de la futura plataforma Rubin Ultra continúan bajo evaluación, de modo que no pueden darse por definitivas sus configuraciones de memoria.
La HBM4 de 8 capas podría costar entre un 10% y un 20% más por gigabit
Aunque reducir el número de capas permite utilizar menos chips DRAM, no significa necesariamente que la memoria resulte más barata por unidad de capacidad. Según TrendForce, las configuraciones HBM de 8 capas podrían presentar un precio por gigabit entre un 10% y un 20% superior al de las versiones de 12 capas durante 2027.
La explicación está en la estructura de estos módulos. Cada pila HBM necesita un chip base (base die), cuyo coste de fabricación debe repartirse entre las distintas capas DRAM. Al utilizar ocho capas en lugar de doce, ese coste se distribuye entre una cantidad menor de memoria, elevando el precio relativo de cada gigabit.
Esto introduce una diferencia entre el coste total de un módulo y el coste por unidad de capacidad. Una pila de 8 capas puede ser más barata en términos absolutos porque incorpora menos memoria, pero resultar proporcionalmente más cara que otra de 12 capas.
Para los fabricantes de aceleradores, el compromiso consiste en reducir la cantidad de memoria instalada y facilitar el suministro sin elevar innecesariamente el coste final de cada sistema. Por tanto, las configuraciones de menor capacidad podrían resultar interesantes incluso con un precio por gigabit superior, especialmente si permiten fabricar más unidades.
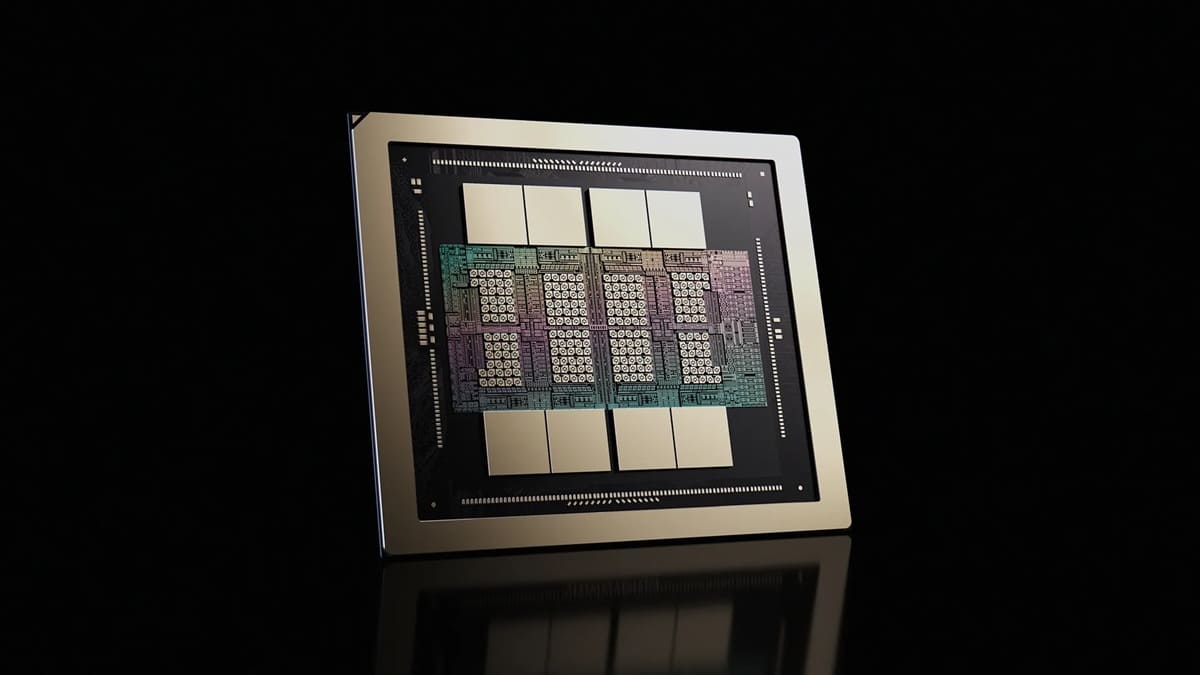
Fuente de la imagen: NVIDIA
TrendForce prevé un aumento del 121% en el precio medio de HBM durante 2027
La presión sobre el suministro no se limita a HBM4. TrendForce ha revisado al alza sus previsiones para 2027, estimando que el precio medio de venta combinado de las memorias HBM aumentará un 121% respecto a 2026.
Sin embargo, esta previsión no significa que todos los módulos HBM vayan a encarecerse individualmente un 121%. El cálculo refleja también el cambio en la composición del mercado, con una mayor presencia de HBM4, cuyo precio es superior al de generaciones anteriores, y la introducción progresiva de HBM4E durante la segunda mitad de 2027.
A esta evolución se suma la competencia por la capacidad de fabricación. La memoria HBM y la DRAM convencional comparten recursos industriales, por lo que el incremento de producción destinado a aceleradores de inteligencia artificial también puede limitar la disponibilidad de otros tipos de memoria.
El problema se agrava porque aumentar la producción de HBM4 y mejorar el rendimiento de fabricación requiere tiempo, mientras que la demanda de infraestructura de IA continúa presionando a los proveedores. Aunque las configuraciones de 8 capas pueden aliviar parcialmente las restricciones, no solucionan por sí solas la escasez.
En este escenario, NVIDIA mantendría las configuraciones de 12 capas para preservar las capacidades de Rubin, mientras evalúa alternativas que permitan gestionar mejor el suministro. La evolución de los precios durante 2027 dependerá tanto de la disponibilidad de HBM4 como del ritmo de producción de HBM4E, dos factores que seguirán condicionando el coste de los futuros aceleradores de inteligencia artificial.
Vía: Wccftech