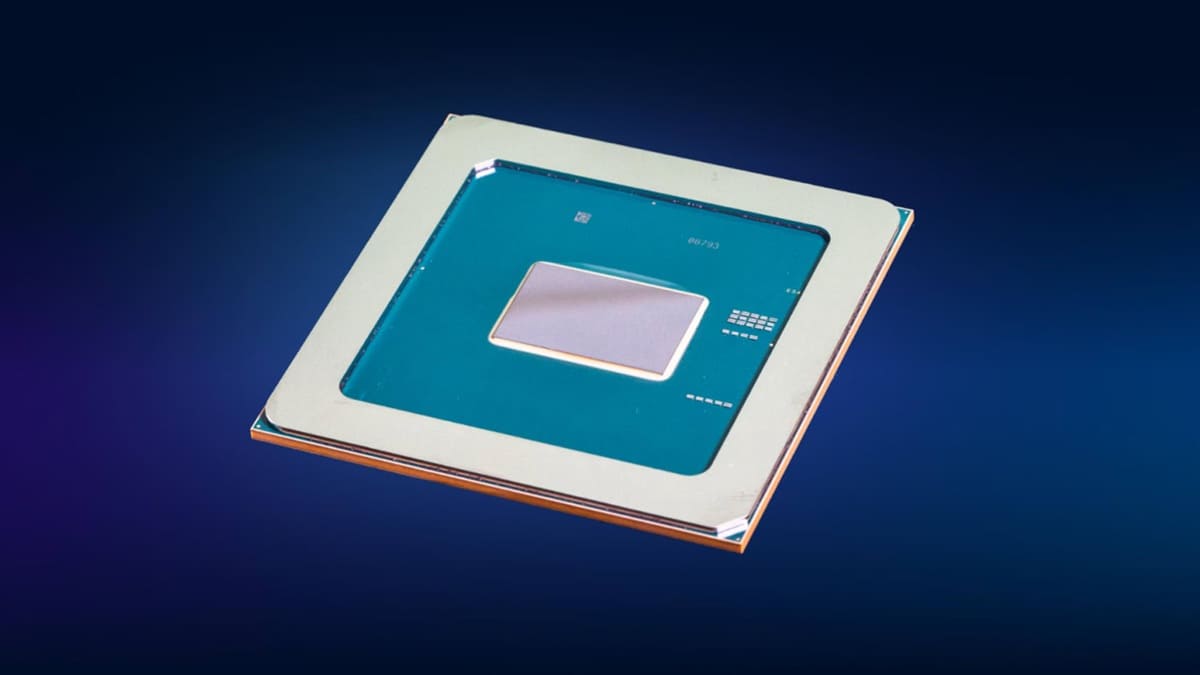
Intel ha publicado una imagen del chip de su acelerador GPU D270, conocido anteriormente como Crescent Island, mostrando por primera vez el silicio utilizado en esta solución para inferencia de inteligencia artificial. Basado en la microarquitectura Xe3P, incorpora 32 núcleos Xe, 256 motores matriciales XMX y 32 MB de caché L2 unificada, con una configuración diseñada específicamente para ejecutar modelos de IA en centros de datos, en lugar de procesar gráficos convencionales.
La compañía apuesta por una GPU especializada que prescinde de las unidades tradicionales de renderizado 3D y Ray Tracing, reservando mayor superficie del silicio para operaciones de cálculo. Su propuesta combina hasta 480 GB de memoria LPDDR5X, un consumo de 350W y conectividad PCI Express 5.0 x16. Sin embargo, esa capacidad máxima corresponde a configuraciones de fabricantes asociados, mientras la tarjeta de referencia de Intel incorpora 160 GB, una diferencia importante para valorar sus posibilidades reales.
El chip Crescent Island concentra 32 núcleos Xe3P en una arquitectura especializada
La fotografía incorporada a la página oficial de Intel GPU D270 permite observar el chip sin encapsulado, mostrando un diseño que parece relativamente compacto frente a otros aceleradores destinados a inteligencia artificial. No obstante, Intel no ha publicado sus dimensiones exactas, por lo que la imagen no permite establecer comparaciones rigurosas sobre superficie, densidad de transistores o costes de fabricación.
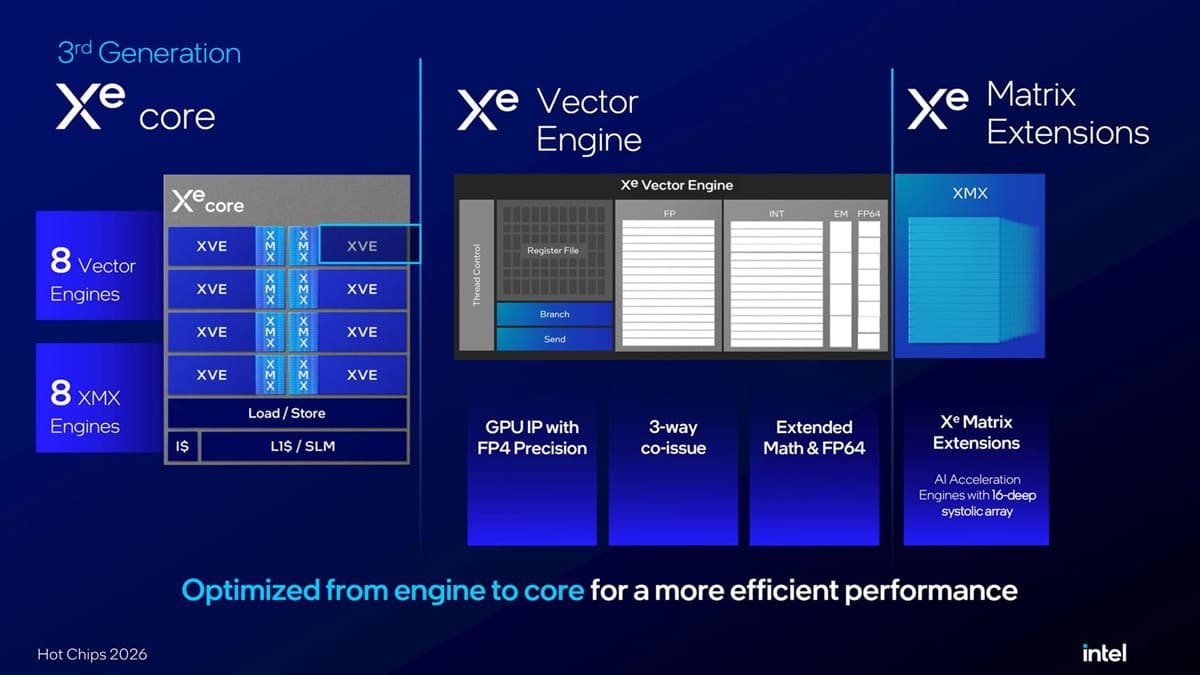
La arquitectura se organiza en cuatro bloques de procesamiento con ocho núcleos Xe3P cada uno, sumando 32 núcleos en total. Cada núcleo integra ocho motores vectoriales y ocho unidades matriciales XMX, lo que proporciona 256 motores de cada tipo. Esta distribución refleja una prioridad clara: aumentar la capacidad de cálculo destinada a operaciones matemáticas utilizadas por los modelos de inteligencia artificial.
La eliminación de los bloques convencionales de gráficos 3D también tiene consecuencias prácticas. Crescent Island no está diseñada para ejecutar videojuegos ni sustituir a una Intel Arc, puesto que carece de los recursos habituales para generar imágenes mediante las técnicas de renderizado tradicionales. Intel ha destinado ese presupuesto de silicio a reforzar el procesamiento paralelo y las operaciones matriciales, fundamentales para ejecutar redes neuronales.
Xe3P multiplica por cuatro la profundidad de procesamiento de los motores XMX
Una de las modificaciones más importantes aparece en los motores XMX de nueva generación, que abandonan la estructura sistólica de cuatro etapas utilizada en Xe3 para adoptar una organización de 16 etapas en Xe3P. Este cambio permite desarrollar operaciones matriciales mediante una estructura de procesamiento más profunda, orientada a mantener una elevada utilización de las unidades de cálculo.
Sin embargo, cuadruplicar la profundidad de los motores XMX no significa multiplicar automáticamente por cuatro su rendimiento. El resultado depende de la frecuencia de funcionamiento, la precisión numérica utilizada y la capacidad del subsistema de memoria para suministrar datos. Una unidad matricial más potente pierde parte de su ventaja cuando necesita detenerse continuamente para esperar información.
Precisamente para reducir ese problema, cada núcleo Xe3P incorpora 1 MB de registros de propósito general y 512 KB de caché L1 o memoria local compartida. Esta configuración permite mantener más datos próximos a las unidades de ejecución, evitando determinados accesos a niveles superiores de memoria. Los 32 MB de caché L2 unificada completan una jerarquía pensada para alimentar los motores matriciales durante operaciones intensivas.
La arquitectura también incorpora soporte para formatos FP4 y FP8, especialmente relevantes en inferencia por su capacidad para representar los datos utilizando menos bits. En modelos compatibles, una precisión reducida puede disminuir las necesidades de memoria y mejorar el aprovechamiento del hardware. Intel anuncia para su serie D hasta 1,3 PFLOPS en FP8 y 1,5 TB/s de ancho de banda, aunque se trata de cifras teóricas que todavía deben contrastarse con pruebas reales.
Hasta 480 GB LPDDR5X para modelos de IA con contextos extensos
La elección de memoria LPDDR5X en lugar de HBM constituye otra diferencia importante frente a los aceleradores de inteligencia artificial de mayor tamaño. Intel prioriza la capacidad disponible, la eficiencia energética y el coste de despliegue, aunque esta decisión también introduce compromisos relacionados con el ancho de banda y la capacidad de alimentar operaciones matemáticas muy exigentes.
La compañía ofrece 160 GB LPDDR5X en su tarjeta de referencia, mientras los fabricantes asociados pueden desarrollar versiones de hasta 480 GB. Esta capacidad permite mantener modelos de gran tamaño y parte de sus datos de trabajo directamente en la memoria del acelerador. En determinados escenarios, disponer de más memoria puede resultar más útil que aumentar exclusivamente la potencia de cálculo, especialmente cuando evita repartir un modelo entre varias GPU.
El planteamiento está dirigido a sistemas de IA agéntica capaces de ejecutar miles de pasos y trabajar con contextos de aproximadamente 100.000 tokens. Estas aplicaciones necesitan conservar instrucciones, documentos y estados intermedios durante numerosas operaciones. La memoria disponible también condiciona el tamaño de la caché KV, utilizada para almacenar información de atención de los modelos y evitar que determinados cálculos tengan que repetirse.
Cuatro codificadores y cuatro decodificadores para cargas de IA multimodal
Aunque Crescent Island carece de hardware dedicado al renderizado gráfico convencional, Intel mantiene un motor multimedia con cuatro codificadores y cuatro decodificadores de vídeo. Estos componentes pueden resultar útiles en aplicaciones multimodales que trabajan simultáneamente con texto, imágenes y secuencias audiovisuales, descargando determinadas operaciones de las unidades generales de procesamiento.
La integración tiene especial interés en sistemas de análisis y comprensión de vídeo mediante inteligencia artificial, donde la preparación de los datos puede convertirse en un cuello de botella. Sin embargo, disponer de estos motores no garantiza compatibilidad con todos los códecs ni un rendimiento concreto en generación audiovisual. Esos resultados dependerán de los formatos admitidos y de las aplicaciones utilizadas.
PCIe 5.0 x16 y 350W para servidores con refrigeración pasiva
La Intel GPU D270 utiliza un formato de tarjeta PCI Express 5.0 x16 con un consumo de 350W, pensado para integrarse en servidores convencionales. Su sistema de refrigeración pasiva aprovecha el flujo de aire generado por la infraestructura del servidor, evitando la necesidad de instalar refrigeración líquida dedicada para este diseño.
Esta configuración busca facilitar el despliegue de aceleradores de inferencia en instalaciones existentes, donde el consumo eléctrico, la densidad de tarjetas y el coste operativo pueden ser tan importantes como la potencia de cálculo. Intel también plantea compatibilidad con herramientas como vLLM y el ecosistema PyTorch, aunque la eficiencia final dependerá de la madurez de los drivers y de las optimizaciones disponibles para Xe3P.
Por ahora, Intel no ha publicado benchmarks independientes que permitan evaluar el rendimiento real de Crescent Island D270 frente a alternativas de NVIDIA o AMD. Las cifras de cálculo y memoria describen sus capacidades teóricas, pero todavía falta conocer aspectos como tokens por segundo, latencia, concurrencia y consumo por consulta. Estas mediciones serán fundamentales para determinar si su combinación de memoria LPDDR5X y motores XMX ofrece una ventaja competitiva en inferencia.
Vía: TechPowerUp