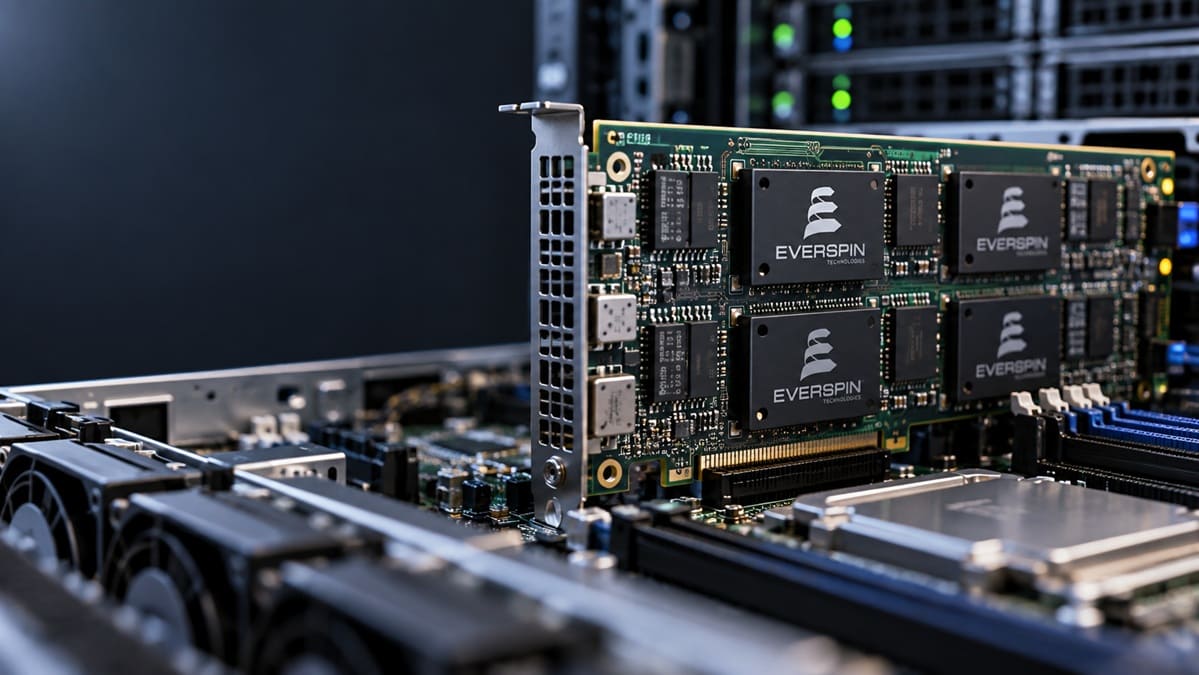
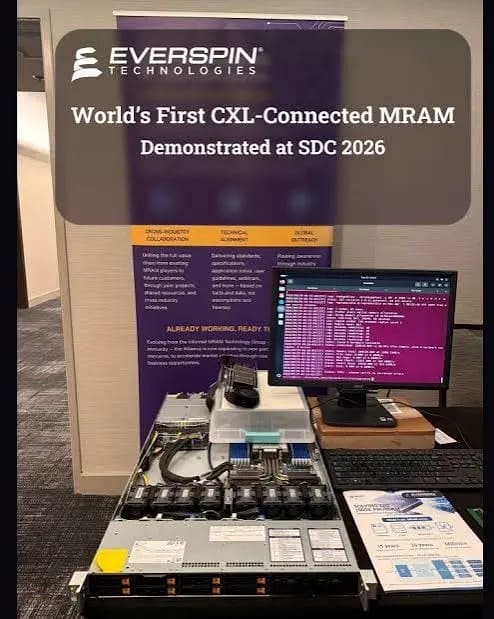
Everspin Technologies ha demostrado lo que describe como la primera plataforma de memoria MRAM conectada mediante Compute Express Link (CXL), planteando una nueva capa de memoria persistente situada entre la DRAM convencional y el almacenamiento basado en NAND.
La demostración combina memoria PERSYST MRAM con un host compatible con CXL, permitiendo que procesadores y aceleradores accedan a datos persistentes utilizando semántica de memoria y granularidad de línea de caché. La compañía habla de latencias del orden de nanosegundos y escrituras hasta 100 veces más rápidas que el almacenamiento NAND, aunque esta última cifra procede del fabricante y dependerá mucho de la carga y del SSD utilizado como referencia.
La MRAM mantiene los datos incluso cuando desaparece la alimentación
La principal diferencia frente a la DRAM está en que MRAM es una tecnología de memoria no volátil, por lo que puede conservar su contenido incluso después de apagar el sistema o sufrir una interrupción eléctrica.
Esto permite mantener determinados datos de trabajo sin recurrir necesariamente a DRAM respaldada mediante baterías ni a copiar inmediatamente toda la información hacia un SSD antes de que el sistema pierda alimentación.
La ventaja frente al almacenamiento NAND está en la forma de acceder a los datos. Un SSD tradicional trabaja mediante bloques y atraviesa una pila de almacenamiento, mientras esta implementación puede presentar la MRAM al sistema utilizando un modelo mucho más próximo al de la memoria principal.
Eso no convierte automáticamente a MRAM en sustituta de la DRAM o de los SSD. Cada tecnología mantiene ventajas diferentes en capacidad, ancho de banda, persistencia y coste, haciendo más probable que MRAM ocupe una capa especializada entre ambas.
CXL permite acceder a la memoria con granularidad de línea de caché
Compute Express Link está pensado para proporcionar una interconexión coherente de alta velocidad entre CPU, aceleradores y dispositivos de memoria, aprovechando la infraestructura física de PCIe.
En la demostración de Everspin, el procesador puede acceder a la memoria persistente sin tratarla simplemente como otro dispositivo de almacenamiento en bloques, reduciendo parte de la sobrecarga asociada a los caminos tradicionales de entrada y salida.
El acceso a nivel de línea de caché resulta particularmente interesante para estructuras pequeñas que necesitan actualizarse con frecuencia, donde escribir bloques completos sobre almacenamiento NAND sería mucho menos eficiente.
También abre la puerta a software capaz de mantener determinadas estructuras directamente en memoria persistente, aunque aprovechar correctamente esta característica exigirá cambios en sistemas operativos, bases de datos y aplicaciones.
La demostración utiliza un EPYC 9355 y módulos MRAM de solo 1 GB
El sistema empleado está construido alrededor de un servidor Supermicro AS-1116CS-TN equipado con un AMD EPYC 9355 de 32 núcleos. La conexión CXL se implementa mediante una FPGA AMD Alveo U250 que integra un controlador Wolley.
Everspin utiliza módulos PERSYST DDR4 MRAM UDIMM de 1 GB, una capacidad diminuta frente a los cientos de gigabytes de memoria y los terabytes de almacenamiento habituales en servidores modernos.
Precisamente por eso, la demostración debe interpretarse como una prueba de arquitectura, latencia y persistencia, no como un sistema preparado actualmente para reemplazar grandes pools de DRAM o almacenamiento empresarial.
El valor está en demostrar que CXL puede exponer memoria persistente mediante un modelo de acceso mucho más parecido al de la RAM, estableciendo una base sobre la que posteriormente podrían construirse dispositivos de mayor capacidad.
La IA podría aprovecharla para checkpoints y cachés persistentes
Una aplicación especialmente interesante aparece en los sistemas de inteligencia artificial que necesitan guardar periódicamente estados intermedios, evitando perder horas de trabajo si una ejecución falla.
Los checkpoints de modelos grandes pueden implicar escribir enormes cantidades de información hacia almacenamiento NAND, generando pausas y un volumen importante de operaciones sobre los SSD.
Una capa persistente más rápida podría actuar como buffer intermedio para conservar estados críticos con mucha menor latencia, dejando que la información se transfiera posteriormente hacia almacenamiento de mayor capacidad cuando resulte conveniente.
Otro escenario son las cachés key-value utilizadas durante la inferencia de modelos de lenguaje, donde mantener información persistente entre reinicios podría reducir determinados tiempos de reconstrucción o carga.
Estas ventajas dependerán, no obstante, de cómo los frameworks de IA integren realmente la memoria persistente, porque disponer del hardware no basta si el software continúa tratándolo como almacenamiento convencional.
CXL también abre la puerta a pools compartidos de memoria persistente
Otra posibilidad está en memory pooling, una de las funciones más interesantes del ecosistema CXL. En lugar de asociar necesariamente toda la memoria a un único servidor, determinados recursos pueden compartirse o asignarse dinámicamente entre varios hosts compatibles.
Aplicado a MRAM, esto permitiría disponer de una reserva persistente accesible según las necesidades de diferentes cargas, aumentando potencialmente la utilización de un recurso que todavía resulta demasiado caro para desplegarlo masivamente.
Un servidor que necesite temporalmente una gran caché persistente podría recibir más capacidad, mientras otro sistema con menor demanda podría liberar parte de ella. La flexibilidad resulta especialmente atractiva en centros de datos donde las cargas cambian continuamente.
El problema vuelve a estar en coste y densidad. Para que este modelo resulte competitivo, MRAM tendrá que aumentar considerablemente su capacidad por dispositivo y reducir su precio por gigabyte.
MRAM sigue teniendo una desventaja enorme en capacidad y coste
La NAND continúa ofreciendo muchísima más capacidad por unidad de coste, mientras que la DRAM mantiene un ancho de banda extremadamente elevado y una madurez enorme dentro de los servidores.
MRAM no necesita superar directamente a ninguna de las dos para resultar útil. Su oportunidad está en ocupar un espacio intermedio donde persistencia y baja latencia sean más importantes que alcanzar varios terabytes al menor coste posible.
Esto puede limitar inicialmente la tecnología a cachés persistentes, metadatos críticos, registros, bases de datos especializadas y determinadas cargas de IA, antes de que aumentos de densidad permitan abordar escenarios más amplios.
La afirmación de escrituras hasta 100 veces superiores a NAND también necesitará pruebas independientes bajo cargas comparables, porque tamaño de transferencia, profundidad de cola, controlador y SSD utilizado pueden cambiar radicalmente el resultado.
Everspin ya permite que los clientes prueben sus propias cargas
La plataforma ha avanzado más allá de un concepto puramente teórico, ya que Everspin asegura que está disponible para que clientes evalúen sus propias cargas de trabajo.
Eso sigue estando lejos de una plataforma comercial producida a gran escala, pero permite comprobar qué aplicaciones obtienen realmente ventajas al incorporar una capa persistente conectada mediante CXL.
El siguiente desafío será principalmente de software. Una memoria que conserva datos después de reiniciar introduce problemas de coherencia y consistencia que la DRAM convencional no necesita resolver de la misma manera, obligando a las aplicaciones a distinguir qué información continúa siendo válida.
La demostración muestra así que CXL puede utilizarse para algo más que ampliar la capacidad de memoria convencional. También puede servir como puente hacia tecnologías persistentes direccionables como memoria, creando una nueva capa entre la rapidez de la DRAM y la enorme capacidad de los SSD NAND.
Vía: Guru3D