NVIDIA ha mostrado nuevos detalles de Vera Rubin Ultra NVL576, una plataforma de inteligencia artificial diseñada para interconectar 576 GPUs mediante NVLink 7 y tecnología óptica CPO (Co-Packaged Optics). El sistema distribuye los aceleradores entre varios racks refrigerados por líquido, formando un único dominio de comunicación de alta velocidad para ejecutar modelos de IA de gran tamaño.
Durante el OCP Global Summit 2026, Ian Buck, vicepresidente de computación a hiperescala y alto rendimiento de NVIDIA, ha explicado cómo funcionará esta infraestructura, concebida para trabajar con modelos de hasta 10 billones de parámetros. Las previsiones anteriores contemplan una capacidad de cálculo de 15 exaflops FP4 para inferencia y 5 exaflops FP8 para entrenamiento, aunque su rendimiento efectivo dependerá de las cargas ejecutadas.
Rubin Ultra NVL576 conectará 576 GPU mediante NVLink 7
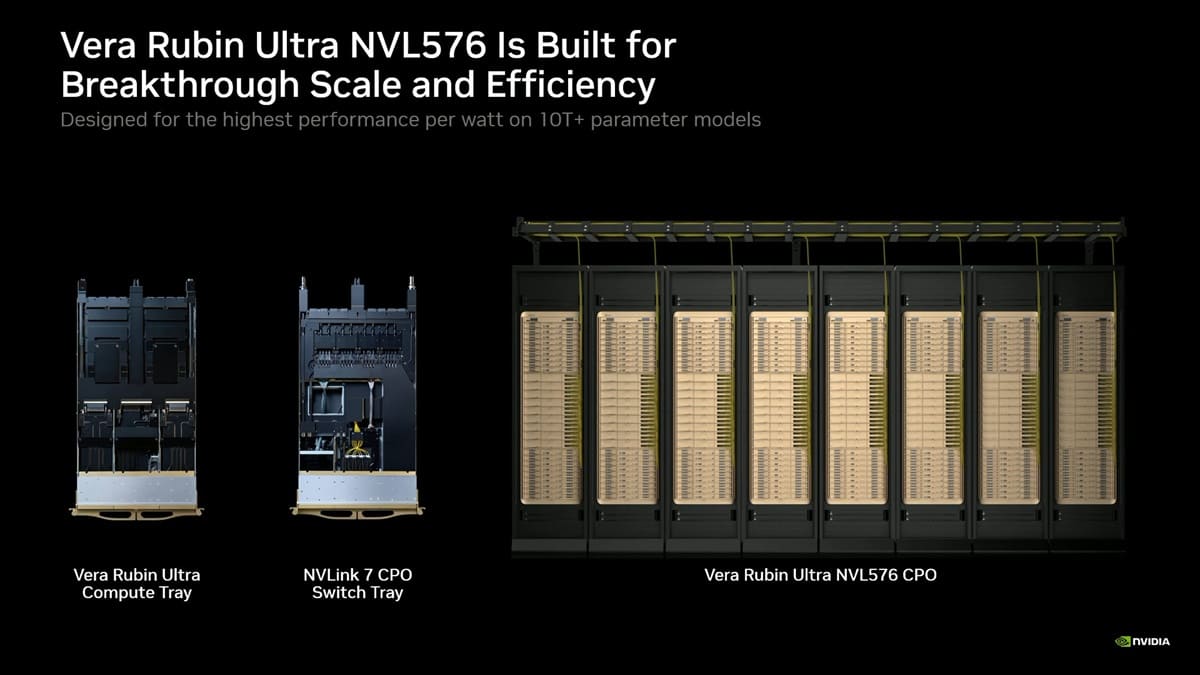
La principal novedad de Vera Rubin Ultra NVL576 es la ampliación del dominio de interconexión de GPU más allá de un único rack. Frente a las configuraciones NVL72, que agrupan 72 aceleradores, la nueva arquitectura permitirá conectar hasta 576 GPU dentro de una misma infraestructura NVLink.
La documentación técnica de NVIDIA describe una configuración distribuida entre ocho racks MGX de 72 GPUs cada uno, conectados mediante una topología NVLink de dos niveles. Por separado, el diseño Kyber NVL144 contempla aumentar la densidad hasta 144 GPUs por rack, por lo que no deben confundirse ambas configuraciones.
El objetivo es que los aceleradores puedan trabajar de forma coordinada sobre modelos demasiado grandes para una GPU individual, utilizando conexiones de gran ancho de banda para intercambiar información durante los cálculos. Esta aproximación resulta especialmente importante en aplicaciones que distribuyen las operaciones de una red neuronal entre numerosos procesadores.
Sin embargo, 576 GPUs conectadas mediante NVLink no equivalen físicamente a una única GPU monolítica. El procesamiento sigue distribuido entre múltiples chips, con recursos de memoria independientes y comunicaciones que introducen costes adicionales. El resultado dependerá de cómo el software reparta las operaciones y aproveche la interconexión disponible.
La óptica CPO permitirá comunicar los racks con menor dependencia del cobre
Para extender NVLink entre diferentes racks, NVIDIA utilizará Co-Packaged Optics (CPO), una tecnología que integra motores ópticos cerca de los circuitos de conmutación. En lugar de depender exclusivamente de conexiones eléctricas de cobre, determinadas comunicaciones podrán realizarse mediante fibra óptica.
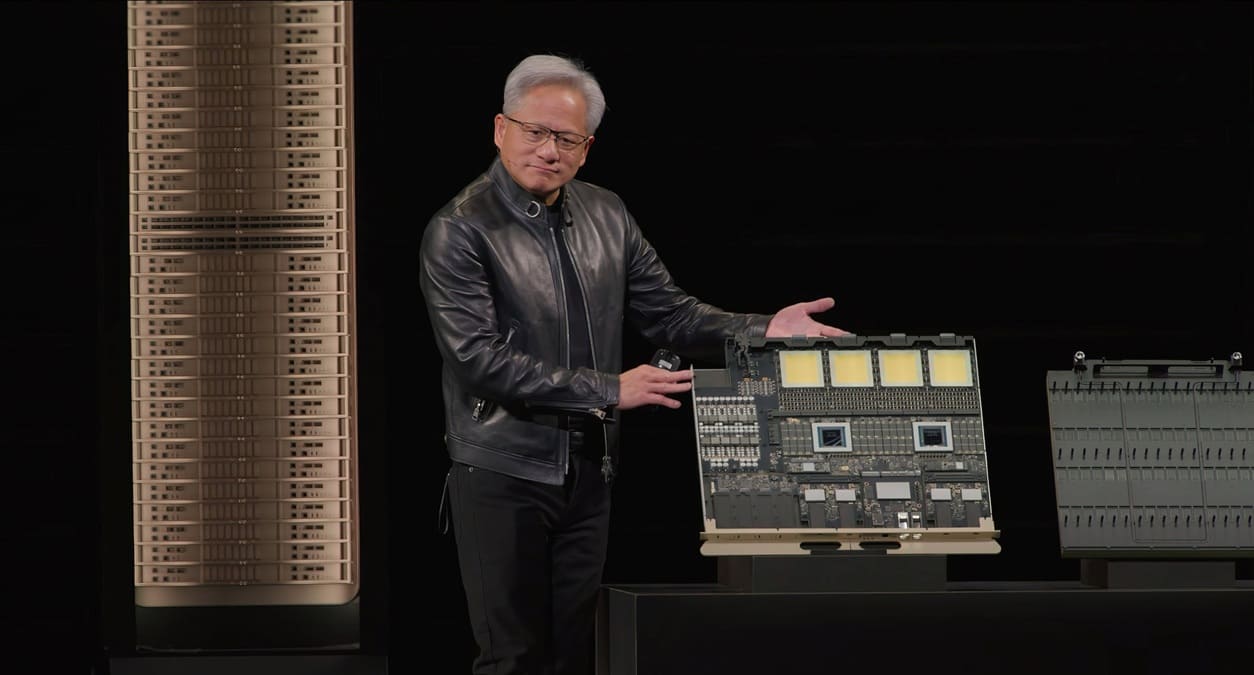
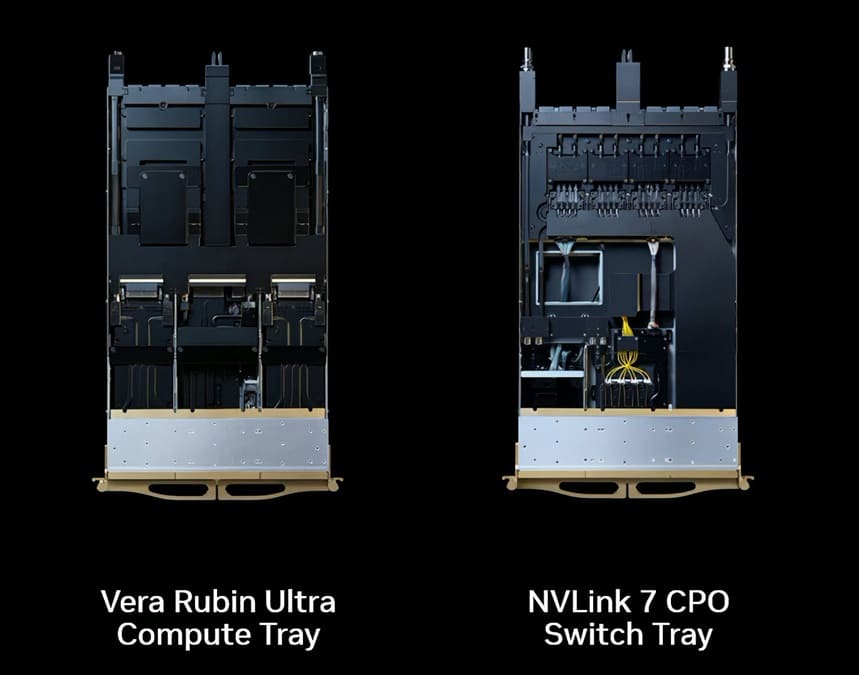
La compañía ha mostrado por primera vez una bandeja de conmutación NVLink 7 CPO, encargada de conectar los aceleradores dentro de esta infraestructura ampliada. Ian Buck destacó durante su presentación las conexiones de fibra utilizadas entre los motores ópticos, integradas en el diseño modular del sistema.
La diferencia resulta importante porque las conexiones eléctricas de alta velocidad presentan mayores dificultades conforme aumenta la distancia entre componentes. La transmisión óptica permite extender las comunicaciones entre racks, aunque también requiere circuitos de conversión, componentes adicionales y mecanismos de gestión térmica.
Esto no significa que NVIDIA vaya a eliminar completamente el cobre. La arquitectura combina conexiones eléctricas dentro de los racks con enlaces ópticos para la comunicación entre ellos, aprovechando cada tecnología donde ofrece mejores condiciones de funcionamiento.
Según las declaraciones de Jensen Huang durante GTC Berlín 2026, NVIDIA ya ha iniciado la producción en volumen de determinadas soluciones basadas en CPO. Sin embargo, eso no implica que Rubin Ultra NVL576 esté disponible comercialmente, ya que se trata de una plataforma posterior que todavía debe completar su desarrollo.
Hasta 15 exaflops FP4 y 365 TB de memoria rápida
La hoja de ruta presentada anteriormente por NVIDIA contempla un incremento considerable de capacidad frente a la plataforma Blackwell GB300 NVL72. En particular, Rubin Ultra NVL576 apunta a multiplicar por 14 la potencia de cálculo FP4 anunciada para aquella configuración, aunque la comparación enfrenta sistemas con diferente número de aceleradores.
Las principales cifras comunicadas para la plataforma son las siguientes:
| Característica | Rubin Ultra NVL576 |
|---|---|
| GPUs interconectadas | 576 |
| Rendimiento de inferencia FP4 | Hasta 15 exaflops |
| Rendimiento de entrenamiento FP8 | Hasta 5 exaflops |
| Memoria rápida total prevista | 365 TB |
| Ancho de banda agregado HBM4E | 4,6 PB/s |
| Interconexión NVLink 7 | 1,5 PB/s |
| Conectividad ConnectX-9 | 115,2 TB/s |
Objetivos y especificaciones de la hoja de ruta comunicada por NVIDIA. Las configuraciones definitivas pueden cambiar antes de su comercialización.
El uso de memoria HBM4E permitirá aumentar la capacidad disponible para almacenar parámetros y datos intermedios de modelos de inteligencia artificial. Las propuestas iniciales de Rubin Ultra también contemplaban diseños gráficos de cuatro retículas con hasta 1 TB de memoria, aunque la configuración final de los chips continúa sujeta a la evolución del proyecto.
Conviene distinguir la capacidad de memoria agregada del sistema y la cantidad accesible directamente por cada GPU. Aunque los aceleradores pueden intercambiar información mediante NVLink, el ancho de banda local de HBM y el de la red de interconexión no son equivalentes ni deben sumarse como si representaran un único recurso.
Las cifras de rendimiento requieren una interpretación similar. Los exaflops FP4 y FP8 corresponden a precisiones numéricas diferentes, utilizadas en distintas operaciones de inteligencia artificial. No permiten deducir directamente la velocidad de generación de tokens ni comparar el rendimiento de todas las aplicaciones.
Bandejas con dos GPUs Rubin Ultra, CPU Vera y refrigeración líquida
La infraestructura utiliza bandejas de procesamiento que combinan dos GPUs Rubin Ultra con una CPU Vera, integradas en un sistema de refrigeración líquida. NVIDIA ha mostrado estos componentes junto con las nuevas bandejas de conmutación óptica, que formarán parte del diseño modular de la plataforma.
Esta distribución permite organizar procesamiento, memoria e interconexiones en unidades físicas destinadas a grandes instalaciones de cálculo. La refrigeración líquida resulta especialmente relevante cuando se concentran numerosos aceleradores en un espacio reducido, aunque NVIDIA todavía deberá concretar los requisitos definitivos de consumo y disipación.
El diseño también sigue las especificaciones del Open Compute Project (OCP), utilizadas para facilitar la integración y el mantenimiento de infraestructuras de centros de datos. NVIDIA pretende conservar el sistema modular introducido con Vera Rubin, reduciendo las operaciones manuales necesarias durante el montaje.
Sin embargo, una mayor facilidad de instalación no elimina la complejidad de desplegar 576 GPUs interconectadas. Además de montar las bandejas, es necesario disponer de alimentación eléctrica, refrigeración, conexiones ópticas y herramientas capaces de supervisar el funcionamiento de todo el conjunto.
Modelos de 10 billones de parámetros y despliegues mediante DSX POD
Según Ian Buck, Rubin Ultra NVL576 está diseñada para afrontar modelos de inteligencia artificial con aproximadamente 10 billones de parámetros, una escala que exige distribuir tanto los cálculos como los datos entre numerosos aceleradores.
Aumentar el tamaño del dominio NVLink puede reducir determinadas barreras de comunicación en estos escenarios, especialmente cuando el modelo necesita intercambiar información continuamente entre diferentes GPU. No obstante, el tamaño máximo que pueda ejecutarse dependerá también de la precisión numérica, la memoria disponible y la arquitectura del modelo.
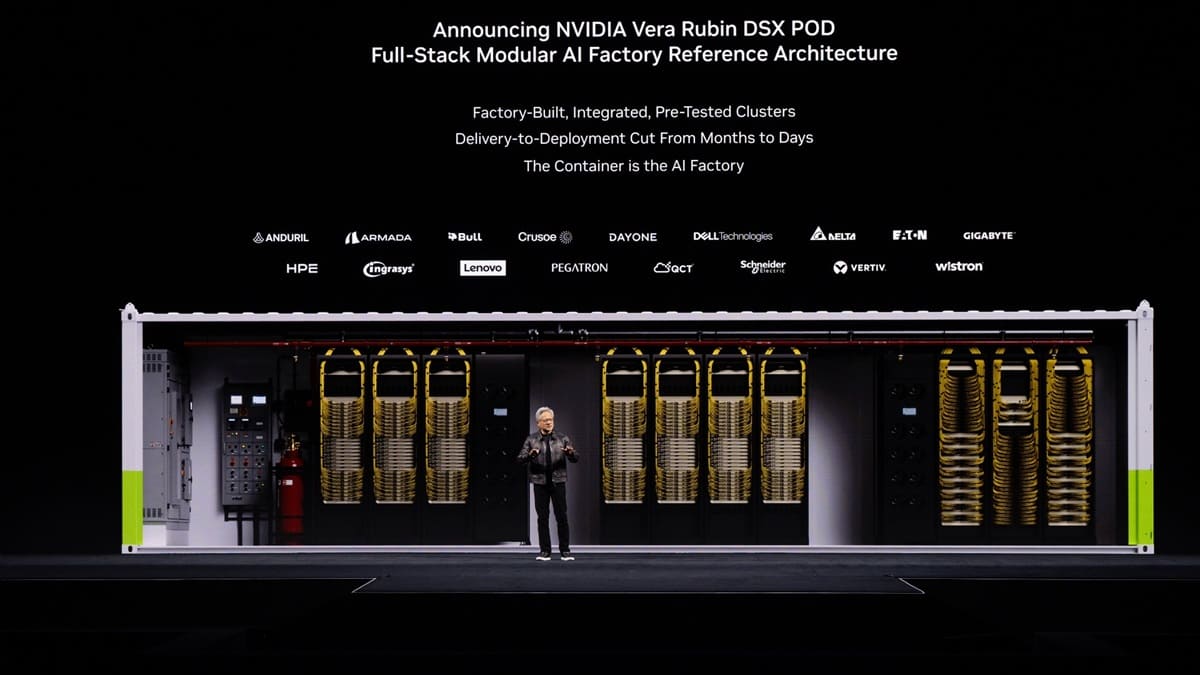
Esta evolución se relaciona con DSX POD, el diseño modular presentado por NVIDIA para acelerar el despliegue de centros de datos de IA. La compañía asegura que estas infraestructuras prefabricadas pueden reducir el tiempo de instalación en una ubicación previamente preparada de varios meses a tan solo 14 días, aunque esa cifra no incluye construir desde cero la infraestructura necesaria.
Por ahora, Rubin Ultra NVL576 continúa siendo una plataforma de próxima generación, con objetivos de despliegue situados en la hoja de ruta de 2027 y pendientes de las condiciones finales de producción. La principal innovación es extender un mismo dominio NVLink a 576 GPUs mediante interconexiones ópticas, mientras que las mejoras de rendimiento por vatio anunciadas todavía deberán demostrarse con sistemas comerciales y cargas de trabajo representativas.
Vía: Wccftech