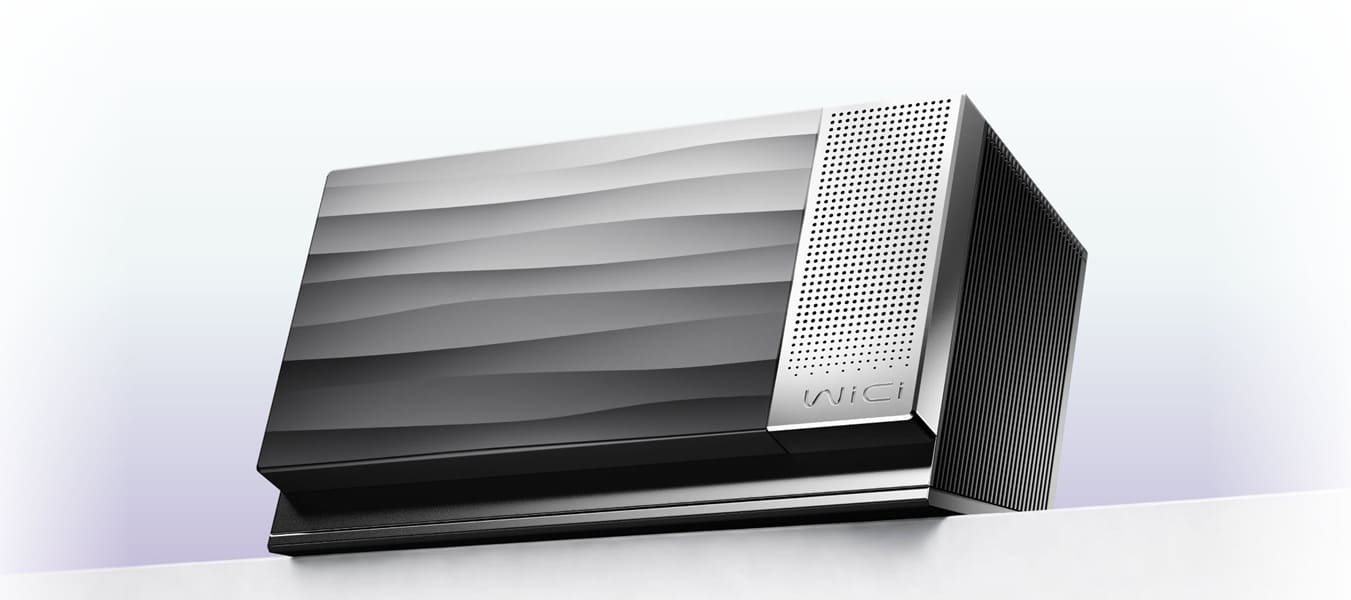
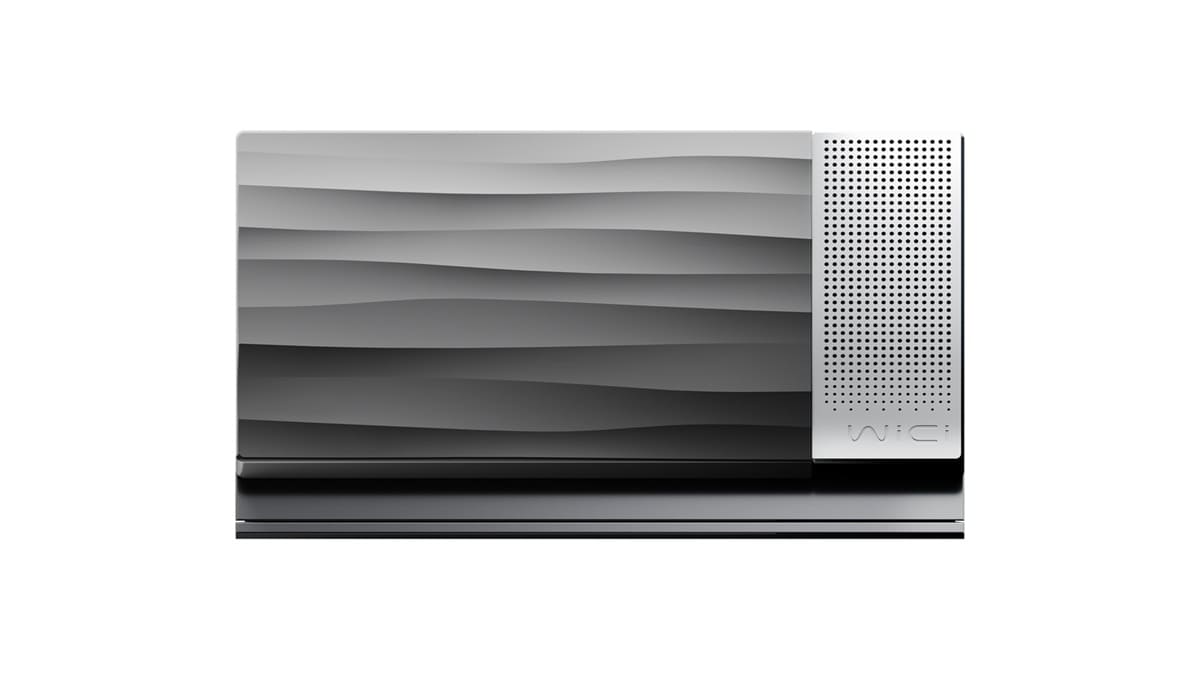
WiCi ha dado a conocer WiCi One, un sistema que permite compartir la capacidad de una tarjeta gráfica dedicada entre diferentes dispositivos mediante Wi-Fi 7. La compañía lo define como una solución de GPU local inalámbrica, buscando ofrecer aceleración para inteligencia artificial, creación de contenido y juegos sin instalar físicamente una GPU potente en cada equipo.
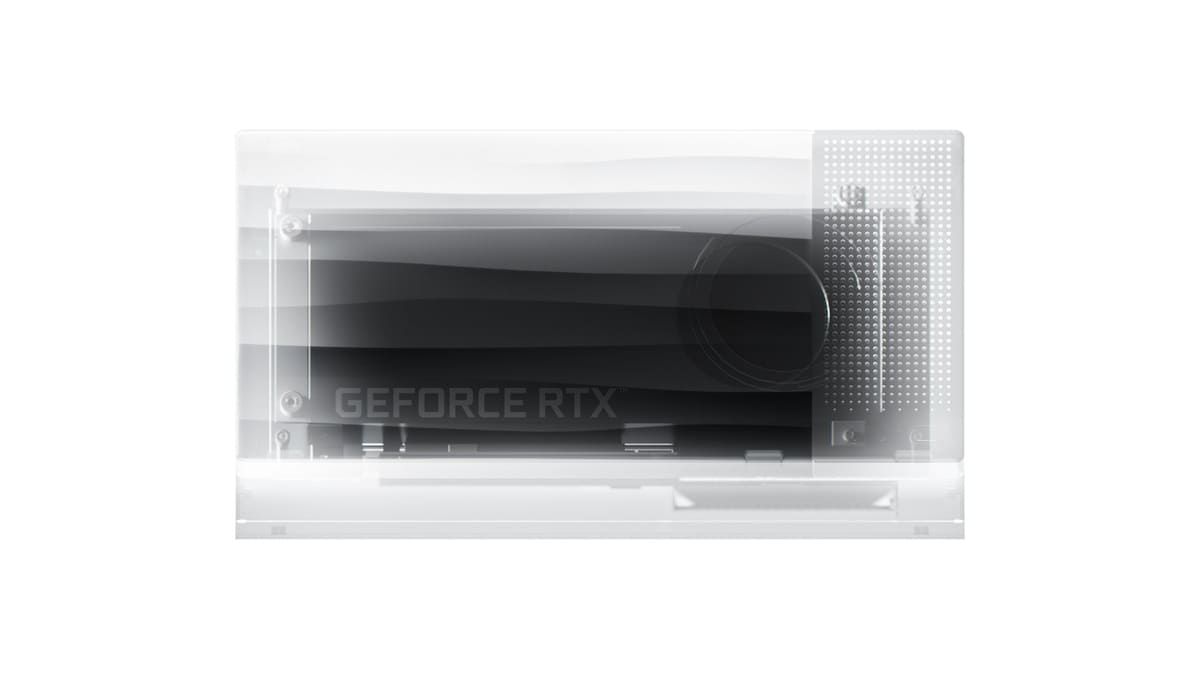
El dispositivo podrá configurarse con GeForce RTX 5060 Ti de 16 GB o RTX 5090 de 32 GB, funcionando como un sistema independiente con su propia CPU y almacenamiento. Su precio partirá de 2.599 dólares (2.291€), aunque los primeros registros podrán acceder a una promoción de 1.999 dólares (1.762€).
Dos configuraciones con RTX 5060 Ti y RTX 5090
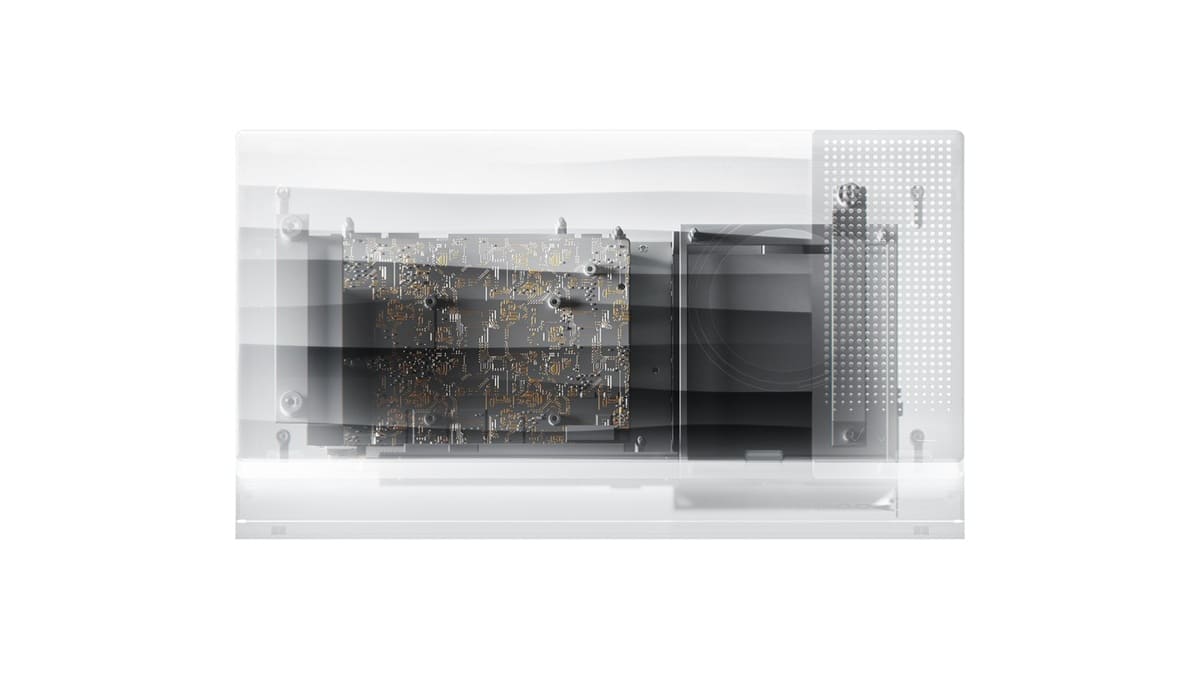
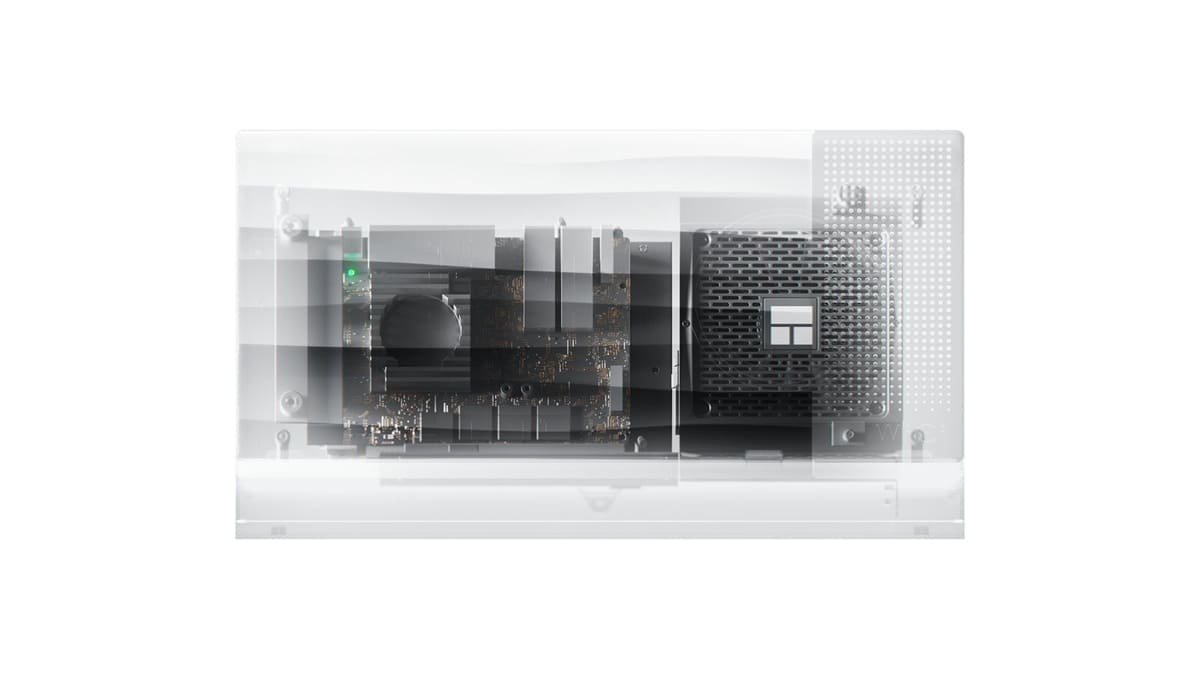
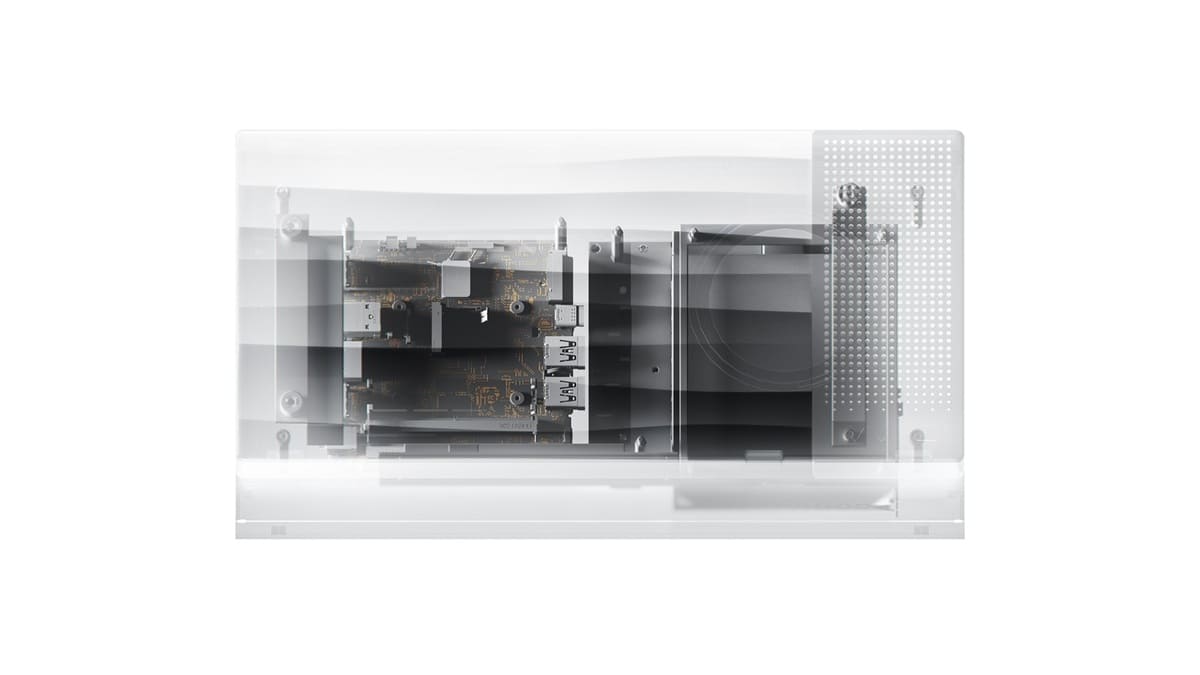
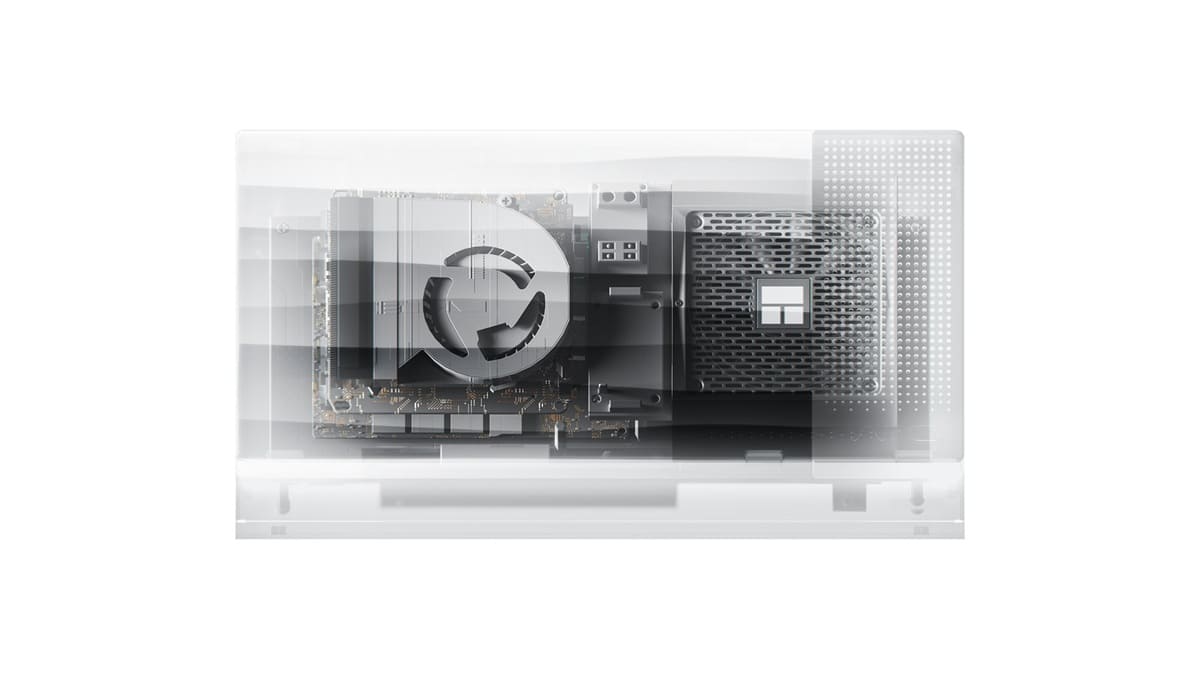
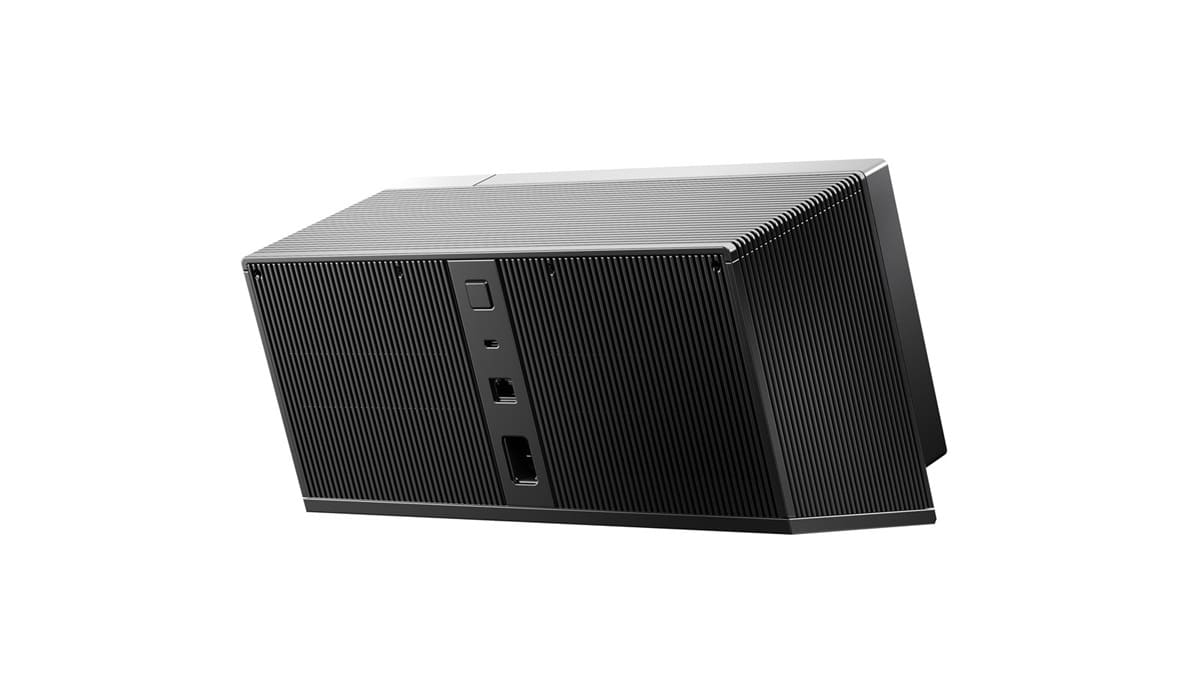
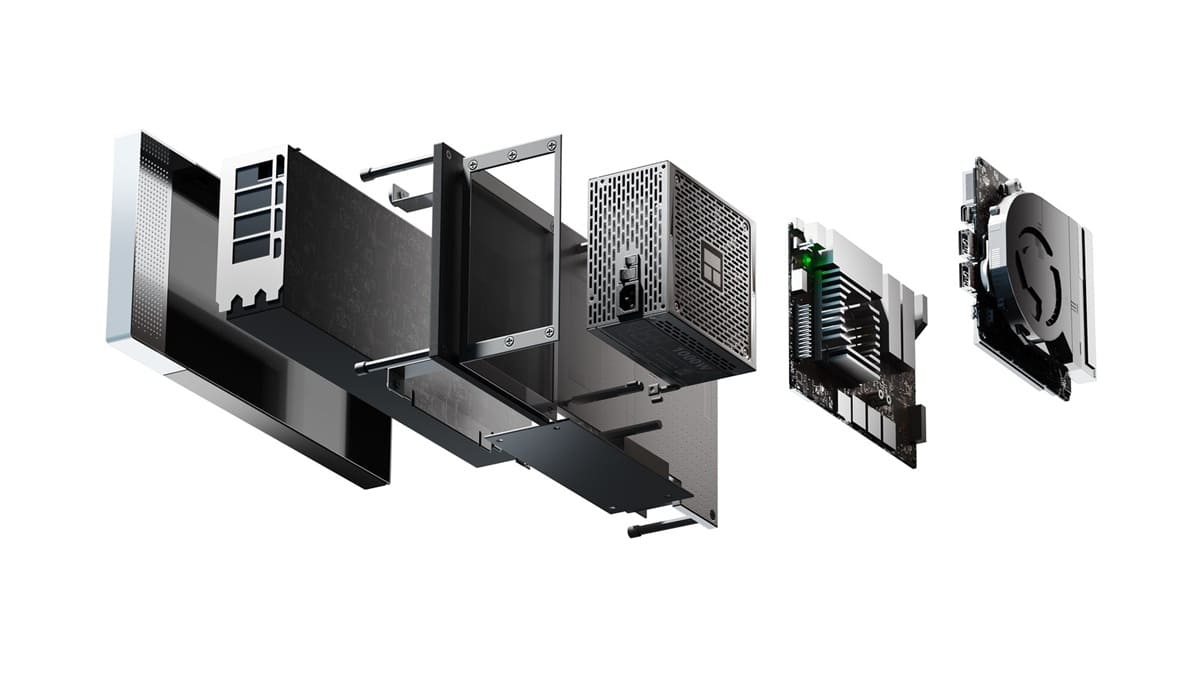
WiCi One integra CPU, GPU, almacenamiento y conectividad de red dentro de un único equipo, dejando que ordenadores menos potentes accedan remotamente a sus recursos gráficos.
- GeForce RTX 5060 Ti: 16 GB de memoria GDDR7, Intel Core 3 100U y SSD NVMe de 1 TB.
- GeForce RTX 5090: 32 GB de memoria GDDR7, Intel Core Ultra 7 255H y SSD NVMe de 4 TB.
Ambas versiones utilizan Wi-Fi 7 con configuración 4×4 MIMO y canales de hasta 320 MHz, acompañada por protocolos propios desarrollados por WiCi para transportar las cargas entre el dispositivo cliente y el sistema que aloja la GPU.
La principal diferencia frente a una eGPU tradicional está precisamente ahí: no existe un enlace directo mediante USB4, Thunderbolt u OCuLink. La comunicación depende de la red inalámbrica, lo que aporta mucha más flexibilidad física, pero también introduce nuevos desafíos de latencia y ancho de banda.
Driver Mode intenta presentar la GPU como si estuviera instalada localmente
Una de las funciones más ambiciosas es Driver Mode, mediante la cual WiCi One puede aparecer ante Windows, macOS y Linux como una GPU virtual disponible para el sistema.
Las aplicaciones envían sus cargas al WiCi One y la GPU remota realiza el procesamiento antes de devolver los resultados al dispositivo cliente. La compañía utiliza mecanismos de caché y repetición de trazas para intentar evitar transferencias innecesarias y reducir parte de la sobrecarga provocada por la red.
Este planteamiento podría permitir que un portátil ligero acceda a una RTX 5090 para determinadas cargas sin incorporar una GPU dedicada, algo especialmente interesante para equipos donde consumo, tamaño o refrigeración impiden instalar hardware gráfico potente.
La incógnita está en cuánto rendimiento se pierde realmente durante ese proceso. Hacer que una GPU remota aparezca como local resulta mucho más exigente que limitarse a transmitir una imagen, especialmente cuando la aplicación intercambia datos constantemente con la tarjeta gráfica.
El modo API está más orientado hacia la inteligencia artificial
WiCi One también dispone de API Mode, que expone un endpoint compatible con la API de OpenAI para que las aplicaciones puedan enviar directamente sus peticiones de inferencia al sistema.
Aquí la arquitectura resulta más sencilla conceptualmente: el modelo permanece ejecutándose dentro del WiCi One y el cliente únicamente envía las solicitudes y recibe las respuestas, reduciendo considerablemente la cantidad de información que necesita atravesar continuamente la red.
La compañía ofrece asimismo un SDK compatible con Python, JavaScript y Swift, permitiendo integrar directamente su capacidad de cálculo dentro de aplicaciones que necesiten inferencia local o procesamiento multimodal.
Para IA, este planteamiento puede resultar menos sensible a la latencia que intentar virtualizar una GPU completa, especialmente en tareas donde cada solicitud tarda mucho más en procesarse que el propio tiempo empleado en moverla por la red.
TurboStream utiliza el SSD como una capa adicional de memoria
La configuración con RTX 5090 incorpora una arquitectura que WiCi denomina Unified Hierarchical Memory, acompañada por su tecnología TurboStream para ejecutar modelos que superen ampliamente los 32 GB de memoria gráfica física.
La compañía describe este sistema como una forma de utilizar hasta 4 TB del SSD NVMe como memoria de trabajo adicional, pero no debe confundirse con ampliar literalmente la VRAM de la RTX 5090. TurboStream recurre a paginación de pesos entre almacenamiento, memoria del sistema y memoria gráfica según los datos que necesite el modelo.
La diferencia de velocidad entre ambas tecnologías sigue siendo enorme. Un SSD ofrece mucha más capacidad, pero un ancho de banda muy inferior y una latencia mucho mayor que la memoria GDDR7, de modo que el objetivo principal consiste en permitir la ejecución de modelos que de otra forma ni siquiera cabrían.
Esto convierte a TurboStream en una solución orientada a capacidad antes que a rendimiento máximo. Cuanto mayor sea la cantidad de información que deba entrar y salir continuamente del SSD, mayor será el impacto sobre la velocidad de inferencia.
WiCi muestra modelos de hasta billones de parámetros
La compañía asegura que la versión con RTX 5090 puede ejecutar Kimi K3 de 2,8 billones de parámetros a unos 5 tokens por segundo, mientras DeepSeek V4 Flash de 284.000 millones alcanzaría aproximadamente 20 tokens por segundo.
Para un modelo Gemma 4 de 26.000 millones de parámetros, WiCi anuncia más de 500 tokens por segundo, mostrando cómo la velocidad cambia drásticamente según el tamaño, arquitectura y cantidad de datos que deban mantenerse fuera de la VRAM física.
Estas cifras proceden por ahora de pruebas realizadas por la propia compañía, por lo que necesitarán validación independiente. El número de parámetros tampoco permite comparar directamente distintos modelos, ya que cuantización, arquitectura MoE, expertos activos o longitud de contexto pueden alterar enormemente los requisitos.
El aspecto técnicamente más interesante no está, por tanto, en una cifra aislada, sino en la posibilidad de ejecutar modelos mucho mayores que la memoria física de la GPU mediante una jerarquía de almacenamiento, aceptando la correspondiente penalización de rendimiento.
En juegos, la latencia será el factor decisivo
WiCi también ha mostrado Cyberpunk 2077 funcionando por encima de 100 FPS, planteando el dispositivo como una forma de ejecutar juegos exigentes desde ordenadores mucho menos potentes.
Sin embargo, los FPS generados por la RTX 5090 no describen por sí solos la experiencia final. El sistema debe procesar el juego, codificar la imagen, enviarla por Wi-Fi 7, decodificarla en el cliente y transportar en sentido contrario las entradas del jugador.
Cada una de esas etapas añade latencia, por lo que la calidad de la implementación y de la red doméstica será tan importante como la potencia de la GPU. Distancia, interferencias, congestión y configuración del router pueden modificar considerablemente el resultado.
Wi-Fi 7 proporciona un enlace mucho más rápido que generaciones anteriores, pero no convierte la conexión inalámbrica en PCIe local. Las pruebas independientes tendrán que determinar hasta qué punto los protocolos de WiCi consiguen ocultar esa diferencia en juegos y aplicaciones interactivas.
Su mayor ventaja puede estar en compartir una GPU entre varios equipos
El concepto resulta especialmente interesante cuando varios dispositivos necesitan potencia gráfica de forma ocasional, ya que permite centralizar una GPU costosa en lugar de instalar hardware equivalente en cada ordenador.
Un único WiCi One podría utilizarse para ejecutar IA desde un portátil, acelerar una aplicación creativa desde otro equipo o transmitir un juego, siempre que la plataforma sea capaz de gestionar correctamente los diferentes clientes y sus cargas.
La propuesta mezcla así características de una eGPU remota, un servidor local de IA y un sistema de streaming, pero sustituye el cableado directo por Wi-Fi 7. Esa flexibilidad constituye su principal atractivo y, al mismo tiempo, su mayor incógnita técnica.
Con un precio de 2.599 dólares (2.291€), reducido inicialmente a 1.999 dólares (1.762€), WiCi One necesitará demostrar que su capa inalámbrica no penaliza demasiado el rendimiento. La tecnología resulta prometedora sobre el papel, pero latencia, estabilidad y velocidad real serán las métricas que determinen si puede comportarse como una GPU verdaderamente compartida y no simplemente como otro servidor remoto dentro de casa.
Vía: Wccftech