Meta Muse ha reabierto el debate sobre el papel de las CPU en la infraestructura de inteligencia artificial. El nuevo agente personal de Meta funciona dentro de una máquina virtual dedicada y persistente con su propio navegador, capaz de continuar ejecutando tareas en segundo plano incluso cuando el usuario abandona la aplicación. Meta confirma oficialmente esta arquitectura, aunque no ha detallado públicamente todos los recursos físicos asignados a cada instancia.
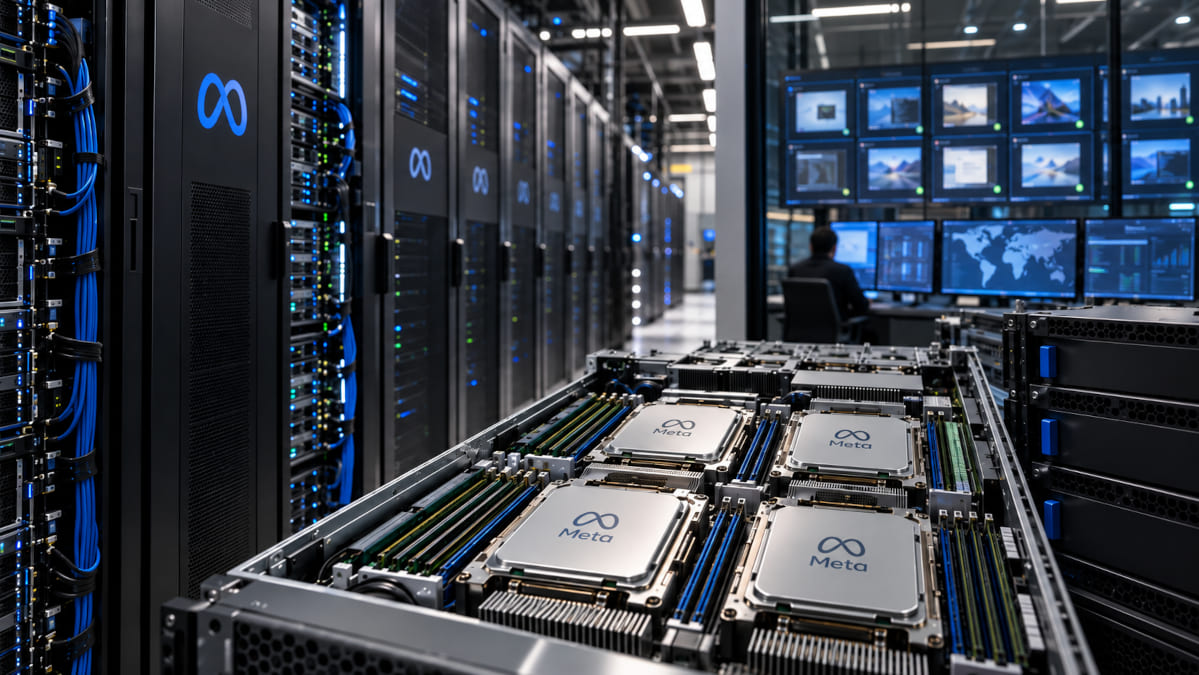
Un cálculo recogido por Wccftech, basado en estimaciones publicadas en X que atribuyen a cada VM 2 vCPU, 8 GB de RAM y 100 GB de almacenamiento, plantea qué ocurriría si Muse alcanzara 100 millones de usuarios. Bajo una asignación prácticamente directa y sin compartir apenas recursos, el resultado sería del orden de 1,58 millones de procesadores con 126 núcleos utilizables, 800 PB de RAM y 10.000 PB de almacenamiento. Son magnitudes teóricas, no previsiones de infraestructura comunicadas por Meta.
100 millones de usuarios equivaldrían a 200 millones de vCPU
La cuenta de CPU parte de una hipótesis sencilla. Si cada una de las 100 millones de máquinas virtuales dispone de 2 vCPU, serían necesarias 200 millones de vCPU lógicas. Dividiendo esa cifra entre 126 núcleos por procesador, como hace el cálculo original, aparecen aproximadamente 1,59 millones de CPU físicas si se presupone una relación prácticamente directa y ningún grado significativo de sobreasignación.
Pero esa no es una forma realista de dimensionar por sí sola un servicio cloud de esta escala. Una vCPU no equivale necesariamente a un núcleo físico reservado permanentemente, y los proveedores pueden compartir capacidad, aprovechar SMT, suspender máquinas inactivas y distribuir los picos de carga entre enormes grupos de servidores.
El texto original contiene además un error matemático al analizar la concurrencia. Con solo el 10% de 100 millones de usuarios ejecutando tareas simultáneamente, serían 20 millones de vCPU activas, equivalentes a unas 159.000 CPU de 126 núcleos, no 15,8 millones de procesadores. Con una utilización simultánea del 50%, la misma aproximación daría unas 794.000 CPU.
RAM y almacenamiento generan otro problema de escala
Las cifras de memoria son incluso más llamativas. Si realmente se reservaran 8 GB de RAM para cada una de 100 millones de VM, el espacio lógico asignado alcanzaría 800 millones de GB, es decir, aproximadamente 800 PB de RAM.
El almacenamiento es todavía mayor: 100 GB por instancia multiplicados por 100 millones de usuarios equivalen a 10.000 PB o 10 EB de capacidad lógica. Aquí la persistencia de Muse tiene especial importancia, porque cada VM conserva el entorno, las herramientas y los datos necesarios para que el agente pueda continuar trabajando entre sesiones. Meta confirma que la VM actúa como sistema de registro para la información y credenciales asociadas al agente.
Eso tampoco significa que Meta tenga que instalar físicamente 800 PB de DRAM y 10 EB de SSD desde el primer día. Memoria y almacenamiento pueden aprovisionarse dinámicamente, y una gran parte de las instancias podría permanecer suspendida durante largos periodos. El consumo físico dependerá mucho más de usuarios activos, tareas simultáneas y política de reserva de recursos que del número total de cuentas registradas.
Una VM dedicada no implica hardware dedicado
Este matiz cambia bastante la interpretación de las cifras. Meta describe Muse Secure VM como una máquina virtual dedicada y aislada para cada usuario, pero eso hace referencia principalmente al aislamiento del entorno, no a que exista un procesador, memoria física o SSD exclusivo detrás de cada cuenta.
De hecho, la virtualización existe precisamente para desacoplar esos dos niveles. Miles de VM pueden compartir grandes servidores físicos siempre que exista suficiente capacidad disponible cuando sus cargas se activan. La verdadera incógnita no es, por tanto, cuántas cuentas tenga Muse, sino qué porcentaje estará ejecutando simultáneamente navegadores, código, conectores y subagentes y durante cuánto tiempo.
Every Muse user is supposed to get their own cloud PC.
2 vCPUs, 8GB RAM, 100GB disk.If Meta actually leaves those boxes on, user growth turns into a chip and memory problem.
that’s what i’m trying to size
a few thoughts on $META and Muse:
Muse is 13 days old and US only… https://t.co/57wvCNGsIj
— dylan ツ (@demian_ai) September 21, 2026
Las inversiones de Meta sí muestran que la demanda de CPU es real
Aunque las cifras de 1,58 millones de procesadores sean una extrapolación, la tendencia subyacente tiene respaldo bastante más sólido. En abril, Meta anunció un acuerdo con AWS para incorporar decenas de millones de núcleos Graviton a su infraestructura, específicamente para cargas relacionadas con IA agéntica.
Un mes antes, Arm presentó su AGI CPU para centros de datos, desarrollado con Meta como socio principal y codesarrollador. Arm señala entre sus cargas objetivo la orquestación de agentes, gestión de aceleradores, servicios cloud y ejecución de aplicaciones alrededor de los modelos de IA.
La razón es que un agente como Muse hace bastante más que enviar una petición a un modelo. Tiene que manejar navegadores, ejecutar código, mover datos, utilizar APIs, gestionar procesos y coordinar múltiples tareas, trabajos que dependen fuertemente de CPU, aunque la inferencia de los grandes modelos continúe ejecutándose sobre aceleradores especializados.
Meta tampoco parece querer depender de una única arquitectura. La compañía está combinando Arm AGI CPU, decenas de millones de núcleos AWS Graviton y sus propios aceleradores MTIA, reforzando la idea de que la infraestructura para agentes requerirá una mezcla de CPU y aceleradores en lugar de una única clase de chip.
Muse no significa que las CPU vayan a sustituir a las GPU
El crecimiento de los agentes sí puede elevar considerablemente la demanda de procesadores, pero CPU y GPU resuelven partes diferentes de la carga. Los aceleradores siguen siendo fundamentales para entrenar y ejecutar modelos grandes, mientras las CPU se encargan de buena parte de la lógica, navegación, herramientas y coordinación que rodea esa inferencia. AWS describe precisamente esta división al explicar su acuerdo con Meta.
Por eso, los 100 millones de usuarios y 1,58 millones de CPU deben entenderse como un escenario extremo utilizado para visualizar la escala potencial, no como una previsión de compras de Meta. Lo significativo es que incluso compartiendo agresivamente recursos, millones de agentes persistentes introducen una nueva carga de CPU, memoria y almacenamiento que prácticamente no existía con los chatbots tradicionales.
Vía: Wccftech