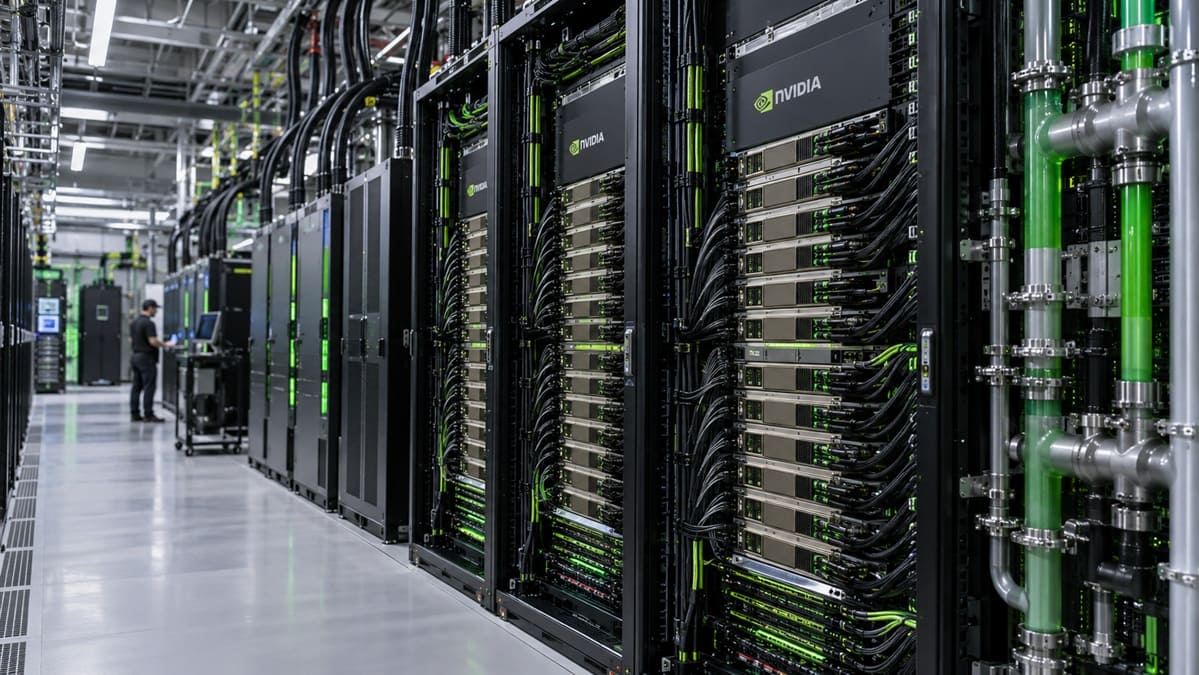
NVIDIA ha presentado nuevas cifras de eficiencia para su plataforma Vera Rubin y el sistema DSX MaxLPS, con el objetivo de aumentar la cantidad de trabajo de IA realizada sin ampliar la potencia eléctrica disponible. La compañía asegura que una infraestructura Vera Rubin NVL72 puede albergar hasta un 40% más de GPU y generar hasta un 35% más de tokens dentro del mismo presupuesto energético en determinados despliegues.
La propuesta combina hardware, refrigeración, gestión dinámica de potencia, redes y software de inferencia para tratar los tokens producidos por megavatio como una métrica central de los centros de datos de IA. NVIDIA ha acompañado sus proyecciones con una prueba realizada por Lambda sobre servidores Blackwell, además de nuevos resultados independientes y de partners con Vera CPU y Vera Rubin.
DSX MaxLPS redistribuye la potencia entre GPU y racks
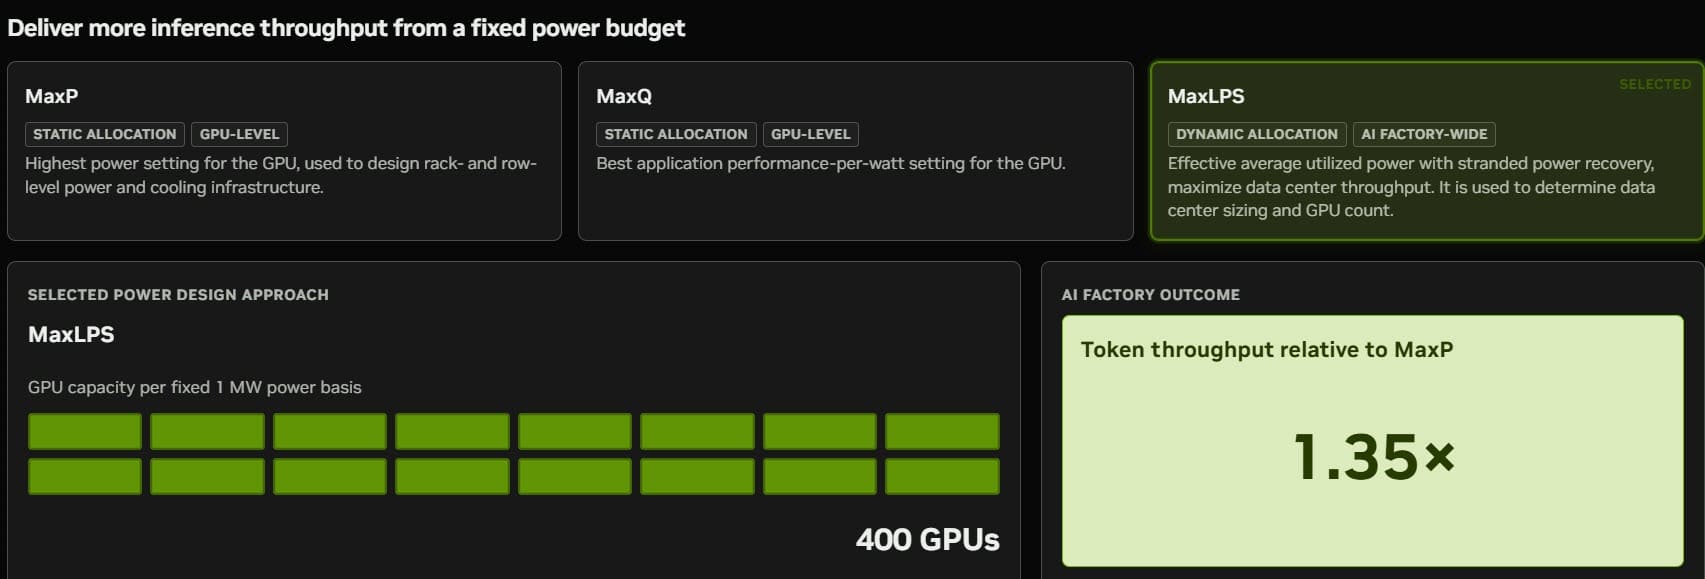
NVIDIA DSX MaxLPS está diseñado para aprovechar la potencia eléctrica que normalmente queda sin utilizar cuando cada GPU o rack se dimensiona para su consumo máximo teórico. El sistema monitoriza continuamente la demanda y redistribuye margen energético hacia los nodos que realmente lo necesitan.
La diferencia respecto a un perfil tradicional MaxP está en que MaxLPS gestiona el presupuesto energético a nivel de toda la fábrica de IA y no únicamente de una GPU individual. Esto permite instalar más aceleradores dentro de un límite fijo siempre que el consumo agregado permanezca dentro de la capacidad eléctrica disponible.
NVIDIA utiliza como referencia un escenario de inferencia Vera Rubin dentro de un presupuesto fijo donde MaxLPS puede proporcionar aproximadamente 1,35 veces el rendimiento en tokens frente a MaxP, aunque la propia documentación advierte de que Vera Rubin continúa en pruebas y que el resultado depende de las condiciones concretas del centro de datos.
El enfoque resulta especialmente relevante porque una GPU utilizada para inferencia no permanece necesariamente en su consumo máximo durante toda la carga, dejando margen que un sistema de asignación estática no puede aprovechar para añadir más capacidad.
Lambda logra un 24% más de tokens con el mismo presupuesto de potencia
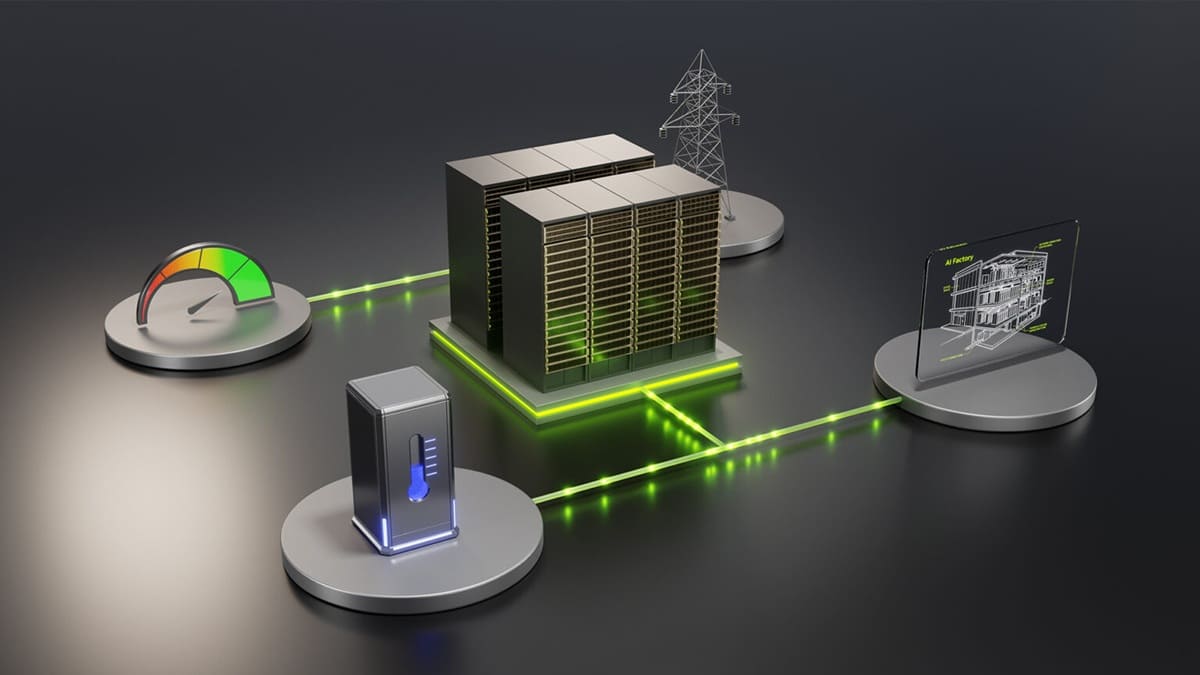
La primera validación publicada por Lambda utilizó 19 nodos dentro del mismo presupuesto energético normalmente reservado para 16 nodos funcionando a plena potencia, aplicando DSX MaxLPS sobre servidores NVIDIA Blackwell.
El resultado fue un aumento desde aproximadamente 4 millones hasta 5 millones de tokens por segundo en todo el clúster. Esto supone un 24% más de rendimiento agregado y una mejora del 23% en rendimiento por vatio, sin aumentar el presupuesto eléctrico disponible.
Esta prueba es importante porque el 24% corresponde a un despliegue real de Lambda sobre Blackwell y no a una proyección teórica de Vera Rubin. Conviene separarlo del 35% anunciado para la próxima generación, ya que las configuraciones, hardware y cargas utilizadas son diferentes.
NVIDIA extrapola este enfoque hacia Vera Rubin NVL72, donde considera posible instalar hasta un 40% más de GPU dentro del mismo límite energético en entornos adecuados, aunque ese porcentaje depende de refrigeración, carga, distribución eléctrica y planificación de la infraestructura.
Vera Rubin apunta a un 35% más de tokens sin nuevas líneas eléctricas
Dentro de su diseño completo de fábrica de IA, NVIDIA asegura que Vera Rubin, junto con DSX MaxLPS, puede elevar hasta un 35% el throughput de tokens manteniendo el mismo presupuesto eléctrico del emplazamiento.
La clave está en combinar la asignación dinámica de potencia con Intelligent Power Smoothing y sistemas de almacenamiento energético capaces de absorber picos breves, evitando reservar de forma permanente capacidad eléctrica para situaciones que solo aparecen durante pequeños intervalos.
En la práctica, el objetivo es convertir margen eléctrico desperdiciado en capacidad de cálculo. NVIDIA intenta que un centro de datos produzca más tokens sin instalar nuevas líneas de alimentación ni ampliar necesariamente su potencia contratada, algo especialmente importante en ubicaciones donde la red eléctrica ya se encuentra cerca de su límite.
Esto no significa que cualquier centro de datos vaya a obtener automáticamente un 35% adicional. La propia NVIDIA condiciona estas cifras a despliegues adecuados y a cargas donde exista suficiente margen entre consumo medio y consumo máximo, por lo que los resultados reales pueden variar considerablemente.
Vera Rubin y Groq 3 LPX elevan aún más el rendimiento en cargas de IA agéntica
NVIDIA también ha mostrado una combinación de Vera Rubin NVL72 con Groq 3 LPX destinada a inferencia de latencia extremadamente baja, especialmente pensada para agentes que realizan múltiples pasos de razonamiento y llamadas a herramientas.
En modelos con más de 2 billones de parámetros y contextos largos, la compañía habla de hasta 35 veces más tokens por megavatio frente a GB200 NVL72. Esta comparación corresponde a una configuración y carga muy concretas, por lo que no representa una mejora general de 35× para cualquier modelo de IA.
Como referencia adicional, Groq 3 LPX alcanzó 2.529 tokens de salida por segundo y usuario con Qwen 3.8 27B utilizando un contexto de 100.000 tokens, una cifra orientada especialmente a cargas donde la latencia del agente condiciona la cantidad de razonamiento que puede realizar.
La idea de NVIDIA es que la métrica relevante deje de ser únicamente la potencia máxima de cómputo y pase a medir cuánto trabajo útil de IA puede producirse por unidad de energía, especialmente cuando la electricidad se convierte en el principal cuello de botella.
Vera Rubin alcanza 30 veces más throughput por megavatio en AgentX
SemiAnalysis también ha publicado resultados mediante AgentX, un benchmark que intenta reproducir sesiones reales de programación agéntica con crecimiento de contexto, llamadas a herramientas y ejecución de subagentes, en lugar de medir únicamente consultas aisladas.
Sobre DeepSeek V4 Pro, Vera Rubin NVL72 alcanzó hasta 30 veces más throughput por megavatio que GB300 NVL72, acompañado por una reducción de hasta 45 veces en el coste por millón de tokens según los resultados presentados.
La comparación debe interpretarse dentro de AgentX y de esa carga concreta. Un resultado 30× superior en IA agéntica no significa que Vera Rubin sea 30 veces más rápida que Blackwell en cualquier tarea, ya que entran en juego precisión numérica, contexto, paralelismo y optimizaciones de software específicas.
NVIDIA atribuye buena parte de la mejora a NVLink de sexta generación, Tensor Cores de quinta generación con NVFP4, TensorRT LLM y Dynamo, reforzando su estrategia de optimizar la plataforma completa en lugar de depender únicamente del rendimiento de los chips.
Vera CPU también muestra ventajas en pruebas de varios partners
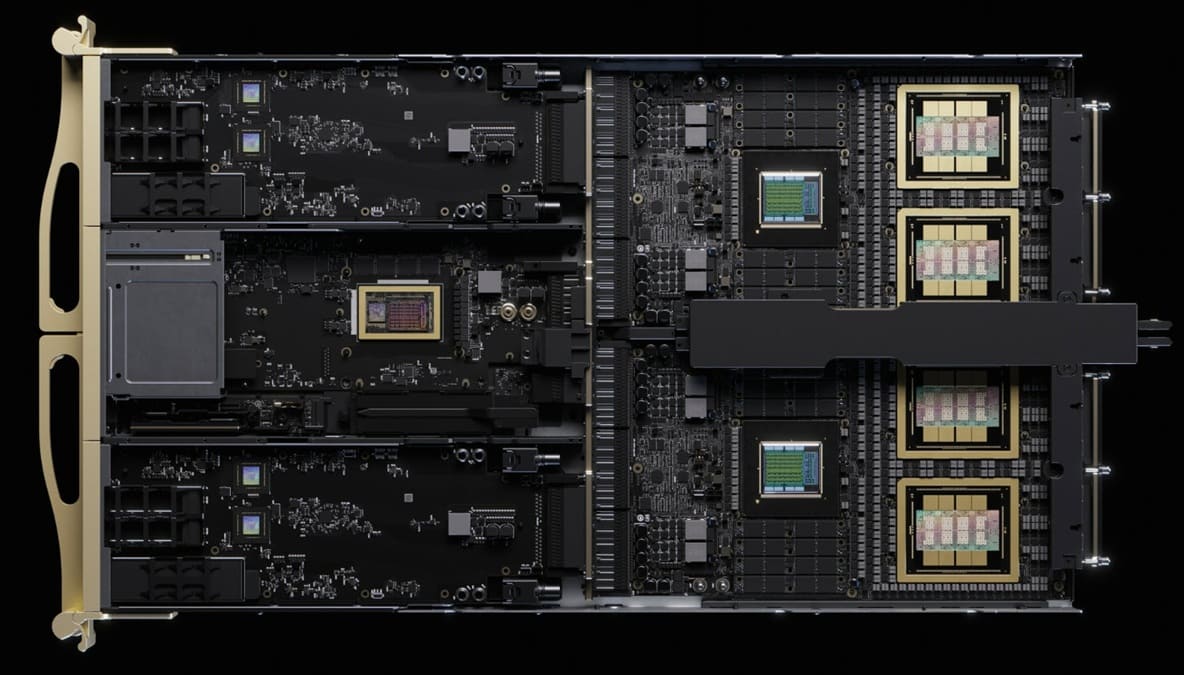
Los resultados publicados por diferentes compañías muestran igualmente mejoras importantes para Vera CPU en cargas de agentes, bases de datos y procesamiento intensivo de información, aunque cada benchmark utiliza software y sistemas de comparación distintos.
Perplexity obtuvo arranques de sandbox 1,9 veces más rápidos para su plataforma SPACE, mientras DeepInfra informó de una latencia de orquestación hasta 2,2 veces menor en sus pruebas.
Redpanda midió hasta 5,5 veces menos latencia y un 73% más de throughput frente a AMD EPYC Turin en sus cargas de streaming, mientras Starburst habló de un throughput de consultas 3 veces superior y Kinetica de hasta 2,7 veces más rendimiento analítico.
Estas cifras no son directamente comparables entre sí porque proceden de aplicaciones, rivales y metodologías diferentes, pero muestran el tipo de cargas de CPU que NVIDIA está intentando atraer hacia Vera, además del procesamiento puramente gráfico.
NVIDIA quiere medir los centros de datos por tokens producidos y no solo por FLOPS
El mensaje de NVIDIA durante el AI Infra Summit es que la electricidad disponible se está convirtiendo en un recurso tan importante como la propia capacidad de cómputo, especialmente a medida que los centros de datos escalan hacia decenas o cientos de miles de aceleradores.
La compañía quiere que sus futuras fábricas de IA se evalúen mediante tokens validados por megavatio, coste por token, utilización y capacidad de mantener cargas prioritarias, en lugar de fijarse exclusivamente en el rendimiento máximo teórico.
Vera Rubin es solo una parte de ese planteamiento. DSX MaxLPS, Dynamo, NVLink, Spectrum-X, BlueField y el control dinámico de potencia forman una arquitectura diseñada para aprovechar mejor cada megavatio disponible, especialmente cuando ampliar la conexión eléctrica de un centro de datos puede tardar años.
Los resultados de Lambda aportan por ahora una de las pruebas más concretas del enfoque: un 24% más de tokens dentro del mismo presupuesto energético y un 23% más de rendimiento por vatio. Las cifras superiores asociadas a Vera Rubin deberán validarse a medida que la plataforma llegue a más despliegues comerciales.
Vía: Wccftech