Reflection AI ha dado a conocer Beam, un modelo de pesos abiertos basado en una arquitectura Mixture of Experts con 501.000 millones de parámetros totales y 23.000 millones activos por token. Está orientado especialmente a programación, razonamiento y cargas con agentes, con una estrategia centrada en competir mediante eficiencia frente a modelos como GLM-5.2.
La compañía asegura que Reflection Beam ofrece resultados comparables a GLM-5.2 utilizando entre tres y cuatro veces menos cálculo durante la inferencia. Esa afirmación necesita contexto, porque se basa en una estimación de FLOPS relacionada con parámetros activos y longitud de las respuestas, no en una medición independiente de consumo eléctrico, coste por token o infraestructura necesaria.
Reflection Beam utiliza menos del 5% de sus parámetros en cada token
Los 23.000 millones de parámetros activos representan aproximadamente un 4,6% de los 501.000 millones totales. La arquitectura MoE permite mantener numerosos expertos especializados dentro del modelo mientras solamente una pequeña parte participa en el procesamiento de cada token.
Esto permite disponer de una capacidad total enorme sin ejecutar 501.000 millones de parámetros en cada paso de inferencia. El tamaño completo continúa condicionando almacenamiento y memoria necesaria para alojar el modelo, pero el coste computacional por token depende mucho más de los expertos realmente activados.
Reflection también intenta evitar que determinados expertos reciban una cantidad desproporcionada de trabajo. Según sus propios datos, el experto más utilizado terminó con solo 1,04 veces la carga media, una distribución muy equilibrada que ayuda a reducir cuellos de botella internos y aprovechar mejor la capacidad disponible.
Introducing Beam: a highly efficient agentic open model with 501B total parameters and 23B active.
– Frontier reasoning efficiency
– Advances the Western open frontier on coding & agentic tasks
– Trained end-to-end from scratchFull weights release this month.
Learn more about Beam: https://t.co/c3Qx2cpM8G
— Reflection (@reflection_ai) October 5, 2026
La ventaja frente a GLM-5.2 todavía necesita pruebas independientes
Reflection afirma que Beam consigue entre tres y cuatro veces mayor eficiencia de inferencia que GLM-5.2, además de superar por más de cuatro veces a algunos modelos occidentales de pesos abiertos. La compañía calcula aproximadamente el coste mediante parámetros activos y número de tokens generados.
Esa metodología no captura por completo el coste del prefill, la atención con contextos largos, la comunicación entre expertos o la eficiencia real del motor de inferencia. Tampoco permite convertir directamente esa ventaja teórica en una reducción equivalente de GPU, vatios o dinero, por lo que habrá que esperar a comparativas realizadas bajo la misma infraestructura.
Reflection utilizó 10.500 GPU NVIDIA GB300 durante el aprendizaje por refuerzo
La eficiencia durante la ejecución no significa que Beam haya sido barato de desarrollar. Reflection afirma haber utilizado 10.500 GPU NVIDIA GB300 durante cuatro semanas para una fase de aprendizaje por refuerzo a gran escala, generando más de 100 millones de rollouts.
El proceso empleó aproximadamente 1.300 millones de sandboxes, repartidos entre cerca de un millón de entornos de programación, tareas con agentes y problemas STEM. La infraestructura mantuvo alrededor de 110.000 rollouts simultáneos de media, con picos considerablemente superiores.
Antes de esa etapa, Beam había sido preentrenado con 23,8 billones de tokens utilizando 6.144 GPU NVIDIA GB300 NVL72 durante menos de cuatro semanas. Reflection asegura además que aproximadamente el 95% de los datos brutos recopilados de Internet fueron descartados mediante filtrado, deduplicación y selección de calidad.
Estas cifras muestran una diferencia importante entre eficiencia de inferencia y eficiencia total del ciclo de desarrollo. Beam puede requerir mucho menos cálculo por respuesta que un modelo denso comparable mientras su entrenamiento continúa necesitando una infraestructura extraordinariamente grande.
1.3 billion sandboxes over 4 weeks, huh. That’s 48,46M sandboxes/day. At DeepSeek, one DSec scale unit does 3M, so would need 16 units, or roughly 656 GB300s/unit (DeepSeek likely uses ≤128 GB300-equivalents though).
A big project. A hint of how it’s done at the frontier. https://t.co/CaQgrLlfAQ— Teortaxes▶️ (DeepSeek 推特🐋铁粉 2023 – ∞) (@teortaxesTex) October 5, 2026
Beam intenta generar respuestas más útiles con menos tokens
Reflection no se ha limitado a reducir el número de parámetros activos. Durante el aprendizaje por refuerzo aplicó una penalización controlable sobre la longitud de las respuestas, recompensando soluciones correctas mientras penalizaba tokens que no aportaban valor.
Según la compañía, durante las primeras fases del entrenamiento el rendimiento aumentó al mismo tiempo que disminuía la longitud media de las respuestas. Más adelante, cuando Beam comenzó a desarrollar capacidades más complejas como agente, las respuestas volvieron a crecer porque necesitaba más pasos para resolver determinadas tareas.
Este enfoque ayuda a explicar parte de la eficiencia anunciada. Un modelo que activa menos parámetros y además necesita menos tokens para llegar a la solución reduce el cálculo por consulta desde dos frentes distintos, aunque esa ventaja dependerá mucho del tipo de tarea.
El entrenamiento asíncrono evita detener las GPU continuamente
Reflection también separó los trabajadores que generan respuestas de los sistemas encargados de actualizar los pesos. En un esquema convencional, parte de la infraestructura puede permanecer esperando mientras se actualiza el modelo antes de continuar generando nuevas experiencias.
Beam permite que ambos procesos funcionen simultáneamente, aumentando la utilización efectiva de las GPU. El inconveniente es que algunos rollouts pueden haberse generado con una versión anterior del modelo cuando los sistemas de aprendizaje comienzan a utilizarlos.
Ese desfase introduce lo que se conoce como policy staleness, una diferencia entre la política que produjo los datos y la versión que posteriormente aprende de ellos. Reflection afirma haber mantenido estable el entrenamiento incluso con muestras procedentes de hasta 107 versiones anteriores de los pesos.
Para evitar inestabilidad, Beam combina técnicas como SandwichNorm, attention gating, escalado residual según la profundidad y acumulación residual FP32. El objetivo común es controlar activaciones y errores numéricos para que la velocidad adicional del entrenamiento asíncrono no termine degradando la convergencia.
Los pesos serán la prueba definitiva de las cifras de Reflection
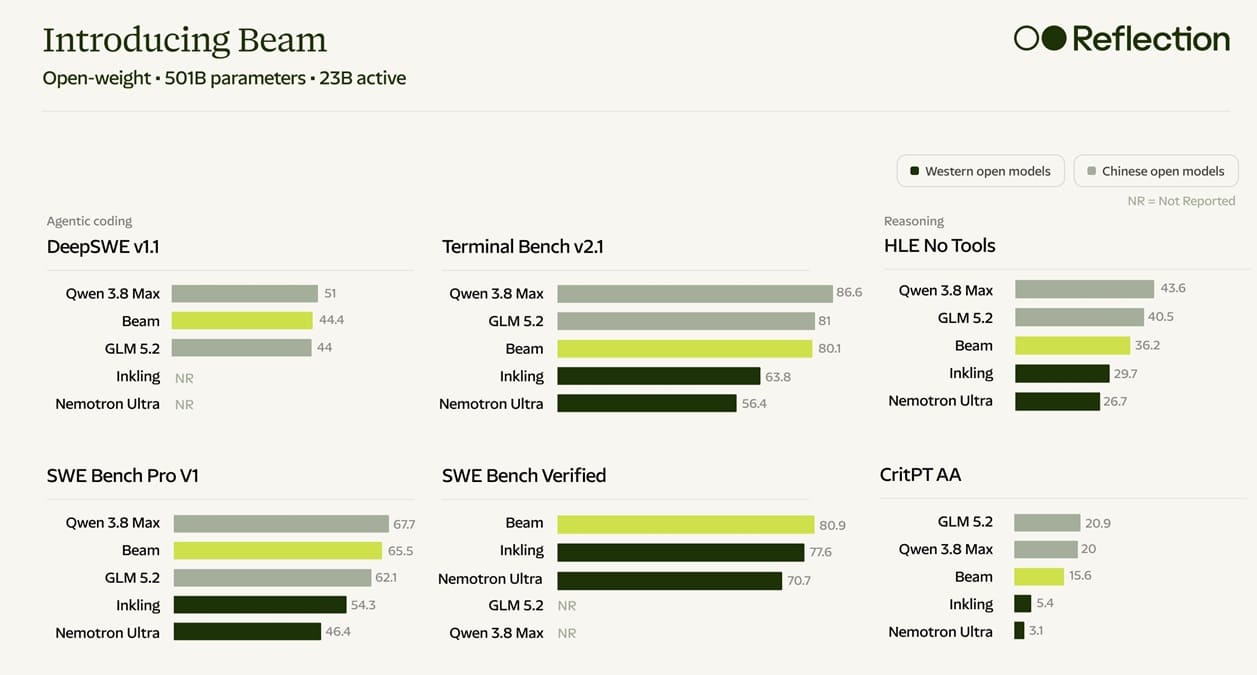
Reflection publica resultados como 80,9 puntos en SWE-Bench Verified y 80,1 en Terminal-Bench 2.1, colocando a Beam cerca de GLM-5.2 en distintas pruebas. Otros modelos siguen por delante en determinados escenarios, por lo que su principal argumento no es necesariamente liderar todos los benchmarks, sino ofrecer una relación rendimiento/cálculo especialmente agresiva.
La compañía prevé publicar los pesos de Beam bajo licencia Apache 2.0, además de documentación técnica, herramientas de evaluación y variantes cuantizadas. Cuando terceros puedan ejecutarlo sobre la misma infraestructura que otros modelos MoE, será posible comprobar si los 23.000 millones de parámetros activos se traducen realmente en menores costes operativos.
Vía: Wccftech