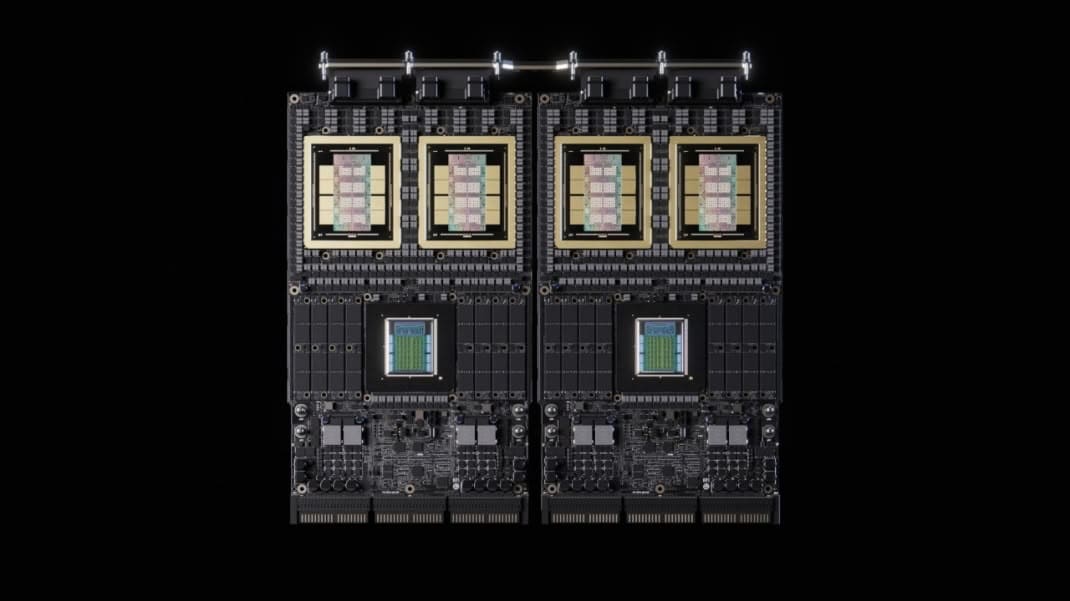
NVIDIA ha revisado a la baja las especificaciones de Vera Rubin, su plataforma de aceleración para inteligencia artificial, reduciendo tanto la velocidad de la memoria HBM4 como el ancho de banda de la interconexión NVLink. La actualización establece una velocidad de 9,6 Gbps por pin para la memoria HBM4, frente a los 11,7 Gbps anunciados anteriormente, mientras NVLink también experimenta una reducción de aproximadamente el 17%.
Los cambios afectan a dos componentes fundamentales para el funcionamiento de los sistemas de IA a gran escala: el acceso de las GPU a su propia memoria y la comunicación entre aceleradores. Como consecuencia, la configuración Vera Rubin NVL72 presenta cifras inferiores a las previstas inicialmente, mientras AMD Helios, basada en las Instinct MI455X, pasa a ofrecer mayor capacidad de memoria y ancho de banda teórico.
La memoria HBM4 baja de 11,7 a 9,6 Gbps por pin
La primera modificación afecta a la velocidad de transferencia de la memoria HBM4 utilizada por las GPU Rubin. NVIDIA ha reducido su objetivo de 11,7 a 9,6 Gbps por pin, lo que representa una disminución aproximada del 18% respecto a las especificaciones originales.
En la configuración Vera Rubin NVL72, equipada con 72 aceleradores, el ancho de banda agregado de memoria pasa de 1.580 a 1.400 TB/s, una reducción cercana al 11,4%. Aunque ambas cifras siguen siendo muy elevadas, la diferencia resulta importante para una plataforma diseñada específicamente para ejecutar modelos de inteligencia artificial de gran tamaño.
La reducción de velocidad por pin no coincide exactamente con la disminución porcentual del ancho de banda agregado anunciado. Esto impide atribuir toda la diferencia a un único parámetro sin conocer los detalles completos de la configuración de memoria, incluida la implementación de sus conexiones y las condiciones utilizadas para establecer las especificaciones.
La capacidad permanece en 288 GB de HBM4 por GPU, por lo que no estamos ante una reducción de memoria disponible, sino de su velocidad de transferencia. Esta distinción resulta relevante porque la capacidad determina cuántos datos pueden mantenerse residentes, mientras el ancho de banda condiciona la rapidez con la que pueden procesarse determinadas cargas.
NVLink reduce su ancho de banda bidireccional a 3 TB/s por GPU
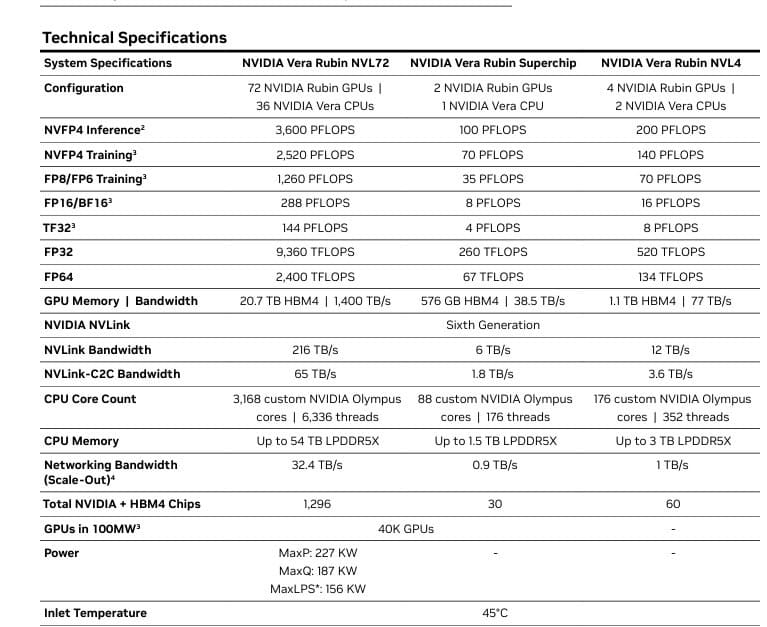
La segunda modificación afecta a NVLink, la interconexión que permite intercambiar información entre los aceleradores de una misma plataforma. Su ancho de banda unidireccional disminuye de 1,8 a 1,5 TB/s por GPU, mientras la capacidad bidireccional pasa de 3,6 a 3 TB/s.
En ambos casos, la reducción alcanza aproximadamente el 16,7%. Esta diferencia puede resultar relevante en tareas de entrenamiento distribuido o inferencia con modelos repartidos entre numerosos aceleradores, donde la comunicación interna influye en el tiempo necesario para completar determinadas operaciones.
La información original relaciona el ajuste con las exigencias de integridad de señal de las conexiones de alta velocidad. En concreto, señala una reducción de la frecuencia objetivo de Nyquist de 56 a 47 GHz, equivalente a aproximadamente un 16%.
Disminuir esta frecuencia reduce las exigencias eléctricas sobre los circuitos SerDes, el cableado y los materiales utilizados, lo que puede facilitar el diseño y la validación de las conexiones. Sin embargo, NVIDIA no ha detallado oficialmente la causa del cambio, por lo que no puede asegurarse que se deba a problemas concretos de estabilidad o fabricación.
Menores exigencias eléctricas a cambio de ancho de banda
En sistemas que conectan decenas de aceleradores, mantener una señal estable a velocidades extremadamente elevadas representa un desafío técnico. A medida que aumenta la frecuencia, factores como las pérdidas eléctricas, las interferencias y las características de los materiales adquieren mayor importancia.
Por este motivo, reducir la velocidad de transmisión puede aumentar los márgenes de funcionamiento del sistema. También puede facilitar la validación de componentes, aunque las especificaciones revisadas no permiten determinar si NVIDIA ha tomado esta decisión para mejorar la fiabilidad, aumentar la producción o resolver alguna limitación específica.
El cambio plantea un compromiso técnico claro: menor ancho de banda máximo a cambio de unas condiciones de señalización menos exigentes. Esto no significa necesariamente que el rendimiento de las aplicaciones disminuya en la misma proporción, porque no todas utilizan constantemente la capacidad máxima de comunicación.
Algo similar ocurre con la memoria HBM4. Una aplicación limitada por cálculo puede verse menos afectada que otra dependiente del acceso continuo a grandes volúmenes de datos. Sin benchmarks comparativos de las dos configuraciones, no es posible cuantificar el impacto real de los ajustes.
AMD Helios supera a Vera Rubin en capacidad y ancho de banda teórico
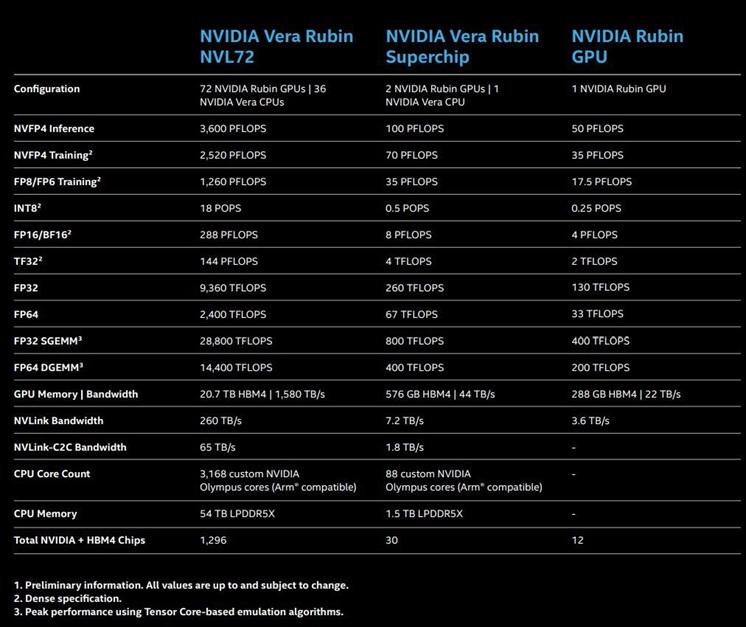
Tras la revisión, AMD Instinct MI455X presenta especificaciones superiores a Rubin en varios apartados relacionados con la memoria. Cada acelerador de AMD incorpora 432 GB de HBM4 y 23,3 TB/s de ancho de banda, frente a los 288 GB y 19,2 TB/s de NVIDIA.
Esto supone un 50% más de capacidad de memoria y aproximadamente un 21% más de ancho de banda por GPU. La diferencia de capacidad puede resultar especialmente interesante para modelos de gran tamaño, mientras el mayor ancho de banda ofrece un margen adicional en aplicaciones que necesitan mover datos constantemente.
| Característica | NVIDIA Rubin | AMD MI455X |
|---|---|---|
| Memoria HBM4 por GPU | 288 GB | 432 GB |
| Ancho de banda por GPU | 19,2 TB/s | 23,3 TB/s |
| HBM4 en configuración de 72 GPU | 20,7 TB | 31,1 TB |
| Ancho de banda HBM4 agregado | 1,4 PB/s | 1,67 PB/s |
| Interconexión bidireccional por GPU | 3 TB/s | 3,6 TB/s |
| Interconexión agregada | 216 TB/s | 260 TB/s |
En una configuración de 72 GPU, AMD Helios alcanza aproximadamente 31 TB de memoria HBM4, frente a los 20,7 TB de Vera Rubin NVL72. El ancho de banda agregado también favorece a AMD, con unos 1,67 PB/s frente a 1,4 PB/s.
La ventaja continúa en la interconexión. UALoE ofrece 3,6 TB/s bidireccionales por GPU, frente a los 3 TB/s de NVLink. Al considerar los 72 aceleradores, las cifras ascienden a unos 260 TB/s para AMD y 216 TB/s para NVIDIA.
Las especificaciones no determinan por sí solas el rendimiento real
Aunque AMD presenta una ventaja cuantificable en capacidad y ancho de banda, estos parámetros no bastan para determinar qué plataforma será más rápida al ejecutar modelos de inteligencia artificial. El resultado también depende de la arquitectura de los aceleradores, sus capacidades de cálculo y la forma en que el software distribuye las operaciones.
Por ejemplo, una mayor capacidad de HBM4 permite alojar más datos por acelerador, lo que podría reducir la necesidad de distribuir determinados modelos entre varias GPU. Sin embargo, esa ventaja dependerá del tamaño del modelo, su precisión numérica y los requisitos de memoria durante la ejecución.
El ancho de banda de interconexión resulta especialmente relevante cuando los aceleradores necesitan intercambiar información de manera frecuente. En cargas que realizan menos comunicaciones o dedican más tiempo al cálculo local, disponer de una conexión más rápida no garantiza una mejora proporcional.
Por tanto, los recortes anunciados por NVIDIA representan una pérdida objetiva de ancho de banda respecto a las especificaciones originales, pero todavía no permiten calcular cuánto rendimiento real podría perder Vera Rubin. Tampoco demuestran automáticamente que Helios vaya a superar a la plataforma de NVIDIA en todas las tareas.
La actualización deja una conclusión técnica importante: NVIDIA ha rebajado sus objetivos de velocidad para HBM4 y NVLink, mientras AMD Helios conserva una ventaja sobre el papel en capacidad de memoria e interconexión. La comparación definitiva dependerá de pruebas independientes realizadas con cargas equivalentes, especialmente en entrenamiento e inferencia de modelos de gran tamaño.
Vía: TechPowerUp