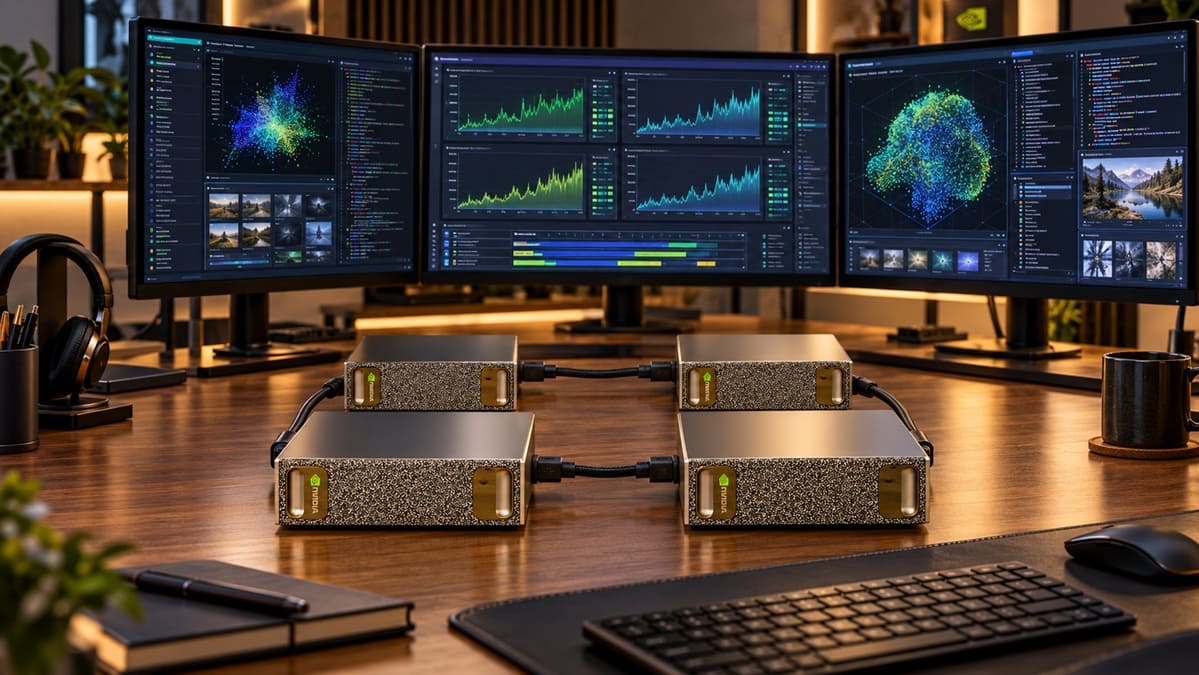
Un clúster doméstico formado por cuatro NVIDIA DGX Spark ha conseguido ejecutar localmente DeepSeek V4.1-Flash, un modelo MoE de 552.000 millones de parámetros, alcanzando un pico agregado de 494 tokens/s. El sistema pertenece al analista Patrick Moorhead y utiliza conexiones directas entre los cuatro equipos, sin recurrir a un switch Ethernet externo.
La cifra resulta llamativa, pero necesita contexto: esos 494 tokens/s corresponden a código con 32 peticiones simultáneas, no a la velocidad obtenida por un único usuario. Con una sola petición, el sistema registra aproximadamente 96 tokens/s en código y 58 tokens/s en prosa, cifras mucho más representativas de la experiencia interactiva individual.
Cuatro DGX Spark proporcionan 512 GB de capacidad de memoria
Cada DGX Spark integra el SoC GB10 Grace Blackwell, con una CPU Arm de 20 núcleos, GPU Blackwell y 128 GB LPDDR5X de memoria unificada coherente sobre una interfaz de 256 bits. El ancho de banda alcanza 273 GB/s y el chip ofrece hasta 1 PFLOP FP4 utilizando dispersión.
Al juntar cuatro sistemas, aparecen 512 GB de capacidad física total, suficiente para alojar los aproximadamente 476 GB utilizados por DeepSeek V4.1-Flash en esta configuración. No debe interpretarse, sin embargo, como un único bloque de 512 GB con coherencia de memoria entre todos los nodos: el modelo está distribuido entre cuatro máquinas independientes comunicadas mediante red.
Esa diferencia importa porque acceder a la memoria de otro DGX Spark resulta muchísimo más lento que utilizar la LPDDR5X local. El rendimiento depende, por tanto, de cómo se dividan pesos y operaciones entre nodos, intentando mantener local la mayor cantidad posible de trabajo y reduciendo las transferencias a través de ConnectX-7.
Además, los 476 GB dejan relativamente poco margen sobre los 512 GB disponibles, por lo que la eficiencia de DeepSeek V4.1-Flash resulta fundamental. Un modelo menos comprimido o con una caché KV considerablemente mayor podría necesitar más memoria o reducir el tamaño de los contextos y lotes utilizados.
DeepSeek V4.1-Flash activa solo una fracción de sus 552.000 millones de parámetros
La capacidad para mover un modelo tan grande se explica en gran medida por su arquitectura. DeepSeek V4.1-Flash utiliza Mixture-of-Experts y suma 552.000 millones de parámetros, pero no activa todos para procesar cada token.
Su nueva arquitectura Causal Encoder-Decoder activa aproximadamente 8.000 millones de parámetros durante la entrada y 16.000 millones durante la generación. Esto reduce enormemente la cantidad de cálculo necesaria por token frente a un modelo denso de tamaño equivalente.
DeepSeek también emplea Compressed Sparse Attention 2, cuantización FP4 y SWA Bounded Replay, entre otras optimizaciones. La compañía cifra la caché KV global en apenas 890 bytes por token, alrededor de una cuarta parte de la generación anterior, mientras el almacenamiento persistente de esa caché se reduce aproximadamente ocho veces.
Ese diseño es especialmente adecuado para hardware como DGX Spark. El gran tamaño total del modelo exige mucha memoria, pero la baja cantidad de parámetros activos reduce el cálculo efectivo necesario durante cada paso, permitiendo obtener velocidades que serían inviables con un modelo denso de 552.000 millones de parámetros.
Los 494 tokens/s miden rendimiento agregado con 32 peticiones
El resultado máximo comunicado es de 494 tokens/s generando código con 32 solicitudes concurrentes, mientras la prueba equivalente en prosa alcanza alrededor de 280 tokens/s. Esto mide principalmente la capacidad total del clúster para atender varias peticiones simultáneamente.
Cuando se ejecuta una única solicitud, las cifras bajan hasta aproximadamente 96 tokens/s para código y 58 tokens/s para prosa. Es una diferencia fundamental: throughput y velocidad por usuario miden comportamientos distintos, y utilizar únicamente el resultado de 494 tokens/s daría una impresión exagerada del rendimiento interactivo.
El procesamiento de entrada alcanza aproximadamente 4.764 tokens/s, mientras el tiempo hasta generar el primer token se sitúa alrededor de 0,2 segundos con el sistema inactivo. Para cargas de agentes, análisis de grandes documentos o servidores locales con varios usuarios, el rendimiento agregado tiene bastante más importancia que en un chatbot utilizado por una sola persona.
Por eso, comparar directamente los 494 tokens/s con sistemas como Cerebras tampoco permite concluir que cuatro DGX Spark tengan un rendimiento computacional equivalente. Son arquitecturas, configuraciones de concurrencia y sistemas de memoria radicalmente diferentes; el resultado demuestra sobre todo lo lejos que puede llegar un clúster local bien optimizado con este modelo concreto.
Los cuatro nodos están conectados directamente en forma de anillo
Moorhead no utiliza un switch externo. Los cuatro DGX Spark aprovechan sus interfaces ConnectX-7 y conexiones QSFP para crear una topología en anillo donde cada equipo está enlazado directamente con sus dos vecinos.
La configuración evita el coste de un switch de 200 Gb/s, pero introduce diferencias frente a una topología en estrella. Cuando dos nodos no son vecinos directos, determinados datos pueden necesitar atravesar otro sistema, aumentando latencia y ocupando parte del ancho de banda disponible.
En inferencia distribuida, la importancia de esta penalización depende de cuánto tenga que comunicarse cada nodo durante cada token. Si el software consigue mantener las operaciones bien particionadas y reducir sincronizaciones, una topología directa puede ofrecer un equilibrio muy interesante entre coste y rendimiento.
DeepSeek V4.1 Flash on 4 x Sparks with no optical router. Deets in the photos. https://t.co/OWbfkJy2HO
— Patrick Moorhead (@PatrickMoorhead) October 5, 2026
El consumo real está muy lejos de 400 o 600W por DGX Spark
Hay además un error importante en algunas informaciones sobre esta prueba. NVIDIA especifica para cada DGX Spark una fuente de alimentación de 240W y un TDP de 140W para el GB10, por lo que no puede consumir entre 400 y 600W individualmente como se ha llegado a indicar.
Incluso tomando el límite completo de las cuatro fuentes, el clúster estaría limitado a menos de 1.000W únicamente para los cuatro DGX Spark, antes de considerar ventiladores adicionales y otros elementos externos. El consumo real durante inferencia dependerá de CPU, GPU, red y almacenamiento, pero permanece muy lejos de 400-600W por nodo.
Esto mejora bastante la lectura económica frente a un servidor tradicional con varias GPU de centro de datos. El coste inicial es elevado, pero la potencia eléctrica necesaria sigue siendo razonable para una instalación local, especialmente si el sistema va a trabajar de forma continua.
Cuatro unidades cuestan decenas de miles de euros
La economía sigue siendo el gran obstáculo. Los DGX Spark de 128 GB se están vendiendo actualmente alrededor de 7.000-9.000 dólares según configuración y disponibilidad, por lo que cuatro unidades pueden representar aproximadamente 28.000-36.000 dólares (24.954-32.083€) únicamente en hardware principal.
A eso hay que añadir cables QSFP, rack, ventilación y distribución eléctrica, aunque evitar el switch de alta velocidad reduce considerablemente uno de los gastos adicionales posibles. No es una configuración doméstica asequible, sino una pequeña infraestructura profesional que físicamente puede instalarse fuera de un centro de datos.
Su ventaja está en otro punto: los datos y el modelo permanecen en infraestructura propia, no existen costes por token de una API externa y el equipo puede utilizarse continuamente para inferencia, desarrollo o cargas privadas. La rentabilidad dependerá por completo del volumen de uso y de cuánto valore cada organización mantener sus datos fuera de servicios externos.
El experimento demuestra sobre todo que la IA local ya puede escalar mucho más allá de un único PC. Cuatro equipos de escritorio con GB10 consiguen mantener en memoria un modelo de 552.000 millones de parámetros y atender decenas de solicitudes simultáneas, pero los 494 tokens/s representan capacidad agregada, no una sesión individual funcionando a esa velocidad.
Vía: Wccftech