Ejecutar localmente un modelo de 120.000 millones de parámetros suele exigir cantidades de memoria fuera del alcance de un PC convencional, especialmente cuando CPU o GPU deben mantener cargados pesos, contexto y datos intermedios. Sin embargo, el usuario de Reddit Medicine_Blogscanner ha conseguido ejecutar una versión cuantizada de gpt-oss-120b distribuyendo el trabajo entre varios ordenadores y hasta un smartphone Android.
El experimento reúne seis dispositivos muy diferentes entre sí y reduce el uso total de memoria hasta aproximadamente 47 GB, por debajo de los cerca de 60 GB que normalmente necesita una versión cuantizada a 4 bits del modelo. La contrapartida resulta considerable: el conjunto alcanza únicamente 1,1 tokens por segundo, demostrando que conseguir cargar un modelo y ejecutarlo no implica necesariamente obtener un rendimiento práctico.
Seis dispositivos forman un único sistema distribuido
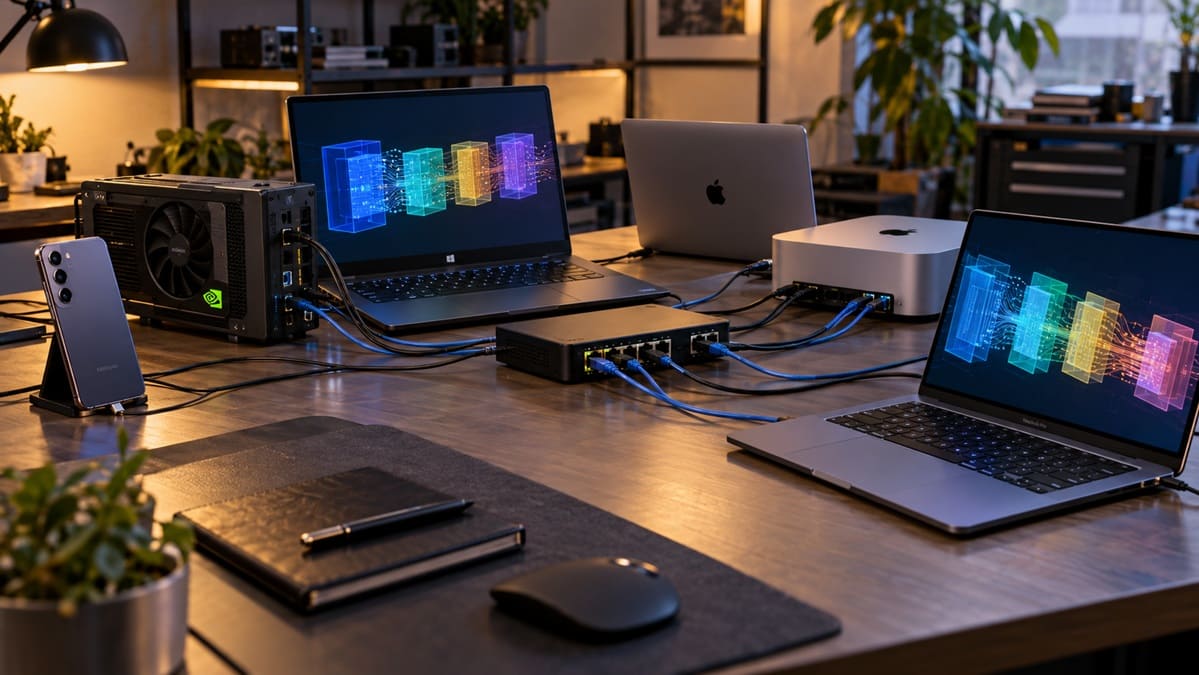
Medicine_Blogscanner no utiliza un servidor especializado ni una estación de trabajo con cientos de gigabytes de memoria. La idea consiste precisamente en aprovechar hardware de consumo ya disponible y repartir diferentes partes del modelo entre cada dispositivo.
El conjunto utilizado está formado por:
- Samsung Galaxy S24+, utilizado como uno de los nodos del sistema.
- Mini PC con GeForce RTX 3060 y 12 GB de VRAM.
- Portátil con Windows y 12 GB de memoria.
- MacBook Pro basado en Intel.
- Mac mini.
- MacBook Pro con Apple M3.
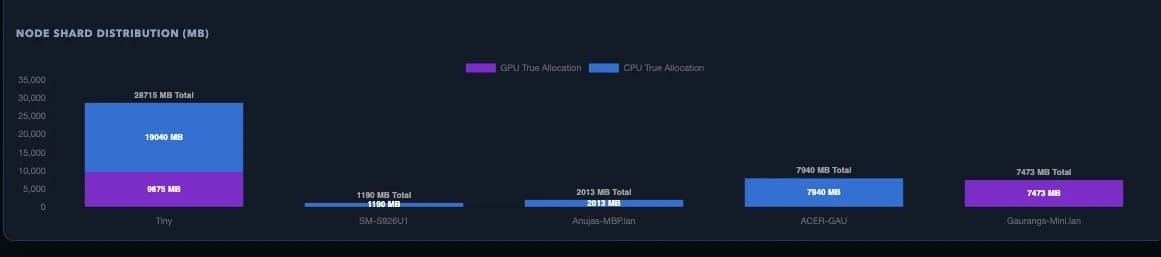
La máquina principal, identificada como “Tiny”, soporta la mayor parte de la carga y aporta aproximadamente 28,7 GB de memoria al conjunto, además de aprovechar una GeForce RTX 3060. Otro de los nodos distribuye varios gigabytes adicionales sobre GPU, mientras el resto completa las capas necesarias para alojar el modelo.
El resultado no equivale a convertir toda esa memoria en un único bloque físico compartido. Cada dispositivo conserva su propia RAM o VRAM y debe intercambiar información con los demás a través de la red durante la ejecución.
El paralelismo por etapas permite dividir las capas del modelo
La técnica utilizada se denomina pipeline parallelism o paralelismo por etapas, un método donde diferentes grupos de capas del modelo se cargan en dispositivos distintos.
En lugar de exigir que un solo ordenador mantenga los 120.000 millones de parámetros, cada nodo procesa únicamente la parte del modelo que tiene asignada. Cuando termina su trabajo, envía las activaciones resultantes al siguiente dispositivo, que continúa con las siguientes capas hasta completar la inferencia.
Este enfoque permite resolver el principal problema de capacidad, pero introduce otro muy diferente. Cada etapa depende de que la anterior termine y entregue sus resultados, haciendo que la latencia de red, el ancho de banda disponible y el rendimiento del nodo más lento puedan condicionar todo el sistema.
La mezcla de un smartphone, varios Mac, un portátil Windows y una RTX 3060 convierte el experimento en un caso especialmente extremo. El software debe coordinar arquitecturas, sistemas operativos y capacidades de cálculo muy distintas, algo bastante más complejo que distribuir un modelo entre varias GPU idénticas dentro del mismo servidor.
La cuantización reduce drásticamente la memoria necesaria
Un modelo de este tamaño sin cuantización puede requerir alrededor de 240 GB de memoria únicamente para almacenar sus parámetros utilizando representaciones de mayor precisión. Esa cifra deja fuera prácticamente cualquier ordenador de consumo.
Reducir los pesos a 4 bits permite recortar enormemente el espacio ocupado, acercando el requisito a unos 60 GB. Medicine_Blogscanner consiguió ir todavía más lejos y dejar el conjunto alrededor de 47 GB mediante la distribución y configuración utilizada.
La reducción tiene consecuencias. Disminuir la precisión de los pesos puede introducir cierta pérdida de calidad o modificar el comportamiento del modelo, aunque las técnicas modernas de cuantización permiten conservar una parte considerable de sus capacidades con una fracción de la memoria original.
El interés del experimento está precisamente ahí: demuestra que la capacidad física de una única GPU no tiene por qué representar un límite absoluto, siempre que exista software capaz de distribuir el modelo y se acepte el coste de rendimiento.
Los 1,1 tokens por segundo muestran el verdadero cuello de botella
El modelo consigue funcionar, pero únicamente genera alrededor de 1,1 tokens por segundo. Para una conversación sencilla ya supone esperar continuamente, mientras producir textos largos puede convertirse en un proceso extremadamente lento.
La causa no está únicamente en que algunos dispositivos sean modestos. Cada token debe atravesar sucesivamente las diferentes etapas del modelo, obligando a mover datos entre máquinas y esperar a que cada nodo complete su parte antes de continuar.
En un servidor diseñado para IA, las GPU pueden comunicarse mediante interconexiones de enorme ancho de banda y baja latencia. Una agrupación improvisada de dispositivos domésticos depende en cambio de Ethernet o Wi-Fi, además de combinar CPU y GPU con rendimientos muy diferentes.
Por eso, el experimento resuelve el problema de capacidad, pero no el de velocidad. Técnicamente, puede ejecutar gpt-oss-120b; desde el punto de vista productivo, una velocidad de 1,1 tok/s queda muy lejos de lo que normalmente se espera de un asistente local fluido.
Fuente de la imagen: Medicine_Blogscanner
La memoria unificada sigue ofreciendo una solución mucho más sencilla
Una alternativa consiste en utilizar equipos con grandes cantidades de memoria unificada accesible por CPU y GPU, evitando repartir el modelo entre varios sistemas físicos.
Máquinas capaces de ofrecer 128 GB o más dentro de un mismo espacio de memoria simplifican enormemente la ejecución de modelos grandes, ya que eliminan buena parte del tráfico entre nodos y permiten mantener pesos y datos dentro del mismo sistema.
El problema está en el precio. Estas configuraciones continúan concentrándose en estaciones de trabajo, equipos Apple de gama alta y nuevas plataformas específicamente diseñadas para IA local, quedando lejos del presupuesto de muchos usuarios.
Ahí es donde este experimento resulta interesante pese a su escaso rendimiento. No demuestra una forma eficiente de ejecutar gpt-oss-120b, sino que explora hasta dónde puede llegar el hardware que ya tenemos repartido por casa cuando el software permite utilizarlo de manera conjunta.
Una demostración técnica más que una alternativa práctica
Para un usuario que simplemente quiera ejecutar inteligencia artificial local, un modelo más pequeño seguirá ofreciendo una experiencia mucho mejor en hardware convencional. Sacrificar tamaño a cambio de mayor velocidad suele tener mucho más sentido que esperar varios segundos para producir cada pequeño fragmento de texto.
Sin embargo, el trabajo de Medicine_Blogscanner demuestra algo diferente: la memoria distribuida puede permitir ejecutar modelos que aparentemente quedan fuera del alcance de cada dispositivo por separado. El límite deja de ser únicamente cuánta RAM o VRAM tiene una máquina y pasa también por cómo puede repartirse el modelo.
El precio de esa flexibilidad es enorme en rendimiento. Alcanzar 1,1 tok/s convierte el proyecto en una prueba técnica y no en una estación de trabajo competitiva, pero muestra una vía interesante para experimentar con modelos grandes sin depender obligatoriamente de una GPU profesional con decenas de gigabytes de VRAM.
Vía: Wccftech