Apple Silicon continúa ampliando sus posibilidades para ejecutar modelos de inteligencia artificial localmente gracias al aumento de la memoria unificada y del ancho de banda disponible. Una tabla compartida alrededor de las últimas demostraciones de la compañía sitúa desde modelos de unos 14.000 millones de parámetros activos en iPhone y iPad hasta configuraciones de 1,6 billones mediante varios Mac Studio conectados en clúster.
Las cifras necesitan, sin embargo, bastante contexto. La cantidad de parámetros que puede manejar un dispositivo depende de la cuantización, el contexto, la arquitectura del modelo y la memoria disponible, mientras que hablar de parámetros activos resulta especialmente delicado en modelos Mixture of Experts. Apple sí confirma que el nuevo Mac Studio con M5 Ultra puede configurarse con hasta 512 GB de memoria unificada y 1,2 TB/s de ancho de banda, además de agrupar varios equipos mediante Thunderbolt 5 y RDMA.
Un iPhone con 16 GB podría manejar modelos de unos 14.000 millones de parámetros
La escala propuesta comienza con iPhone y iPad equipados con 16 GB de memoria, asociados a modelos de alrededor de 14.000 millones de parámetros activos. La referencia utiliza además un ancho de banda cercano a 76 GB/s como punto de partida para una inferencia local razonable.
Los dispositivos más recientes pueden superar ampliamente esa cifra. El A20 Pro alcanza alrededor de 115,2 GB/s de ancho de banda de memoria, proporcionando más margen para mover los pesos del modelo durante la generación de cada token.
Esto no significa que cualquier modelo de 14B vaya a funcionar con la misma velocidad o calidad. Un modelo almacenado en FP16 necesita aproximadamente el doble de memoria por parámetro que uno en 8 bits, mientras que una cuantización de 4 bits puede reducir considerablemente la memoria necesaria a cambio de introducir diferentes compromisos.
El salto hacia los Mac resulta mucho mayor precisamente porque la GPU puede acceder directamente a cantidades de memoria unificada muy superiores a la VRAM habitual de una tarjeta gráfica de consumo.
Los MacBook y Mac mini subirían hasta modelos de 70B y 120B
Las configuraciones con hasta 64 GB de memoria unificada aparecen asociadas a modelos de unos 70.000 millones de parámetros activos, mientras los Mac capaces de alcanzar 128 GB elevarían esa referencia hasta aproximadamente 120.000 millones.
Aquí la memoria resulta tan importante como la potencia de cálculo. Un modelo denso de 70.000 millones de parámetros ocuparía alrededor de 140 GB únicamente con pesos FP16, por lo que sería imposible cargarlo íntegramente en 64 GB sin utilizar una precisión inferior.
Con una cuantización de 4 bits, esos mismos pesos pueden caer teóricamente hasta aproximadamente 35 GB antes de añadir la caché KV, el contexto, el propio sistema operativo y la memoria requerida por el motor de inferencia. Por eso dos modelos con la misma cantidad de parámetros pueden presentar requisitos muy distintos.
La ventaja de la arquitectura de Apple está en que CPU, GPU y Neural Engine comparten el mismo conjunto de memoria, evitando tener que mantener una copia independiente dentro de una cantidad limitada de VRAM.
El Mac Studio con M5 Ultra alcanza hasta 512 GB y 1,2 TB/s
Es en el Mac Studio con M5 Ultra donde las cifras empiezan a entrar en un terreno poco habitual para un ordenador de sobremesa compacto. Apple permite configurarlo con hasta 512 GB de memoria unificada, acompañados por un ancho de banda de 1,2 TB/s.
Su configuración superior incorpora además una CPU de 36 núcleos, una GPU de 80 núcleos y un Neural Engine de 32 núcleos, junto con aceleradores neuronales integrados dentro de la GPU. Apple señala directamente la ejecución de grandes modelos de lenguaje como uno de los usos previstos para esta cantidad de memoria.
Las estimaciones que están circulando sitúan un único Mac Studio alrededor de los 480.000 millones de parámetros, pero esta cifra no debe interpretarse como compatibilidad universal con cualquier modelo de 480B.
Un modelo denso de semejante tamaño necesitaría una cuantización muy agresiva para entrar cómodamente en 512 GB. En los modelos MoE, además, los parámetros activos determinan principalmente el trabajo realizado por cada token, mientras los parámetros totales continúan condicionando cuánto espacio necesitan los pesos.
Varios Mac Studio podrían sumar hasta 2 TB de memoria
Apple permite conectar varios Mac Studio mediante Thunderbolt 5 utilizando RDMA, facilitando que distintos sistemas colaboren sobre una misma carga de inteligencia artificial. La propia compañía asegura que las últimas mejoras pueden triplicar el rendimiento de inferencia distribuida frente a un único equipo en determinadas cargas.
Cuatro Mac Studio configurados con 512 GB sumarían 2 TB de memoria unificada agregada, cantidad suficiente sobre el papel para trabajar con modelos considerablemente mayores que los admitidos por una sola máquina.
De ahí procede la referencia a modelos de hasta 1,6 billones de parámetros. No obstante, cuatro ordenadores con 512 GB no equivalen a un único procesador con 2 TB de memoria local: los datos deben desplazarse entre nodos y aparecen costes de comunicación, sincronización y latencia.
Por tanto, que un modelo entre en memoria no significa que vaya a ejecutarse a una velocidad práctica. El rendimiento final dependerá de cómo esté dividido entre máquinas, del motor utilizado y de cuánto tráfico necesite atravesar la conexión entre los diferentes Mac Studio.
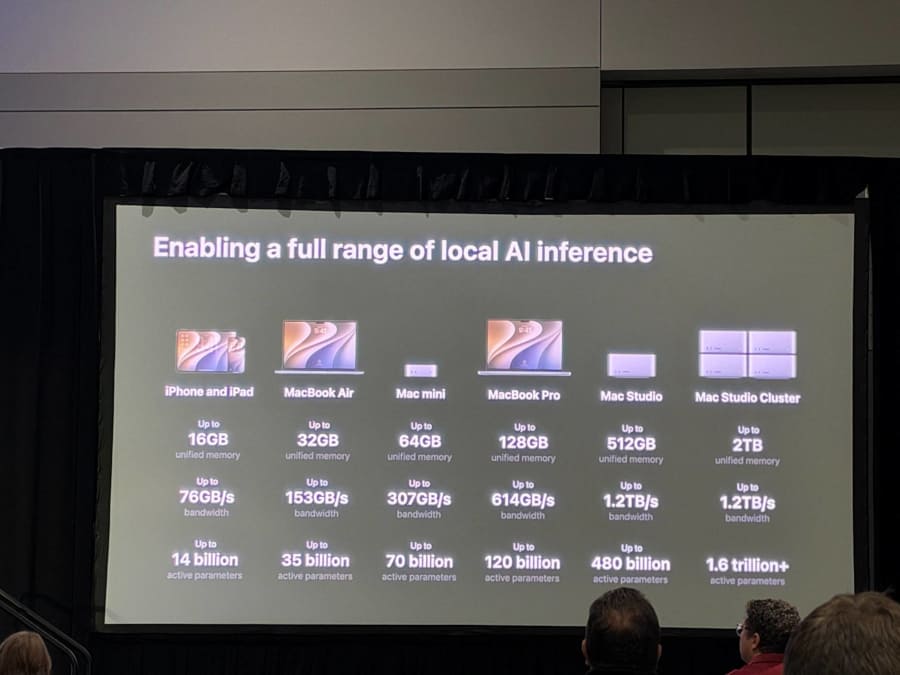
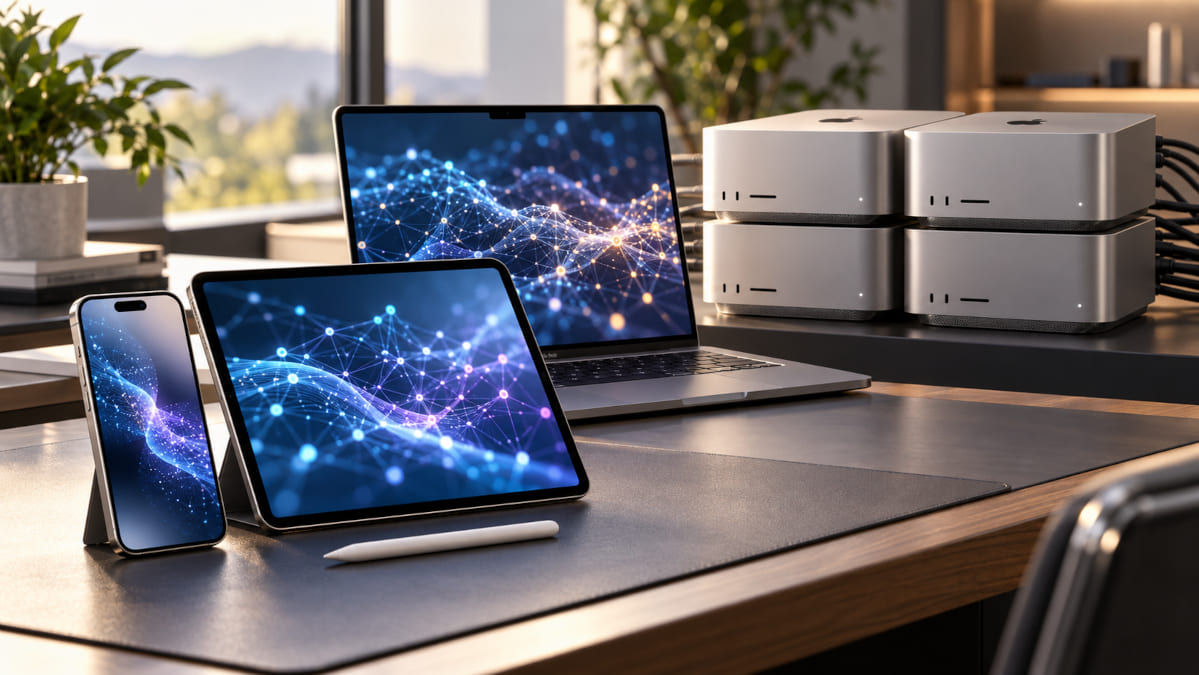
La tabla compartida por Apple muestra qué modelos LLM puede ejecutar cada dispositivo. Fuente de la imagen: @aaronp613.
Los parámetros activos pueden resultar engañosos en modelos MoE
La distinción entre parámetros totales y parámetros activos resulta especialmente importante. Un modelo Mixture of Experts puede contener cientos de miles de millones o incluso más de un billón de parámetros, pero utilizar únicamente una parte de ellos para procesar cada token.
Eso reduce el cálculo ejecutado en cada paso, pero los expertos que no están activos siguen formando parte del modelo y sus pesos deben permanecer accesibles. Por tanto, un modelo anunciado como 1,6T con únicamente 40B o 50B activos no ocupa lo mismo que un modelo denso de 50B.
La tabla tampoco especifica qué nivel de cuantización se está utilizando para cada categoría, impidiendo convertir esas cifras en requisitos exactos de memoria. Un modelo en 4 bits puede necesitar aproximadamente una cuarta parte de la memoria de sus pesos frente a FP16, aunque el resultado real nunca se limita únicamente a esa división.
Ese contexto convierte las cifras de 14B, 70B, 120B, 480B y 1,6T en referencias orientativas de capacidad, no en límites universales aplicables a cualquier LLM.
La memoria unificada se convierte en una de las principales armas de Apple para IA local
Apple no necesita necesariamente superar a una GPU dedicada en potencia bruta para resultar interesante en este escenario. La posibilidad de ofrecer 128, 256 o 512 GB accesibles por la GPU dentro del mismo espacio de memoria permite ejecutar modelos que directamente no caben en tarjetas gráficas de consumo con 16, 24 o 32 GB de VRAM.
Eso tampoco convierte automáticamente al Mac Studio en la opción más rápida o económica para inteligencia artificial. CUDA continúa dominando buena parte del ecosistema profesional, mientras plataformas como MLX intentan aprovechar específicamente las características de Apple Silicon.
La diferencia está en el tamaño de los modelos que pueden mantenerse localmente. Un único Mac Studio puede llegar a cientos de miles de millones de parámetros bajo determinadas configuraciones, mientras los clústeres elevan todavía más el techo al repartir pesos y cálculo entre varias máquinas.
Vía: Wccftech