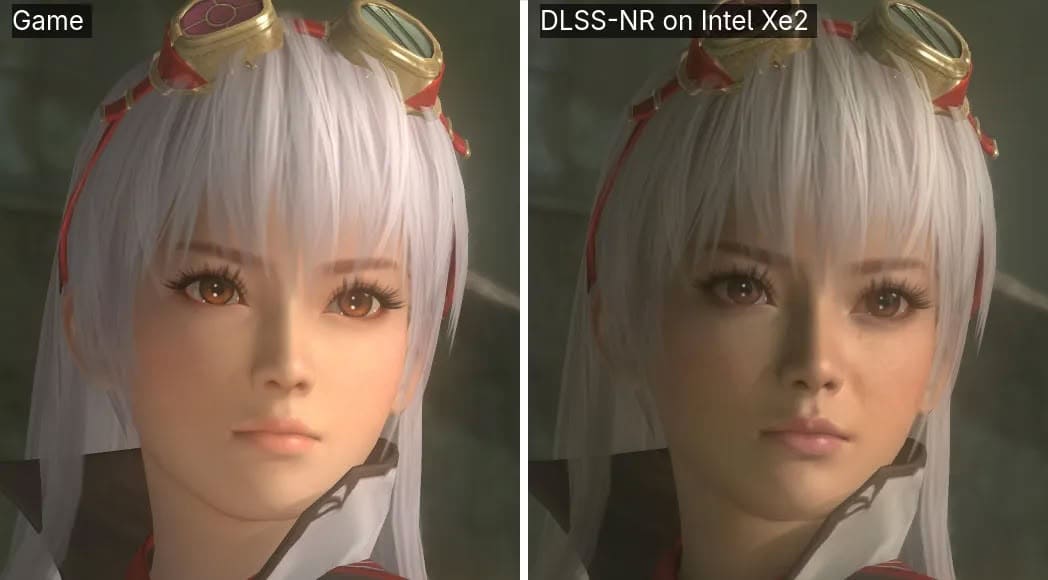
Un desarrollador conocido como Uzbekunknown ha conseguido ejecutar NVIDIA DLSS 5 Neural Rendering sobre una Intel Arc 140V de Lunar Lake, sin utilizar hardware NVIDIA, CUDA ni NGX. Su proyecto dlss-nr-on-intel reconstruye de forma independiente la inferencia de la red y la ejecuta sobre las unidades XMX de Intel mediante Vulkan.
La demostración funciona en Tekken 7, Dead or Alive 5 Last Round y Mortal Kombat 1, pero todavía está muy lejos de resultar práctica: el propio proyecto mide alrededor de 8,6 FPS a 640 × 360 y solo 1,2 FPS a 1.920 × 1.080. Uzbekunknown lo define expresamente como un trabajo de investigación y no como una implementación destinada al gaming convencional.
No es un wrapper: reconstruye la red de 71 bloques
La parte técnicamente más interesante está en cómo funciona. dlss-nr-on-intel no se limita a redirigir llamadas hacia la DLL de NVIDIA, sino que vuelve a implementar la red U-Net simétrica de 71 bloques utilizada por Neural Rendering y ejecuta sus operaciones matriciales directamente sobre las unidades XMX de Xe2.
El modelo contiene 649 tensores y unos 145,8 millones de parámetros, recuperados a partir de una copia de nvngx_dlssnr.dll que debe aportar el propio usuario. El repositorio no distribuye ni binarios ni pesos de NVIDIA, manteniendo únicamente el código necesario para reconstruir y ejecutar la inferencia.
Esta distinción importa porque demuestra que Neural Rendering no depende obligatoriamente de CUDA a nivel conceptual. Si otra GPU ofrece operaciones matriciales adecuadas y una API capaz de exponerlas, el modelo puede trasladarse, aunque hacerlo con eficiencia sea otro problema completamente distinto.
Xe2 ejecuta el modelo en FP16 porque no dispone de FP8
La Arc 140V utiliza sus unidades XMX mediante VK_KHR_cooperative_matrix, ejecutando las multiplicaciones en FP16 con acumulación FP32. El motivo está en que Xe2 no soporta el FP8 utilizado originalmente por buena parte de los pesos de DLSS 5.
Los pesos almacenados en la DLL utilizan FP8 E4M3 para las matrices grandes, pero el proyecto debe decodificarlos a FP16 antes de ejecutarlos sobre la iGPU de Intel. Esto aumenta tanto el volumen de datos como el coste computacional frente a una ruta preparada específicamente para FP8.
Ahí aparece una de las razones por las que el rendimiento se desploma. No basta con disponer de aceleradores matriciales: formato numérico, ancho de banda, registros y arquitectura de ejecución determinan cuánto cuesta realmente mover una red neuronal de casi 146 millones de parámetros.
A 1080p necesita unos 850 ms por fotograma
Las mediciones publicadas por el proyecto muestran 99 ms a 512 × 288 con escala 0,35, 117 ms a 640 × 360 y aproximadamente 850 ms a 1080p, contando el recorrido completo entre el juego, la capa Vulkan y el daemon de inferencia.
Eso deja la Arc 140V en unos 8,6 FPS a 640 × 360 y 1,2 FPS a 1080p, por lo que reducir únicamente la resolución interna del juego no soluciona el problema. Varias etapas de procesamiento siguen trabajando sobre la resolución completa de salida.
Este detalle explica por qué el desarrollador recomienda ventanas extremadamente pequeñas. El coste depende fuertemente del tamaño del swapchain, no solo de la resolución a la que se renderiza originalmente el juego.
El propio autor considera además agotadas muchas de las optimizaciones obvias. GEMM continúa siendo una de las partes más pesadas, mientras otras operaciones ya estarían cerca del límite de ancho de banda de memoria de la máquina.
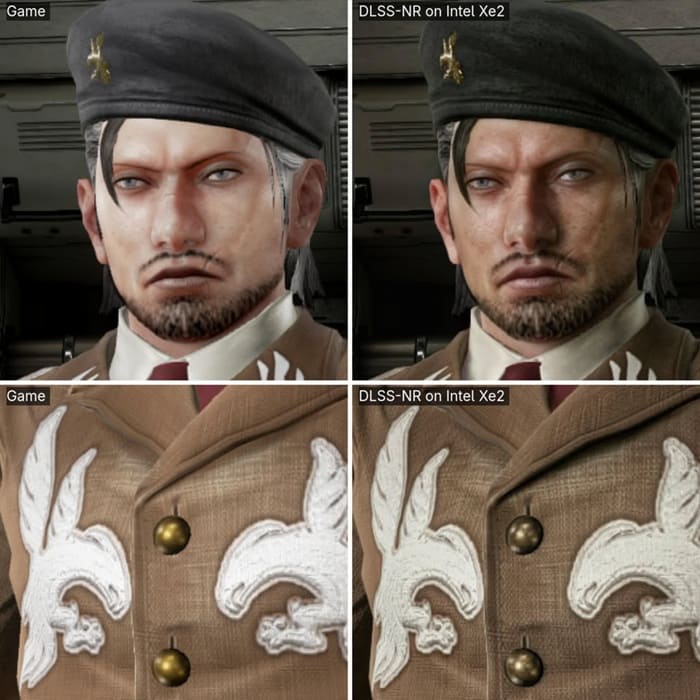
Photo Mode resulta mucho más realista que utilizarlo durante el gameplay
El proyecto dispone de un modo que procesa un único fotograma y mantiene el resultado en pantalla, evitando intentar ejecutar continuamente la red. Este escenario encaja mucho mejor con el rendimiento disponible actualmente.
En otras palabras, DLSS 5 sobre Arc 140V puede tener sentido experimentalmente para capturas, comparaciones de imagen o investigación sobre Neural Rendering, pero no como tecnología jugable en tiempo real.
La carga tampoco es pequeña en memoria. El proyecto estima unos 2,3 GiB de buffers a 720p, compartidos con la RAM del sistema al tratarse de una iGPU, añadiendo otra presión relevante sobre una plataforma móvil.
El proyecto se escribió casi completamente mediante Claude Opus 5 y GPT-6 Astra
Otro elemento poco habitual es su proceso de desarrollo. Uzbekunknown afirma que Claude Opus 5 y GPT-6 Astra produjeron el código, las mediciones y las notas, mientras él aportó el hardware, el binario, las directrices y las decisiones finales.
El desarrollador admite incluso que no puede defender el código línea por línea. El repositorio conserva errores cometidos durante el proceso, entre ellos una supuesta anomalía del driver que resultó no existir y condicionó tres fases completas de desarrollo.
Eso convierte el proyecto en un experimento doble: no solo prueba que Neural Rendering puede trasladarse a hardware Intel, sino también hasta dónde pueden llegar agentes de IA generando y validando una implementación técnica compleja con supervisión humana de alto nivel.
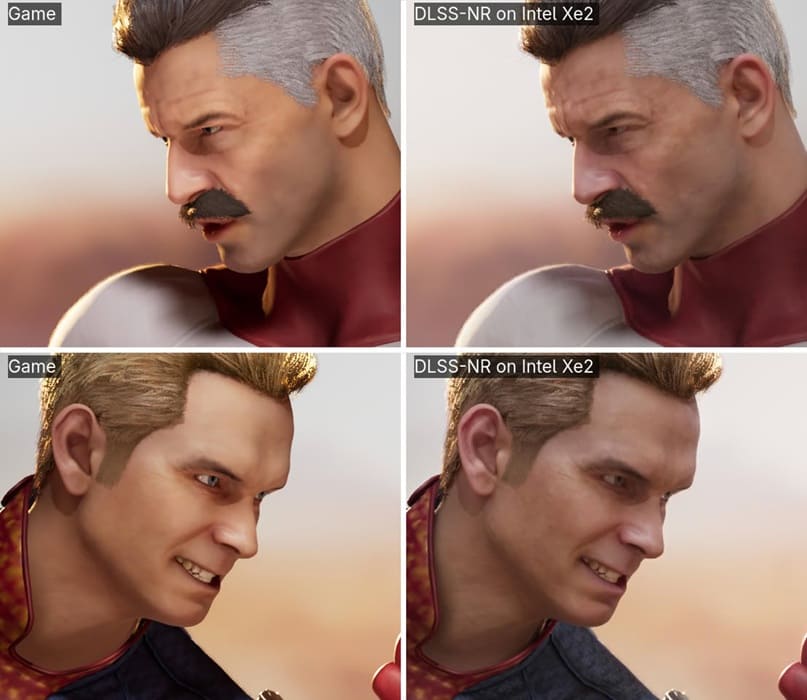
DLSS 5 continúa escapando del ecosistema GeForce
Esta demostración aparece después de experimentos que ya habían conseguido trasladar Neural Rendering a GeForce RTX 30, GPU AMD RDNA 4 e incluso navegadores mediante WebGPU, reforzando la idea de que la red puede ejecutarse fuera del entorno para el que fue diseñada originalmente.
Sin embargo, la Arc 140V deja también clara la otra mitad del problema. Conseguir que una red funcione no significa conseguir que funcione con suficiente rendimiento, y la diferencia entre una implementación experimental y una integración optimizada por el fabricante puede ser enorme.
Por ahora, dlss-nr-on-intel solo funciona bajo Linux y requiere que el usuario aporte su propia copia de la DLL de NVIDIA. Su importancia está, por tanto, en demostrar que las unidades XMX de Xe2 pueden ejecutar una reimplementación completa de DLSS 5 Neural Rendering, aunque los 8,6 FPS a 640 × 360 dejan muy claro que todavía estamos ante investigación y no ante una alternativa práctica.
Vía: TechPowerUp