AMD y Meta han anunciado una nueva fase de su colaboración para desarrollar infraestructuras de inteligencia artificial. Los primeros sistemas AMD Helios a escala de rack ya están instalados en las instalaciones de Meta y han comenzado las pruebas previas a un despliegue más amplio. El acuerdo también contempla procesadores EPYC de sexta generación y GPU Instinct personalizadas.
La colaboración combina hardware, redes y software, con millones de procesadores AMD EPYC ya desplegados por Meta y aceleradores Instinct utilizados en producción. Ambas compañías también han optimizado ROCm para los modelos Muse Spark Open y Muse Glimmer, además de mejorar el entrenamiento de sistemas de recomendación mediante las Instinct MI350X.
Los primeros sistemas AMD Helios comienzan las pruebas en Meta
Según el comunicado oficial de AMD, los primeros equipos Helios ya están instalados y sometiéndose a pruebas en Meta, antes de extender su utilización a más centros de datos. La compañía todavía no ha comunicado cuántos racks se han instalado ni su capacidad de cálculo, por lo que no puede afirmarse que el despliegue comercial a gran escala esté completado.
La plataforma Helios combina GPU Instinct, procesadores EPYC, soluciones de red AMD Pensando y el ecosistema ROCm. Su planteamiento consiste en integrar estos componentes dentro de una infraestructura completa, optimizada para trabajar como un único sistema. Esto permite abordar conjuntamente las comunicaciones entre aceleradores, la distribución de energía y la refrigeración, factores importantes cuando aumenta el número de GPU.
El despliegue forma parte de la estrategia anunciada anteriormente por ambas compañías, que contempla hasta 6 GW de infraestructura basada en GPU AMD durante varias generaciones. Sin embargo, esa cifra representa la capacidad prevista en el acuerdo, no la potencia ya instalada. El objetivo es ampliar progresivamente la infraestructura mediante plataformas adaptadas a las necesidades de Meta.
Meta utiliza millones de EPYC y prepara la llegada de Venice con Zen 6
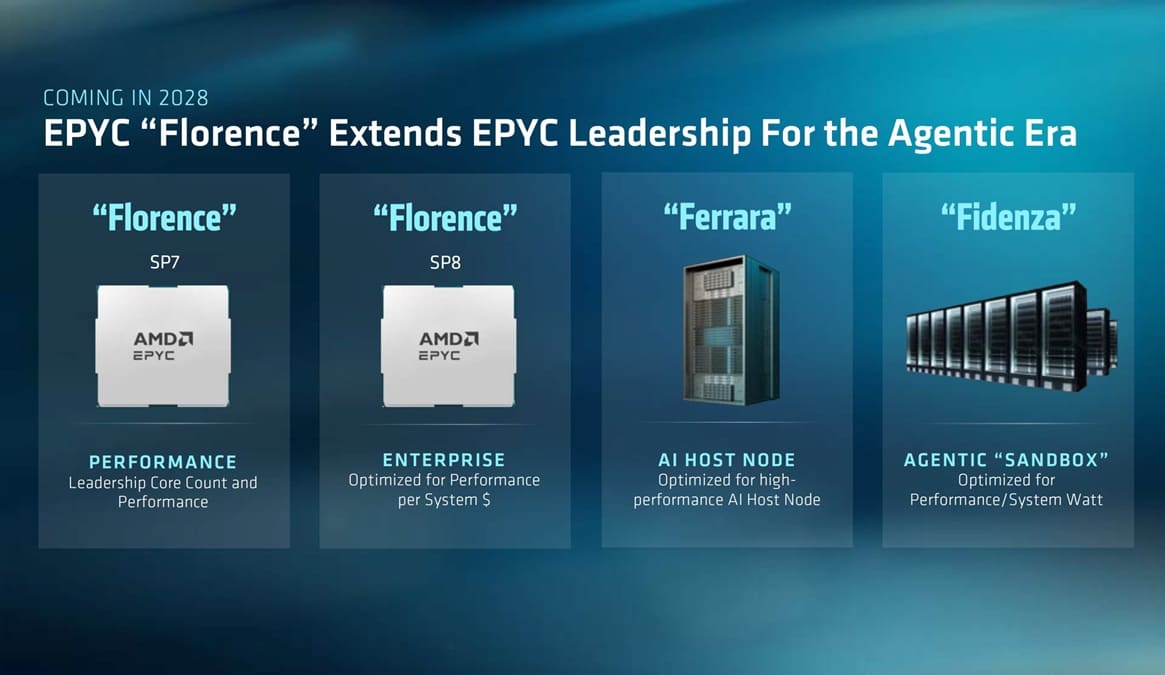
Meta ha desplegado millones de procesadores AMD EPYC a lo largo de varias generaciones, utilizando estas CPU para sostener sus servicios e infraestructura de inteligencia artificial. La compañía también es uno de los principales clientes de los nuevos EPYC Venice de sexta generación, basados en la arquitectura Zen 6 y fabricados mediante el proceso de 2 nm de TSMC.
Los nuevos procesadores alcanzan hasta 256 núcleos y 512 hilos por socket, con mejoras en conectividad y ancho de banda de memoria. En los sistemas de IA, las CPU se encargan de coordinar tareas, gestionar datos y ejecutar herramientas utilizadas por los agentes, mientras las GPU realizan buena parte del cálculo intensivo. AMD y Meta también colaboran en la futura generación EPYC Verano.
Las Instinct MI350X mejoran el entrenamiento de modelos de recomendación
Las GPU AMD Instinct ya funcionan en producción dentro de Meta, utilizadas para entrenamiento de modelos, clasificación y sistemas de recomendación. La colaboración también alcanza a la arquitectura Instinct MI450, para la que Meta participó desde las primeras etapas de diseño. Ambas compañías preparan una GPU personalizada destinada a sus cargas de trabajo, mientras continúan colaborando en futuras plataformas MI500.
Uno de los avances técnicos procede de una investigación publicada por Meta sobre el entrenamiento de modelos de recomendación con Instinct MI350X. El documento compara aspectos de esta GPU con NVIDIA B200, destacando que la solución de AMD dispone de 1,6 veces más capacidad de memoria HBM, una ventaja que puede aprovecharse mediante ajustes específicos.
En lugar de trasladar directamente las implementaciones preparadas para NVIDIA, los ingenieros adaptaron la estructura de los modelos y los kernels de cálculo a la arquitectura de AMD. También desarrollaron mecanismos para seleccionar automáticamente las operaciones más eficientes. Estas optimizaciones consiguieron hasta 1,5 veces más rendimiento de entrenamiento frente a una implementación trasladada directamente a MI350X sin optimizar.
La comparación es importante porque esa mejora del 50% no representa una ventaja de rendimiento frente a NVIDIA B200. Mide el beneficio de optimizar el software para el acelerador de AMD. Parte del trabajo también se ha incorporado a PyTorch, Triton y ROCm, permitiendo que otros desarrolladores aprovechen estas mejoras sin tener que reproducir todas las optimizaciones.
Muse Spark Open funciona en ocho Instinct MI350X con mejoras importantes de rendimiento
AMD también ha publicado las optimizaciones necesarias para ejecutar Muse Spark Open, el modelo de Meta con 816.000 millones de parámetros totales y 42.000 millones activos mediante una arquitectura de mezcla de expertos (MoE). El modelo admite contextos de hasta un millón de tokens, aunque las configuraciones de ejecución publicadas por AMD utilizan límites inferiores.
La compañía demuestra su funcionamiento mediante un servidor con ocho GPU Instinct MI350X, utilizando ROCm 7.2 y vLLM. Cada acelerador dispone de 288 GB de memoria HBM3E, proporcionando capacidad suficiente para distribuir el modelo entre varias GPU. La implementación admite BF16, FP8 y MXFP4, esta última orientada a reducir los requisitos de memoria y cálculo.
Las primeras optimizaciones se concentran en reducir operaciones innecesarias durante la generación de tokens. AMD ha conseguido eliminar aproximadamente 180 lanzamientos de kernels por paso de decodificación, combinando distintas operaciones mediante su biblioteca AITER. Con cuatro solicitudes simultáneas, el rendimiento anunciado aumenta de 206 a 350 tokens/s, mientras que con 32 solicitudes pasa de 719 a 1.180 tokens/s.
La utilización de paralelismo de expertos aporta mejoras adicionales cuando aumenta la concurrencia. Esta técnica distribuye los expertos del modelo entre las GPU, evitando que cada acelerador tenga que ejecutar todas las operaciones. Según AMD, el rendimiento aumenta entre un 7% y un 20% con 32 a 128 solicitudes simultáneas, reduciendo también el tiempo hasta el primer token aproximadamente un 24%.
Otra incorporación es DSpark, un sistema de decodificación especulativa que permite acelerar la generación mediante predicciones verificadas posteriormente por el modelo principal. En las pruebas publicadas, alcanza 199 tokens/s con una única solicitud, un 72% más que la configuración de referencia optimizada utilizada en esa comparación. La ventaja disminuye al aumentar la concurrencia, por lo que AMD recomienda diferentes configuraciones según la carga.
Muse Glimmer llega a Ryzen AI y Radeon con soporte desde el lanzamiento
La colaboración también se extiende a los ordenadores personales mediante Muse Glimmer, un modelo de 30.000 millones de parámetros destinado a ejecutar agentes de IA localmente. AMD ofrece compatibilidad con procesadores Ryzen AI y GPU Radeon, permitiendo utilizarlo sin depender necesariamente de centros de datos. Esta implementación complementa el soporte de Muse Spark Open en aceleradores Instinct.
Además de ampliar su colaboración técnica, AMD ha anunciado una inversión de 1.000 millones de dólares (unos 899 millones de euros) en la oferta de acciones de Meta. La operación refuerza una relación que abarca CPU, GPU, redes y desarrollo de software, aunque todavía falta comprobar el rendimiento y la eficiencia de los nuevos sistemas Helios cuando alcancen despliegues de mayor escala.
Vía: Wccftech