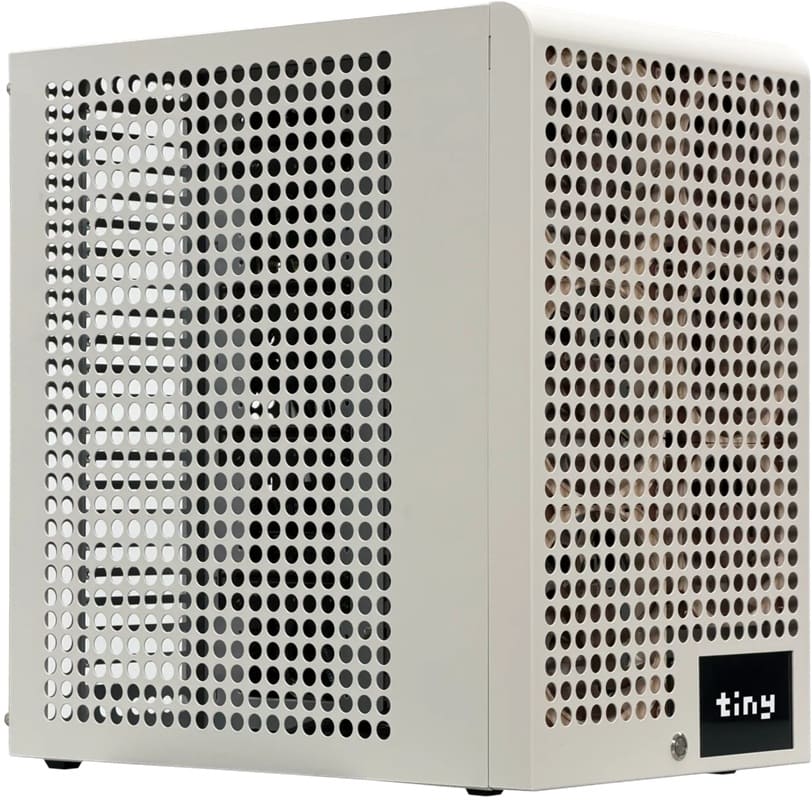
Tiny Corp ha dado a conocer la tinybox Red Kimi, una nueva estación de trabajo diseñada para ejecutar grandes modelos de inteligencia artificial de forma local. El equipo combina cuatro tarjetas gráficas AMD Radeon AI Pro R9700 con 128 GB GDDR6 en total y un sistema de almacenamiento formado por 16 SSD NVMe de 1 TB, cuyo ancho de banda anunciado alcanza los 238,4 GB/s.
La configuración está especialmente orientada a ejecutar Kimi K3, el modelo de 2,8 billones de parámetros desarrollado por Moonshot AI. Tiny Corp asegura que su estación puede alcanzar 40 tokens por segundo durante la generación de respuestas, aunque todavía no existen benchmarks independientes que confirmen ese rendimiento. El fabricante comercializa el equipo por 30.000 dólares (26.921€), con fabricación bajo pedido.
Cuatro Radeon AI Pro R9700 y un procesador AMD EPYC de 32 núcleos
La tinybox Red Kimi utiliza un procesador AMD EPYC Genoa de 32 núcleos, acompañado por 32 GB DDR5 de memoria del sistema. La compañía no ha especificado el modelo exacto de CPU, pero confirma una configuración centrada en el procesamiento mediante GPU. Las cuatro Radeon AI Pro R9700 están basadas en la arquitectura RDNA 4 de AMD, orientada también a cargas de inferencia de inteligencia artificial.
Cada tarjeta incorpora 32 GB GDDR6 con un ancho de banda máximo de 640 GB/s, por lo que el conjunto alcanza 128 GB de memoria gráfica y 2.560 GB/s de ancho de banda agregado. Sin embargo, estas cifras corresponden a cuatro GPU independientes, no a un único bloque de memoria compartida. Su aprovechamiento dependerá de cómo se distribuyan los datos y las operaciones entre los aceleradores.
La elección de estas GPU permite utilizar tarjetas profesionales con 32 GB de memoria cada una, una capacidad relevante para ejecutar modelos de lenguaje que superan los límites habituales de las soluciones de consumo. No obstante, los 128 GB disponibles resultan insuficientes para almacenar íntegramente Kimi K3, incluso recurriendo a técnicas de cuantización habituales. Por ese motivo, Tiny Corp ha desarrollado una solución de almacenamiento especializada.
Un sistema de 16 SSD NVMe alcanza los 238,4 GB/s anunciados
La característica más llamativa de la Red Kimi es su conjunto de 16 unidades SSD NVMe de 1 TB, organizadas mediante una configuración RAID de alto rendimiento. Tiny Corp anuncia un ancho de banda agregado de 238,4 GB/s, una cifra muy superior a la que puede ofrecer una unidad SSD convencional y que busca facilitar el acceso a grandes cantidades de datos desde las GPU.
Para aprovechar esta configuración, el fabricante afirma haber desarrollado un controlador propio que permite a las GPU AMD gestionar directamente las unidades NVMe. El objetivo es reducir las limitaciones que aparecen cuando los datos deben atravesar varias capas de software antes de llegar a los aceleradores. Este planteamiento resulta especialmente relevante en modelos cuyos parámetros exceden ampliamente la memoria gráfica disponible.
En el caso de Kimi K3, sus 2,8 billones de parámetros requieren una capacidad de almacenamiento considerablemente superior a los 128 GB de las cuatro GPU. El modelo utiliza una arquitectura Mixture of Experts (MoE), que activa aproximadamente 104.000 millones de parámetros por token. Esta característica permite utilizar una parte de sus expertos durante cada operación, aunque el conjunto completo de pesos sigue necesitando estar almacenado.
La solución de Tiny Corp pretende mantener los datos del modelo en los SSD y transferirlos hacia las GPU cuando sean necesarios, evitando depender exclusivamente de la memoria gráfica. Sin embargo, los 238,4 GB/s anunciados no equivalen necesariamente al rendimiento efectivo durante la inferencia, ya que también intervienen la latencia, las transferencias y la coordinación entre unidades de almacenamiento y aceleradores.
Esta distinción resulta importante porque los SSD no sustituyen directamente a la memoria GDDR6, cuyo ancho de banda y características de acceso son considerablemente diferentes. La viabilidad del sistema dependerá de que el software consiga aprovechar la estructura del modelo y minimizar las transferencias innecesarias. Por ahora, Tiny Corp no ha publicado mediciones independientes que permitan evaluar estas limitaciones.
This is the topology of the tinybox red kimi, frontier models at home at usable speeds for a good price. tinygrad has a driver to directly control the NVMe drives from the AMD GPUs. https://t.co/YlHhaD7Kpl
— the tiny corp (@__tinygrad__) October 29, 2026
Tiny Corp promete ejecutar Kimi K3 a 40 tokens por segundo
El fabricante anuncia una velocidad de generación de 40 tokens por segundo con Kimi K3, una cifra que permitiría utilizar el modelo de forma interactiva desde una estación de trabajo individual. Sin embargo, no se han detallado suficientemente las condiciones de ejecución, la cuantización empleada ni el tamaño del contexto, factores que pueden modificar considerablemente los resultados obtenidos.
La compañía también comercializa la tinybox Red Flash, una configuración diferente equipada con seis Radeon AI Pro R9700 y 192 GB de memoria gráfica agregada. Mientras ese modelo prioriza una mayor capacidad de memoria dedicada, la Red Kimi apuesta por un sistema de almacenamiento mucho más rápido para ejecutar modelos que no pueden mantenerse completamente en las GPU.
La tinybox Red Kimi cuesta 30.000 dólares y se fabrica bajo pedido
Tiny Corp ofrece la nueva configuración por 30.000 dólares (26.921€), con un plazo estimado de envío de entre una y ocho semanas. Los pedidos se realizan mediante transferencia bancaria y la compañía contempla envíos internacionales, aunque los compradores fuera de Estados Unidos deben asumir los impuestos y posibles gastos de importación correspondientes. No existe un precio oficial específico para España.
La propuesta se diferencia de estaciones como el Mac Studio con 512 GB de memoria unificada, que apuesta por concentrar una mayor capacidad de memoria accesible para sus procesadores. Tiny Corp utiliza una arquitectura distinta, basada en GPU independientes y almacenamiento NVMe de elevado ancho de banda. Su principal atractivo será demostrar que esta combinación puede ejecutar modelos de varios billones de parámetros con una velocidad práctica, algo que todavía necesita validación mediante benchmarks independientes.
Vía: NotebookCheck