Microsoft ha mostrado una de las capacidades más llamativas de los nuevos portátiles con NVIDIA RTX Spark: ejecutar localmente DeepSeek-V4-Flash, un modelo de 284.000 millones de parámetros, utilizando aproximadamente 60 GB de memoria. La demostración recurre a una cuantización de 1,6 bits que reduce considerablemente el espacio necesario para almacenar sus parámetros.
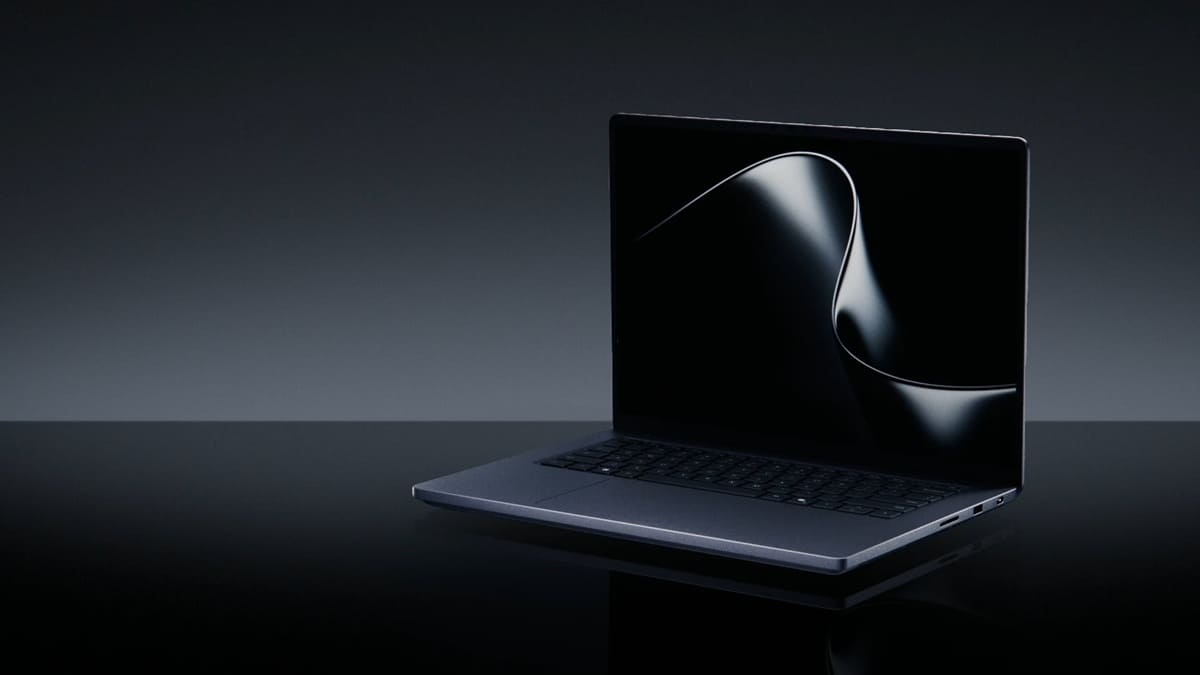
El anuncio fue realizado por Pavan Davuluri, vicepresidente ejecutivo de Windows y dispositivos, durante la presentación del Surface Laptop Ultra. La posibilidad de ejecutar un modelo de este tamaño en un portátil con hasta 128 GB de memoria unificada representa un avance interesante para la IA local, aunque todavía faltan datos sobre velocidad de generación, longitud de contexto efectiva y calidad de las respuestas.
DeepSeek-V4-Flash utiliza 284.000 millones de parámetros
El modelo elegido por Microsoft es DeepSeek-V4-Flash, una arquitectura de mezcla de expertos (MoE) desarrollada por DeepSeek. Aunque dispone de 284.000 millones de parámetros totales, únicamente activa aproximadamente 13.000 millones durante el procesamiento de cada token, reduciendo las operaciones necesarias frente a un modelo denso de tamaño equivalente.
Esta diferencia resulta fundamental para comprender su funcionamiento. Los parámetros totales determinan buena parte de la memoria necesaria para cargar el modelo, mientras la activación selectiva de expertos permite reducir el cálculo realizado durante la inferencia. Sin embargo, eso no significa que los parámetros inactivos desaparezcan de la memoria, ya que pueden necesitarse en los siguientes pasos.
Conviene aclarar además que DeepSeek-V4-Flash no es el mismo modelo que DeepSeek-V4.1-Flash. Esta última versión utiliza una arquitectura diferente y alcanza 552.000 millones de parámetros, por lo que las cifras anunciadas por Microsoft corresponden específicamente al modelo original de 284.000 millones.
La cuantización de 1,6 bits reduce el modelo a unos 60 GB
La principal novedad técnica está en la cuantización de 1,6 bits utilizada para comprimir DeepSeek-V4-Flash. Este procedimiento reduce la precisión empleada para representar los parámetros, disminuyendo considerablemente la memoria necesaria frente a formatos habituales como FP16, que exigirían una capacidad muy superior.
En términos teóricos, 284.000 millones de parámetros representados mediante 1,6 bits necesitan aproximadamente 56,8 GB antes de considerar estructuras auxiliares. La cifra comunicada por Microsoft, cercana a 60 GB, resulta coherente con ese orden de magnitud, aunque no se ha detallado públicamente el formato exacto de cuantización utilizado.
Esta reducción permite que un modelo de tamaño extraordinario pueda residir en la memoria de un único portátil, evitando repartir sus parámetros entre varias GPU dedicadas. No obstante, utilizar precisiones tan bajas también puede introducir pérdidas de calidad que deben evaluarse mediante pruebas de razonamiento, programación y seguimiento de instrucciones.
Además, los 60 GB no representan necesariamente el consumo total durante una sesión de inferencia. El sistema necesita reservar memoria para la caché KV, las operaciones intermedias y otros recursos, por lo que el espacio disponible para estas tareas depende tanto del modelo como de la longitud del contexto utilizado.
Los Surface Laptop Ultra de 128 GB tendrán mayor margen
La configuración superior del Surface Laptop Ultra incorpora 128 GB de memoria LPDDR5X unificada, compartida entre la CPU Grace y la GPU Blackwell. Esta arquitectura permite asignar una parte considerable de la capacidad disponible a las cargas de IA, evitando las limitaciones de memoria gráfica que presentan muchas tarjetas dedicadas convencionales.
Microsoft y NVIDIA también han preparado nuevas opciones de Windows 11 para gestionar la memoria destinada a la GPU, facilitando su asignación en equipos RTX Spark sin recurrir necesariamente a cambios desde la BIOS. En las configuraciones de 128 GB, NVIDIA contempla dedicar hasta 111 GB a la GPU, dejando una parte para el sistema y las aplicaciones.
Esto proporciona un margen importante frente a los aproximadamente 60 GB necesarios para almacenar DeepSeek-V4-Flash. Por el contrario, las configuraciones RTX Spark de 24 o 32 GB no disponen de capacidad suficiente para mantener íntegramente ese modelo en memoria gráfica, mientras una variante de 64 GB tendría mucho menos espacio para la caché y otros recursos.
La plataforma también se ha anunciado con capacidad para ejecutar modelos de 120.000 millones de parámetros y ventanas de contexto de hasta un millón de tokens. Sin embargo, esa cifra corresponde a otros escenarios de uso y no demuestra que DeepSeek-V4-Flash pueda aprovechar automáticamente un millón de tokens de contexto dentro de los 128 GB disponibles.
Microsoft executive Pavan Davuluri says it’s possible for RTX Spark laptops to run 284B AI models like DeepSeek-V4.1-Flash with a 1.6-bit quantization, meaning that with just 60GB of total system memory, you can run these dense open-weight models that can seemingly rival OpenAI’s GPT-5
— Omar Sohail (@omarsohail90) October 8, 2026
Microsoft destaca su capacidad frente a modelos comerciales
Durante la presentación, Pavan Davuluri destacó que los modelos de pesos abiertos están alcanzando resultados competitivos frente a sistemas propietarios. La información difundida sobre DeepSeek-V4-Flash menciona comparaciones favorables frente a GPT-5 en determinadas pruebas de programación y razonamiento, aunque no se han aportado suficientes detalles para establecer una superioridad general.
Es importante distinguir entre el rendimiento obtenido por el modelo original y el de una versión cuantizada a 1,6 bits. Reducir drásticamente la precisión puede modificar los resultados, especialmente en tareas complejas, por lo que una comparación válida necesitaría especificar los benchmarks, las configuraciones utilizadas y las pérdidas introducidas por la cuantización.
Tampoco se han comunicado cifras verificadas de tokens por segundo para DeepSeek-V4-Flash en RTX Spark. La capacidad de cargar un modelo no garantiza que su velocidad resulte adecuada para programación interactiva o agentes autónomos, especialmente cuando aumenta la longitud del contexto y deben mantenerse grandes cantidades de información en memoria.
La IA local gana protagonismo frente a los servicios en la nube
La posibilidad de ejecutar modelos de cientos de miles de millones de parámetros directamente en un portátil abre nuevas opciones para desarrolladores que trabajan con código, documentación privada o información empresarial. Mantener los datos localmente puede reducir la dependencia de servicios externos, aunque la privacidad también dependerá del software y las conexiones utilizadas por cada aplicación.
Microsoft pretende integrar estas capacidades en su estrategia de inteligencia híbrida para Windows 11, combinando modelos locales y servicios en la nube según la complejidad de cada tarea. Las cargas más sencillas podrían ejecutarse en el propio equipo, mientras los problemas que requieran mayor capacidad seguirían utilizando infraestructura remota.
El anuncio también refuerza el posicionamiento de RTX Spark como plataforma para IA local, más allá de sus funciones gráficas y gaming. Su principal ventaja en este escenario está en combinar aceleración CUDA con grandes cantidades de memoria unificada, aunque el consumo energético y el ancho de banda seguirán condicionando el rendimiento.
Por ahora, la ejecución de DeepSeek-V4-Flash con aproximadamente 60 GB debe entenderse como una capacidad presentada por Microsoft, pendiente de validación independiente en equipos comerciales. Los primeros portátiles RTX Spark comenzarán a llegar el 16 de octubre, momento en el que será posible comprobar la velocidad real, la precisión del modelo cuantizado y el contexto máximo utilizable.
Vía: Wccftech