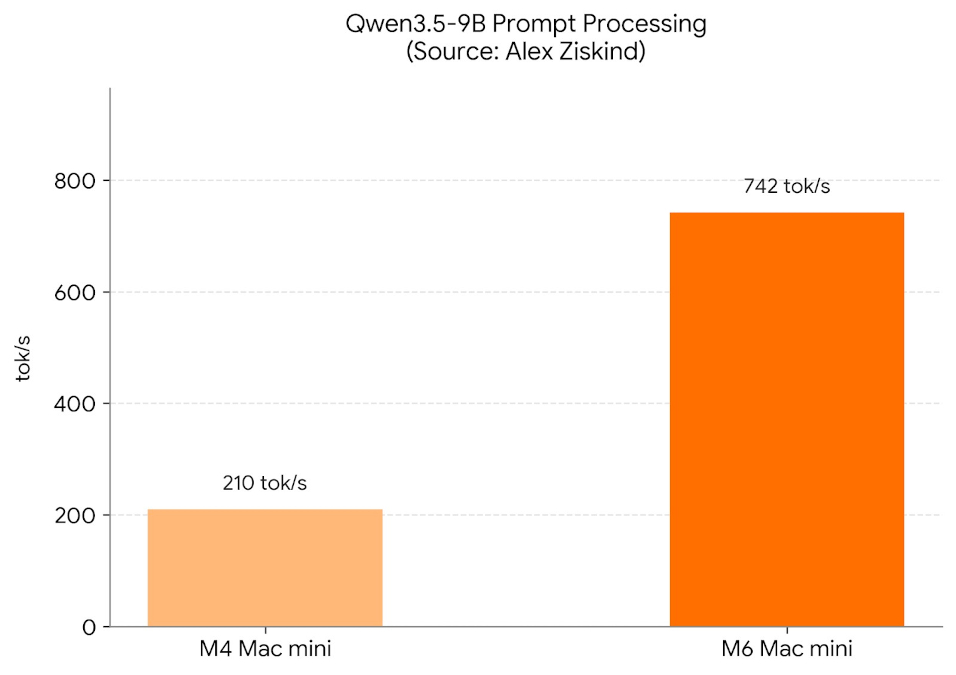
El nuevo Mac mini con M6 ha mostrado una mejora especialmente grande frente al M4 al ejecutar modelos de inteligencia artificial localmente. En las pruebas realizadas por el creador Alex Ziskind, el nuevo equipo alcanza 742 tokens/s procesando prompts con Qwen3.5-9B cuantizado a 4 bits, frente a solo 210 tokens/s del Mac mini M4, una diferencia de aproximadamente el 253%.
La ventaja se repite en generación de texto, latencia e imágenes, aunque con magnitudes muy distintas según la carga. El resultado encaja con los principales cambios del M6: GPU de 12 núcleos con Neural Accelerators en cada núcleo, doble Neural Engine de 16 núcleos y hasta 170 GB/s de ancho de banda de memoria, frente a los 120 GB/s del M4.
El procesamiento de prompts es donde el M6 abre la mayor distancia
Con Qwen3.5-9B, el M6 alcanza 742 tokens/s frente a 210 tokens/s del M4 durante el procesamiento del prompt. No hablamos de una mejora marginal: el nuevo Mac mini procesa esta fase unas 3,5 veces más rápido, precisamente donde se prepara el contexto que posteriormente utilizará el modelo para generar la respuesta.
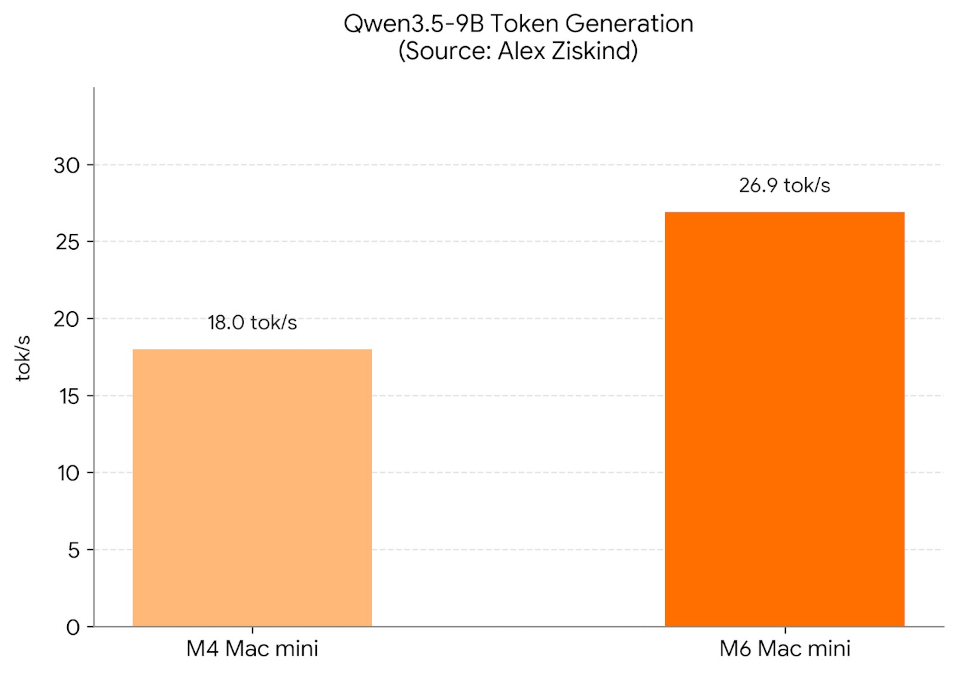
La diferencia resulta mucho menor una vez comienza la generación. El M6 registra 26,9 tokens/s frente a 18 tokens/s, aproximadamente un 49% más. Que el salto cambie tanto entre ambas fases es importante: procesar el contexto y generar cada nuevo token no presionan exactamente los mismos cuellos de botella, por lo que una misma mejora arquitectónica no escala de forma uniforme durante toda la inferencia.
El mayor ancho de banda puede tener bastante peso aquí. El M6 alcanza hasta 170 GB/s frente a los 120 GB/s del M4, aproximadamente un 42% más, mientras los Neural Accelerators añadidos a los núcleos de la GPU aumentan específicamente la capacidad para determinadas operaciones de IA. Apple atribuye a estos cambios buena parte del salto generacional.
Los resultados independientes siguen además la misma dirección que las cifras oficiales de Apple, aunque no sean pruebas equivalentes. La compañía anuncia hasta 4,8 veces más rendimiento que el M4 procesando prompts en LM Studio, una cifra obtenida bajo sus propias condiciones y que no debe trasladarse directamente al benchmark de Ziskind.
El primer token llega en 0,72 segundos
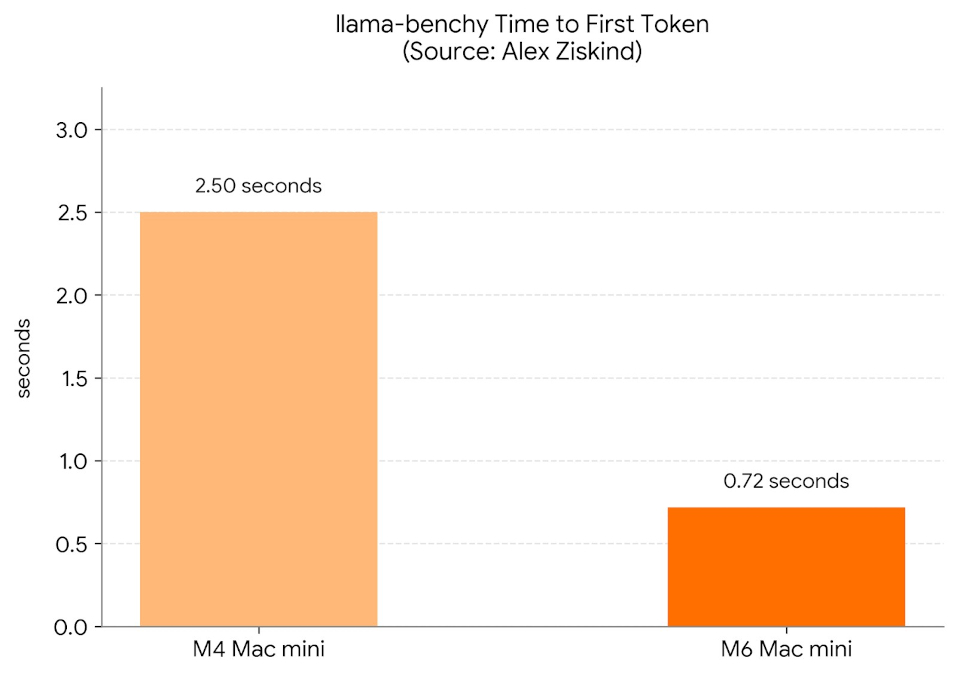
En llama-benchy, el Mac mini M6 necesita 0,72 segundos para producir el primer token, mientras el M4 tarda 2,5 segundos. La reducción supera el 70%, algo especialmente perceptible en uso interactivo porque determina cuánto tiempo transcurre desde que se envía una petición hasta que el modelo empieza a responder.
Esta métrica puede resultar incluso más significativa para un usuario que el número máximo de tokens por segundo. Un modelo que comienza a responder rápidamente ofrece una sensación de menor latencia, aunque posteriormente su velocidad de generación sostenida no aumente en la misma proporción.
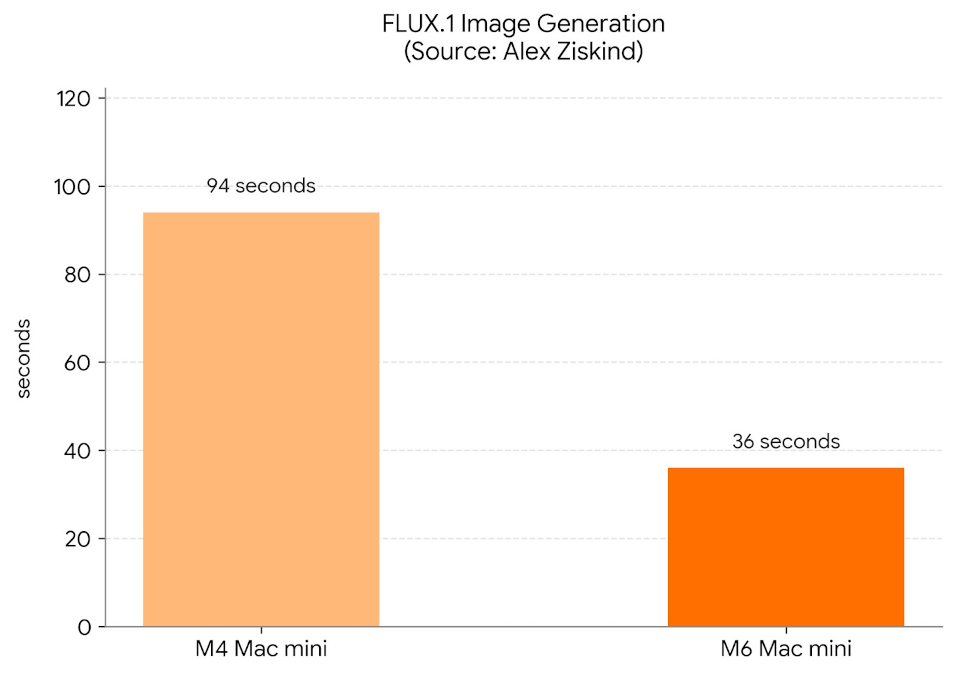
FLUX.1 pasa de 94 a solo 36 segundos
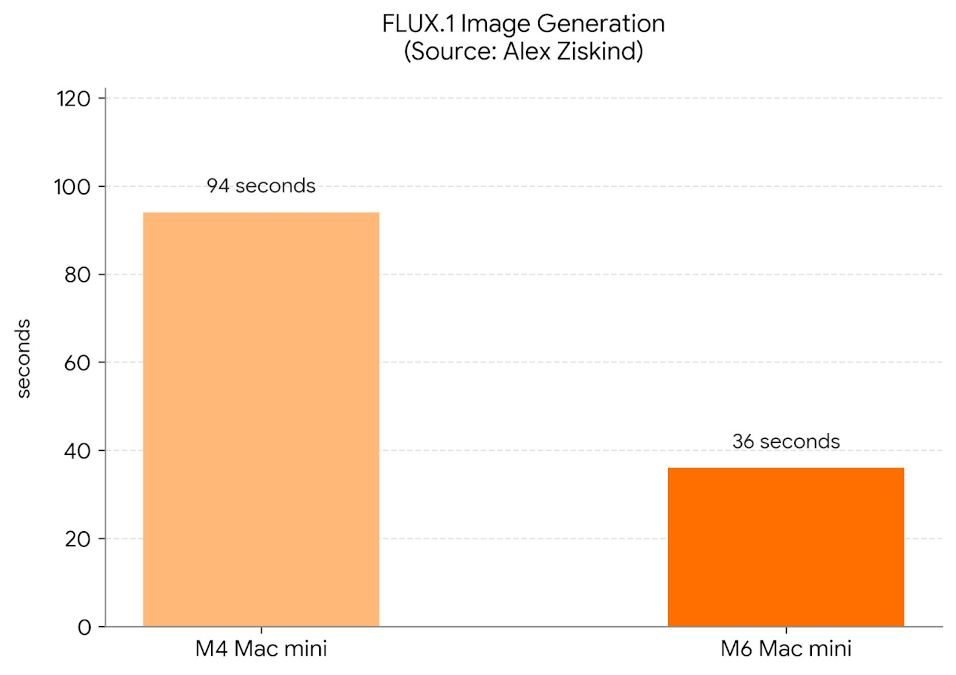
La generación de imágenes muestra otro salto importante. Con una muestra de FLUX.1, el M6 termina el trabajo en 36 segundos frente a 94 segundos del M4, reduciendo el tiempo necesario alrededor de un 61,7%.
Aquí los aceleradores integrados en la GPU adquieren todavía más relevancia. El M6 no se limita a aumentar de 10 a 12 núcleos gráficos, sino que incorpora Neural Accelerators dentro de cada uno, mientras Apple asegura que el nuevo diseño puede multiplicar hasta por cuatro determinadas cargas de IA frente al M4.
Eso tampoco significa que cualquier aplicación de IA vaya a ejecutarse cuatro veces más rápido. Modelo, cuantización, framework, backend gráfico y grado de optimización pueden cambiar completamente el resultado, como ya demuestra la diferencia entre el +253% procesando prompts y el +49% generando tokens dentro de una misma prueba.
Más rendimiento consumiendo 38W frente a 44W
El rendimiento no llega acompañado de un mayor consumo en estas pruebas. Ziskind registró 38W en el Mac mini M6 frente a 44W en el M4, al mismo tiempo que el nuevo modelo completaba las cargas con bastante más rapidez.
La combinación es relevante porque el consumo instantáneo cuenta solo una parte de la historia. Si un trabajo termina mucho antes y además utiliza menos potencia mientras se ejecuta, la energía total necesaria para completar esa tarea puede caer todavía más, una ventaja interesante para sistemas que ejecutan inferencia local durante muchas horas.
Apple mantiene además prácticamente el mismo formato físico del Mac mini. El aumento de rendimiento procede, por tanto, fundamentalmente del nuevo SoC y del subsistema de memoria, no de recurrir a un chasis mayor o a una refrigeración radicalmente diferente.
Los 32 GB no son una ventaja exclusiva del M6 frente al M4
La fuente original señala que los 32 GB de memoria unificada del M6 permiten ejecutar modelos de 27.000 millones de parámetros que no funcionaban en el M4 utilizado en las pruebas. Aquí conviene introducir un matiz importante: el Mac mini M4 también podía configurarse oficialmente con hasta 32 GB de memoria unificada.
Por tanto, 32 GB no representan por sí mismos un aumento de capacidad máxima frente al M4 estándar. Si el modelo grande no podía ejecutarse en el equipo M4 utilizado por Ziskind, la explicación debe buscarse en la configuración concreta probada u otras limitaciones del entorno, no en que la plataforma M4 estuviera limitada necesariamente a menos memoria.
Lo que sí mejora de forma objetiva es el ancho de banda: 170 GB/s en determinadas configuraciones del M6 frente a 120 GB/s en el M4. Para modelos que ya caben completamente en memoria, mover sus pesos y datos más rápidamente puede influir directamente en determinadas etapas de la inferencia.
El salto de precio también es considerable
La contrapartida está en el coste. El Mac mini M6 parte actualmente de 1.069€ en España, mientras el Mac mini M4 debutó en 2024 desde 719€. Son 350€ adicionales entre los precios oficiales de entrada de ambas generaciones.
El salto generacional resulta, por tanto, mucho más evidente en IA que en precio/rendimiento puro. El M6 acelera de forma contundente las cargas locales probadas y mejora además la eficiencia, pero Apple también ha reposicionado económicamente el Mac mini, por lo que estas ganancias ya no llegan al precio especialmente agresivo con el que apareció el M4.
Para quien ejecute LLM o generación de imágenes localmente, los resultados sí muestran un cambio sustancial: el M6 no solo produce más tokens, sino que reduce con fuerza el tiempo de preparación del contexto, la latencia inicial y el tiempo de generación de imágenes, tres aspectos que repercuten directamente en la experiencia de uso.
Vía: Wccftech