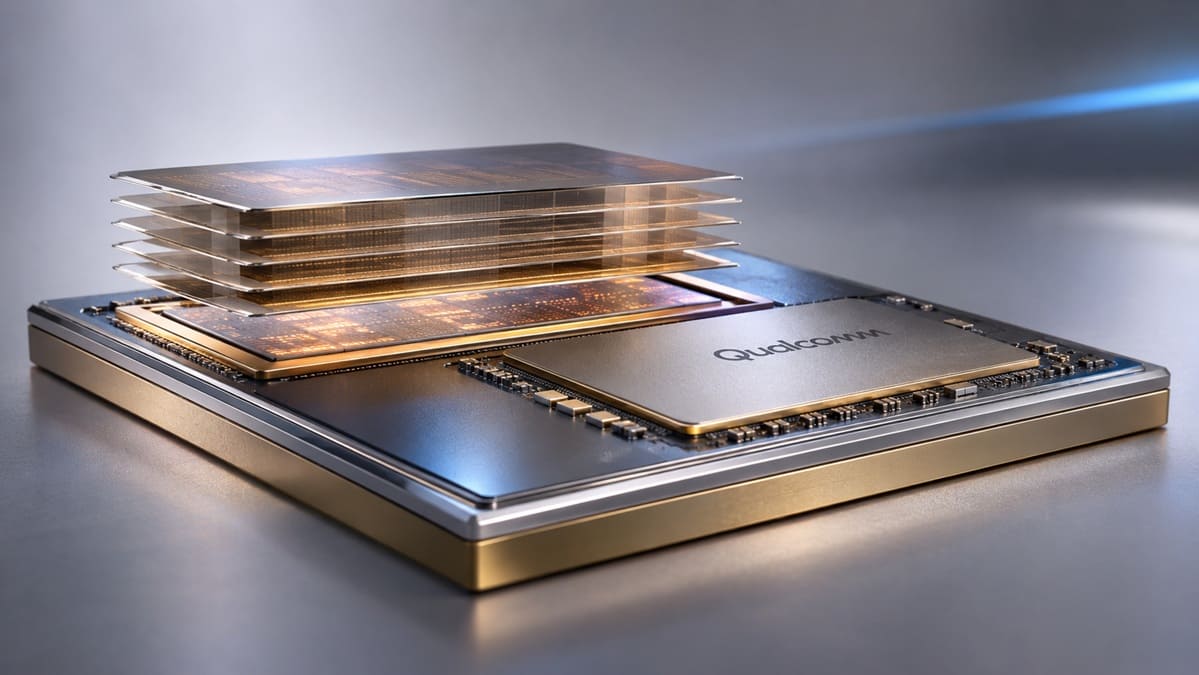
Qualcomm ha completado la validación inicial en silicio de su tecnología High Bandwidth Compute (HBC), una arquitectura que combina memoria LPDDR apilada en 3D con unidades de cálculo situadas directamente bajo las capas de DRAM. Las pruebas realizadas en sus laboratorios de San Diego han confirmado operaciones de lectura, escritura y procesamiento próximo a la memoria.
La compañía también ha registrado una eficiencia de ancho de banda por vatio superior a cinco veces la referencia de HBM4, acercándose a su objetivo inicial de multiplicarla por seis. La tecnología llegará al acelerador Dragonfly AI250, diseñado para alcanzar 133 TB/s de ancho de banda efectivo por tarjeta, cuyas primeras muestras comerciales están previstas para 2027.
Qualcomm integra el procesamiento bajo las capas de memoria LPDDR
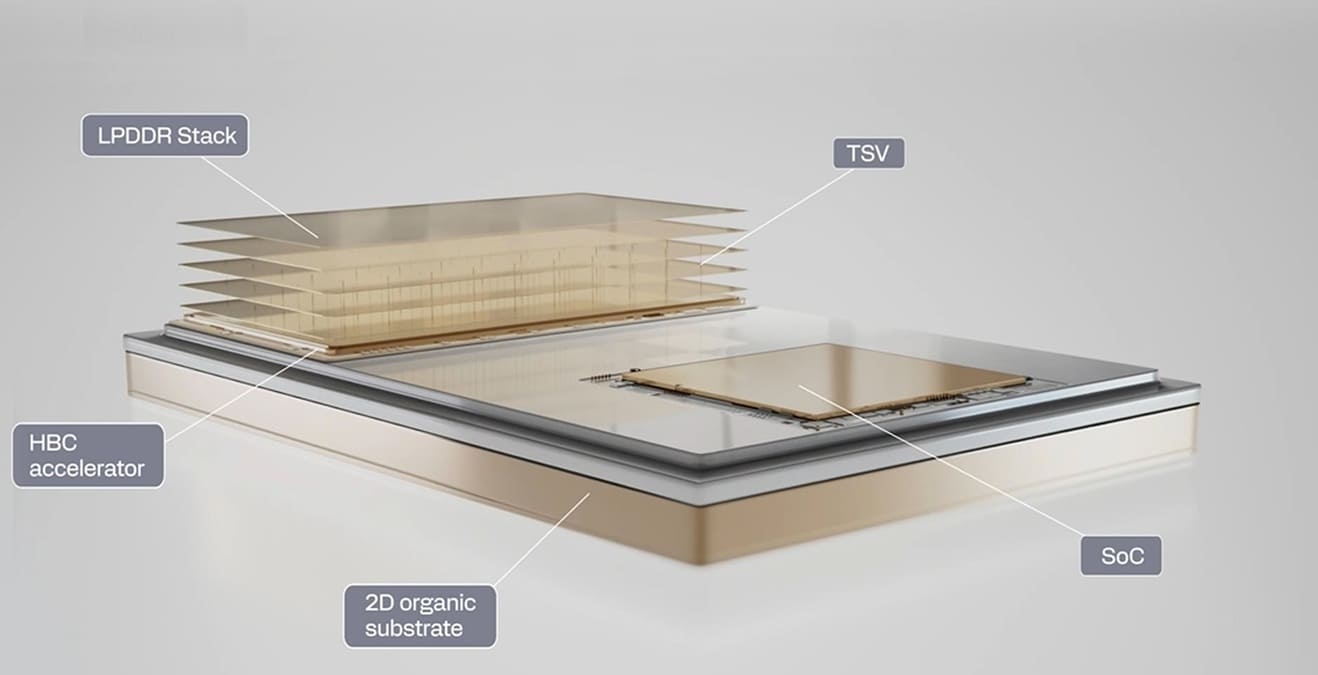
La arquitectura HBC utiliza capas de memoria LPDDR interconectadas mediante vías a través del silicio (TSV), situadas sobre un die que incorpora unidades especializadas de procesamiento. Esta disposición permite ejecutar determinadas operaciones cerca de los datos almacenados, evitando que toda la información tenga que desplazarse continuamente hasta el procesador principal del acelerador.
El planteamiento comparte elementos con HBM4, que también utiliza memoria DRAM apilada sobre un die base de lógica. Sin embargo, Qualcomm busca ampliar las funciones de procesamiento ejecutadas directamente bajo la memoria, en lugar de limitar esta estructura a tareas relacionadas principalmente con la comunicación, el control y la gestión de los datos.
La diferencia tiene consecuencias importantes para el ancho de banda efectivo. Procesar información dentro de la propia pila permite aprovechar conexiones internas sin trasladar todos los datos al exterior. Así, determinadas operaciones pueden utilizar un volumen de información superior al que sería posible transferir continuamente mediante las conexiones convencionales entre memoria y procesador.
Qualcomm también pretende reducir las distancias recorridas por los datos desde varios centímetros hasta unas pocas micras. Esta proximidad puede disminuir la energía destinada a las comunicaciones internas, aunque la mejora depende de las operaciones ejecutadas localmente y de cuánto tráfico se evita realmente, no únicamente de utilizar memoria LPDDR.
La validación utiliza dos capas de DRAM y mejora la eficiencia frente a HBM4
Las primeras muestras verificadas incorporan dos capas de memoria DRAM, mientras que las configuraciones comerciales están previstas con cuatro. Qualcomm ha utilizado equipos automatizados de comprobación para evaluar el funcionamiento de los chips como dispositivos LPDDR5X convencionales y como estructuras HBC, confirmando las capacidades adicionales de procesamiento próximo a los datos.
En estas condiciones, la compañía ha medido una eficiencia de ancho de banda por vatio más de cinco veces superior a la referencia de HBM4. La comparación utiliza resultados internos de Qualcomm y especificaciones publicadas de HBM4, por lo que no equivale a enfrentar dos aceleradores completos ejecutando las mismas aplicaciones.
El resultado se aproxima al objetivo de seis veces anunciado anteriormente, pero todavía existe una diferencia importante entre las muestras actuales y el producto definitivo. Duplicar el número de capas introduce nuevas exigencias de interconexión, integridad de señal y disipación térmica, que deberán evaluarse antes de trasladar estas mejoras a una fabricación comercial.
La refrigeración merece especial atención porque el die inferior no se limita a gestionar accesos a memoria. Las unidades de procesamiento también generan calor bajo las capas de DRAM, cuya temperatura debe mantenerse dentro de los márgenes operativos. Qualcomm ha realizado comprobaciones térmicas, aunque todavía no ha publicado resultados detallados sobre cargas sostenidas.
El Dragonfly AI250 apunta a 133 TB/s y hasta 768 GB de memoria por tarjeta
Qualcomm utilizará HBC Gen 1 en el Dragonfly AI250, diseñado para alcanzar 133 TB/s de ancho de banda efectivo por tarjeta, una mejora prevista de 18 veces respecto al AI200 equipado con LPDDR5X. El fabricante también anuncia una capacidad de 768 GB de memoria por tarjeta, destinada a ejecutar modelos de inteligencia artificial de gran tamaño.
Es importante diferenciar el ancho de banda efectivo del volumen de información transferido físicamente por las interfaces externas. Los 133 TB/s representan una característica prevista del acelerador completo, no de cada módulo HBC. Parte de esa capacidad efectiva procede de realizar operaciones dentro de las propias estructuras de memoria, evitando movimientos adicionales de datos.
Esta diferencia impide equiparar directamente los 133 TB/s con las cifras convencionales de ancho de banda de otras tarjetas gráficas. Una arquitectura puede aumentar su capacidad efectiva de procesamiento de datos sin incrementar proporcionalmente el tráfico externo, aunque el resultado práctico dependerá de las operaciones que puedan ejecutarse dentro de HBC.
La propuesta también contempla sistemas de mayor escala. Qualcomm anuncia hasta 43 TB de memoria y aproximadamente 7,4 PB/s de ancho de banda efectivo por rack AI250, utilizando 56 tarjetas. Estas especificaciones muestran las ambiciones de la plataforma, pero todavía deberán comprobarse con aceleradores completos y cargas de trabajo representativas.
La generación de tokens será una de las principales pruebas de HBC
El principal campo de aplicación será la fase de generación de tokens de los modelos de lenguaje, conocida como decode. Durante este proceso, el sistema accede repetidamente a los parámetros del modelo para calcular cada nuevo token, de modo que el ancho de banda disponible puede limitar el aprovechamiento de las unidades de cálculo.
Este comportamiento difiere del procesamiento inicial de una solicitud, denominado prefill, que puede aprovechar mejor operaciones paralelas de elevada intensidad de cálculo. HBC está especialmente orientada a reducir los cuellos de botella asociados al acceso a memoria, por lo que sus ventajas no tienen por qué ser equivalentes en ambas fases de inferencia.
La arquitectura también encaja con sistemas de inferencia desagregada, donde diferentes aceleradores pueden especializarse en tareas concretas. El AI250 podría concentrarse en operaciones limitadas por memoria mientras otros procesadores ejecutan cargas más intensivas en cálculo, aunque esta distribución requiere coordinar los dispositivos y evitar que las comunicaciones entre ellos introduzcan nuevas limitaciones.
Otro factor determinante será el software. Para aprovechar HBC, las operaciones deben poder distribuirse eficazmente entre el procesamiento próximo a la memoria y las unidades principales del acelerador. Las funciones incompatibles con esta organización seguirán necesitando transferencias convencionales, reduciendo las ventajas obtenidas en escenarios especialmente favorables.
Qualcomm todavía no ha facilitado todos los datos necesarios para comparar directamente su propuesta con aceleradores de NVIDIA o AMD. Faltan benchmarks independientes de inferencia, cifras detalladas de capacidad de cálculo y mediciones sostenidas de tokens por segundo y por vatio, esenciales para evaluar el rendimiento más allá de las estimaciones de ancho de banda.
Las primeras muestras comerciales del Dragonfly AI250 con HBC Gen 1 están previstas para mediados de 2027. La validación demuestra que Qualcomm ha conseguido integrar memoria y procesamiento en silicio funcional, pero su ventaja competitiva dependerá de trasladar esa eficiencia a sistemas completos, con resultados reproducibles y un coste operativo favorable.
Vía: TechPowerUp