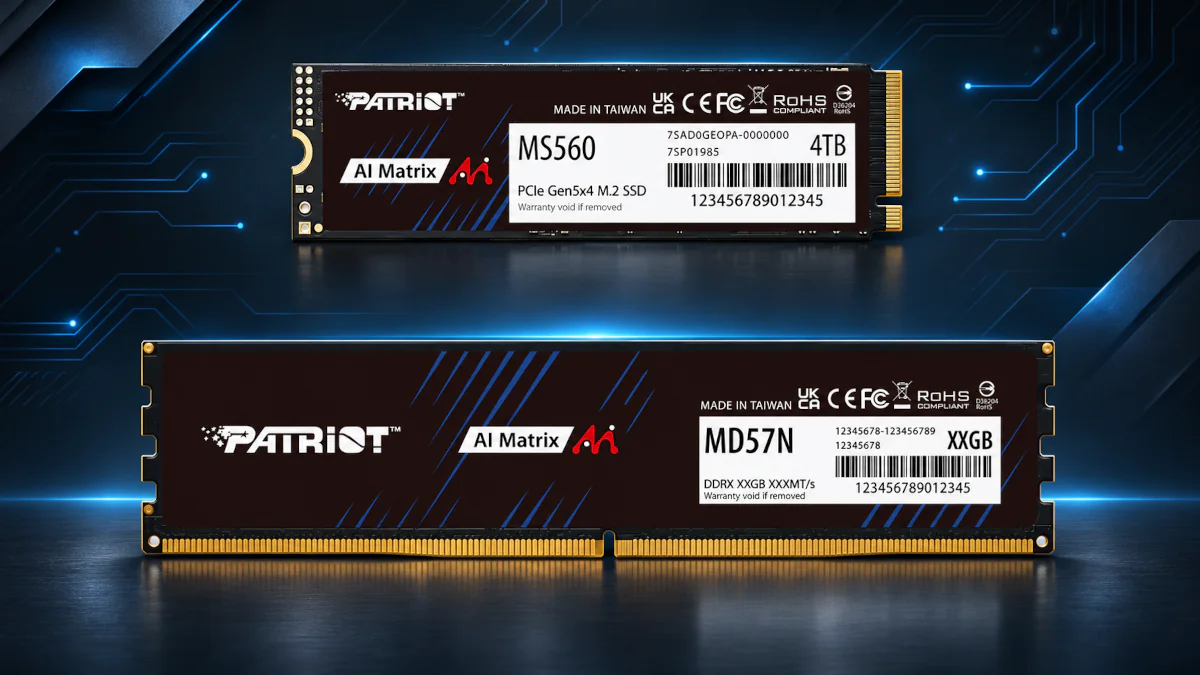
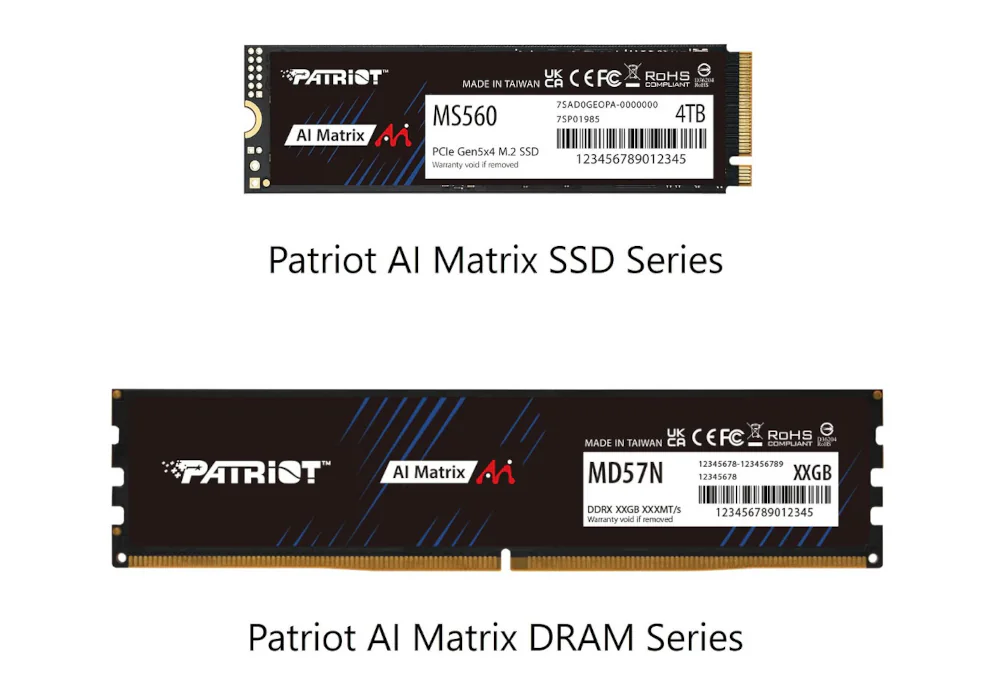
Patriot Memory ha presentado AI Matrix, una nueva familia de memorias DDR5 y SSDs NVMe M.2 2280 orientada a ejecutar modelos de inteligencia artificial directamente en el PC. La gama se divide en tres niveles, PRO, Mid y Entry, con distintas capacidades y velocidades para trabajar con modelos de lenguaje de entre 7B y 70B parámetros.
La información publicada por TechPowerUp detalla una propuesta que busca abordar dos limitaciones habituales de la IA local: la memoria necesaria para mantener los modelos cargados y el almacenamiento utilizado para acceder a sus archivos. Sin embargo, combinar componentes de alto rendimiento no garantiza por sí solo una mayor velocidad de generación de respuestas.
Patriot AI Matrix combina tres gamas DDR5 y SSDs según el tamaño de los modelos
La gama superior está formada por los módulos DDR5 AI Matrix MD57N y el SSD MS560, orientados a modelos de entre 34B y 70B parámetros. El kit de memoria ofrece 64 GB en dos módulos de 32 GB, con velocidades de hasta 6.000 MT/s mediante overclocking, mientras que el almacenamiento utiliza PCIe 5.0 x4.
En esta configuración, el MS560 alcanza hasta 14.000 MB/s de lectura y 11.000 MB/s de escritura secuencial, velocidades correspondientes a la versión de 4 TB. También existen capacidades de 1 y 2 TB, aunque sus prestaciones máximas no tienen por qué coincidir con las del modelo de mayor capacidad.
Las otras dos gamas reducen tanto la velocidad del almacenamiento como la memoria disponible. Mid utiliza DDR5 de 32 GB a 6.000 MT/s y PCIe 4.0, mientras que Entry combina 32 GB de DDR5 a 5.600 MT/s con un SSD PCIe 3.0, suficiente para determinadas aplicaciones menos exigentes.
| Gama | Memoria DDR5 | SSD NVMe |
|---|---|---|
| PRO (34B-70B) | MD57N, 64 GB, 6.000 MT/s (OC) | MS560, PCIe 5.0, hasta 14.000/11.000 MB/s |
| Mid (14B-34B) | MD55N, 32 GB, 6.000 MT/s (OC) | MS450, PCIe 4.0, hasta 5.000/4.500 MB/s |
| Entry (7B-14B) | MD35N/MD34N, 32 GB, 5.600 MT/s | MS350, PCIe 3.0, hasta 3.000/2.000 MB/s |
Velocidades máximas de lectura/escritura secuencial anunciadas por Patriot.
Los SSDs PRO y Mid ofrecen capacidades de 1, 2 y 4 TB, mientras que Entry parte de 512 GB y alcanza los 2 TB. Estas opciones permiten adaptar el almacenamiento al número de modelos instalados, aunque el tamaño de un LLM no determina automáticamente la cantidad de RAM necesaria, especialmente cuando se utilizan distintas técnicas de cuantización.
La velocidad del SSD influye en la carga de modelos, no necesariamente en la inferencia
La principal diferencia entre las tres gamas aparece al cargar modelos de gran tamaño desde el almacenamiento hasta la memoria del sistema. Un SSD más rápido puede reducir el tiempo necesario para abrir archivos de pesos que ocupan decenas de gigabytes, especialmente cuando se trabaja con distintos modelos durante una misma sesión.
Sin embargo, la generación de tokens depende principalmente de la CPU, la GPU y el subsistema de memoria. Una vez que el modelo está cargado, pasar de un SSD PCIe 3.0 a otro PCIe 5.0 no implica multiplicar automáticamente la velocidad de respuesta. El beneficio será diferente si parte del modelo necesita acceder continuamente al almacenamiento.
La propia web de Patriot incluye resultados de pruebas realizadas con llama.cpp. Para un modelo de la categoría superior, el fabricante registra 1.055,9 segundos de carga con el MS560 PCIe 5.0, frente a 1.168,3 segundos con el MS350 PCIe 3.0. La diferencia ronda el 10%, pese al considerable salto de velocidad secuencial anunciado entre ambas unidades.
Estos resultados ilustran por qué las velocidades máximas de lectura no deben confundirse con el rendimiento real de una aplicación de IA. También intervienen la descompresión, la inicialización del modelo y otros procesos. En aplicaciones RAG, donde se consultan bases de datos locales, pueden adquirir mayor importancia la latencia y los accesos aleatorios.
Patriot utilizará benchmarks mensuales con Llama, Gemma y CodeLlama
Para evaluar las configuraciones, Patriot anuncia pruebas mensuales con diferentes modelos de lenguaje, incluidos Llama, Gemma y CodeLlama. Las mediciones contemplan tanto el procesamiento inicial de instrucciones como la generación posterior de respuestas, dos operaciones con necesidades de procesamiento distintas.
La metodología incluye pp512 para evaluar el procesamiento de prompts y tg128 para medir la generación de tokens. Estas pruebas permiten comparar el comportamiento de distintas configuraciones bajo cargas definidas, aunque sus resultados no representan necesariamente la experiencia con documentos extensos, contextos mayores o múltiples usuarios simultáneos.
También se contemplan pruebas prolongadas de estabilidad térmica y funcionamiento continuo. Patriot asegura utilizar chips de memoria seleccionados y unidades NAND de alta resistencia, pero todavía resulta necesario conocer parámetros como TBW, tipo de memoria NAND, temperaturas sostenidas y condiciones de las pruebas para determinar qué ventajas ofrecen respecto a componentes convencionales.
La publicación periódica de resultados podría facilitar comparaciones cuando evolucionen los modelos de IA. No obstante, la utilidad de estos benchmarks dependerá de la transparencia de las configuraciones utilizadas, especialmente en lo relativo a cuantización, aceleración GPU, memoria disponible y versiones del software. Las pruebas internas tampoco sustituyen una evaluación independiente.
La capacidad de RAM y la GPU seguirán siendo determinantes para la IA local
Una cuestión importante es que los kits recomendados por Patriot no garantizan que cualquier modelo del rango anunciado funcione correctamente. Por ejemplo, ejecutar un modelo de 70B parámetros con 64 GB de RAM puede requerir cuantización para reducir su tamaño, además de reservar memoria para el sistema operativo y el contexto de inferencia.
También debe considerarse la memoria gráfica disponible y la posibilidad de descargar parte del procesamiento en la GPU. Un equipo con almacenamiento PCIe 5.0 y DDR5 rápida puede seguir ofreciendo una generación de tokens limitada si depende exclusivamente de una CPU con poco ancho de banda efectivo.
La ejecución local ofrece ventajas en determinados entornos, como trabajar sin conexión y mantener información sensible en el propio sistema. Sin embargo, estas características dependen igualmente de la aplicación utilizada. Además, eliminar las tarifas recurrentes de una API no significa que el procesamiento sea gratuito, porque persisten los costes de hardware, electricidad y mantenimiento.
Por ahora, Patriot no ha comunicado precios oficiales ni fechas concretas de disponibilidad para España. Esta información será fundamental para determinar si AI Matrix resulta competitiva frente a otras memorias DDR5 y SSDs NVMe que ya pueden utilizarse para ejecutar exactamente las mismas aplicaciones.
En definitiva, AI Matrix plantea una clasificación de componentes basada en distintos tamaños de modelos de IA, pero su principal valor deberá demostrarse mediante resultados reproducibles y precios competitivos. La capacidad de memoria, la cuantización y la aceleración disponible seguirán teniendo más importancia para la inferencia que elegir un SSD únicamente por su velocidad secuencial.
Vía: TechPowerUp