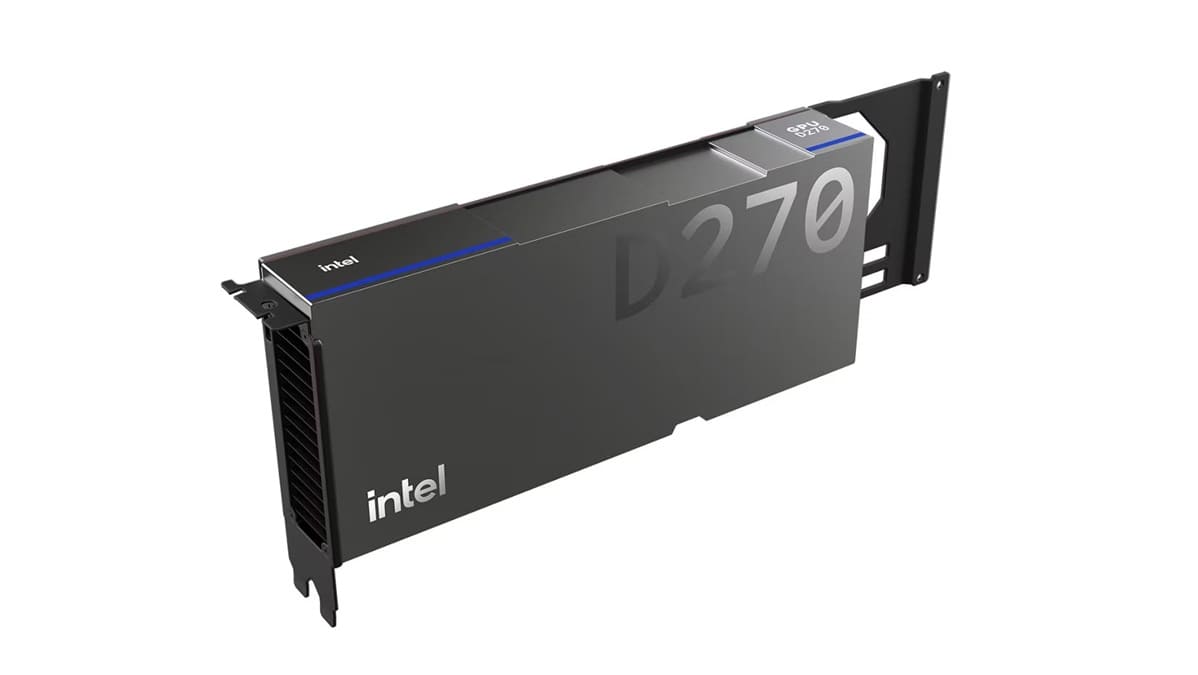
Intel ha presentado oficialmente la GPU D270, el primer acelerador de la nueva serie D, anteriormente conocida como Crescent Island. Diseñado para la inferencia de inteligencia artificial, incorpora 32 núcleos Xe3P, 256 motores XMX y hasta 480 GB de memoria LPDDR5X, con una potencia máxima anunciada de 1,3 PFLOPS en FP8 y un consumo de 350W.
La compañía ha detallado sus características durante el Open Compute Project Global Summit 2026, confirmando también un ancho de banda de memoria de hasta 1,5 TB/s y conectividad PCIe 5.0. Intel busca ofrecer una alternativa para ejecutar modelos de lenguaje y aplicaciones de IA con contextos extensos, apostando por gran capacidad de memoria, refrigeración por aire y compatibilidad con infraestructuras de servidores convencionales.
Xe3P introduce motores XMX rediseñados para acelerar las operaciones matriciales
La arquitectura Xe3P representa una evolución de los núcleos Xe utilizados por Intel, pero adaptada específicamente al procesamiento de inteligencia artificial. La GPU D270 integra 32 Xe-cores, 256 motores vectoriales y 256 unidades matriciales XMX, acompañados de una caché L2 unificada de 32 MB.
Cada núcleo dispone de ocho motores vectoriales y ocho motores XMX, además de un archivo de registros de 1 MB y 512 KB de memoria local L1/SLM. Esta organización permite mantener datos próximos a las unidades de cálculo, algo importante en operaciones matriciales donde mover información constantemente entre distintos niveles de memoria puede limitar el aprovechamiento del hardware.
Una de las novedades técnicas más relevantes es el rediseño de los motores XMX, cuya estructura sistólica pasa de cuatro etapas en Xe3 a 16 en Xe3P. Intel también incorpora compatibilidad con diferentes precisiones, desde FP4 y FP8 hasta FP64, para atender operaciones con requisitos distintos de cálculo y representación numérica.
La cifra de 1,3 PFLOPS corresponde al rendimiento máximo teórico en FP8, un formato de precisión reducida utilizado en determinadas operaciones de redes neuronales. No representa necesariamente la velocidad de ejecución de un modelo completo, donde también intervienen el acceso a memoria, las operaciones no matriciales y la eficiencia del software. Además, Intel ha eliminado recursos de renderizado 3D y ray tracing para dedicar más superficie del chip al cálculo.
Hasta 480 GB LPDDR5X: Intel prioriza la capacidad frente al uso de HBM
La memoria constituye uno de los principales elementos diferenciadores de la D270. La tarjeta de referencia comercializada por Intel contará con 160 GB LPDDR5X, mientras que sus socios fabricantes ODM podrán desarrollar configuraciones con hasta 480 GB, una capacidad especialmente elevada para un acelerador instalado en una única tarjeta PCIe.
Esta elección contrasta con las soluciones que recurren a memoria HBM, habitualmente orientada a proporcionar un ancho de banda muy elevado mediante interfaces especializadas. Intel utiliza LPDDR5X para plantear una combinación diferente de capacidad, consumo y costes, aunque la tecnología HBM puede ofrecer ventajas importantes en cargas especialmente exigentes en ancho de banda.
La compañía anuncia hasta 1,5 TB/s de ancho de banda, pero todavía faltan detalles sobre las prestaciones concretas de las distintas configuraciones de memoria. Por tanto, no debe asumirse que las tarjetas de 160 GB y las futuras variantes de 480 GB presentarán necesariamente el mismo comportamiento en todas las cargas de trabajo.
En aplicaciones de inteligencia artificial, la cantidad de memoria disponible determina cuánto espacio puede reservarse para los parámetros del modelo, los datos temporales y la caché KV, que almacena información utilizada durante el procesamiento de secuencias. Esta última puede crecer considerablemente cuando aumentan la longitud del contexto y el número de solicitudes simultáneas.
La ventaja de una configuración con más memoria es que puede alojar modelos mayores o mantener más sesiones activas sin repartir necesariamente todos los datos entre varias GPU. Sin embargo, la capacidad y el ancho de banda cumplen funciones diferentes: disponer de 480 GB no garantiza una mayor velocidad de generación de tokens, especialmente si el rendimiento termina condicionado por las transferencias de datos o las unidades de cálculo.
Intel apunta a modelos de 300.000 millones de parámetros en una sola tarjeta
Según las cifras anunciadas por Intel, una GPU de la serie D podría ejecutar modelos de hasta 300.000 millones de parámetros, mientras que una configuración con ocho aceleradores permitiría trabajar con modelos superiores al billón de parámetros. Estas estimaciones describen la capacidad prevista de la plataforma y todavía no están acompañadas de resultados independientes de inferencia.
La viabilidad depende especialmente de la precisión utilizada para almacenar los parámetros y de la memoria disponible para el resto de las operaciones. Como referencia teórica, un modelo de 300.000 millones de parámetros representados mediante cuatro bits por parámetro necesitaría aproximadamente 150 GB únicamente para sus pesos, antes de considerar las estructuras auxiliares y los recursos necesarios durante la ejecución.
Esto significa que la capacidad nominal de una tarjeta no puede equipararse directamente al tamaño máximo de un modelo utilizable en condiciones reales. Las técnicas de cuantización, la longitud del contexto y el número de usuarios concurrentes pueden modificar considerablemente las necesidades de memoria, por lo que las afirmaciones de Intel deberán evaluarse con configuraciones y cargas concretas.
El acelerador también incorpora un motor multimedia con cuatro codificadores y cuatro decodificadores, destinado a facilitar operaciones relacionadas con vídeo. Estas unidades pueden resultar útiles en aplicaciones multimodales que combinan información visual y modelos de IA, siempre que los formatos y herramientas empleados sean compatibles.
PCIe 5.0 y refrigeración por aire para servidores existentes
La Intel GPU D270 utiliza una interfaz PCIe 5.0 x16 y presenta un consumo de referencia de 350W, con un diseño preparado para refrigeración pasiva mediante el flujo de aire del servidor. Esta configuración busca facilitar su instalación en infraestructuras convencionales, evitando la necesidad de introducir sistemas de refrigeración líquida específicos.
No obstante, la compatibilidad física con PCIe no elimina los requisitos de alimentación, ventilación y espacio interno. Un servidor equipado con ocho aceleradores de 350W tendría una potencia nominal conjunta de 2.800W únicamente para las GPU, a la que habría que añadir procesadores, memoria, almacenamiento y otros componentes.
Este enfoque puede resultar interesante para operadores que quieran ampliar sus recursos de inferencia sin rediseñar por completo sus instalaciones. La ventaja económica dependerá, en cualquier caso, del rendimiento obtenido por servidor y del coste total de funcionamiento, no solamente del consumo anunciado para cada tarjeta.
El rendimiento por token y el software determinarán su competitividad
Intel plantea la serie D como una plataforma integrada en su ecosistema común de software Xe, con soporte para herramientas utilizadas en inteligencia artificial, como PyTorch y vLLM. Esta compatibilidad será fundamental para facilitar la adaptación de aplicaciones y evitar que los clientes dependan de desarrollos específicos para cada acelerador.
La compañía confirma que el envío de muestras a determinados clientes ya está en marcha, aunque todavía no ha anunciado precios oficiales ni una fecha de disponibilidad general. Tampoco se han publicado pruebas independientes que permitan comparar su rendimiento con el de otras plataformas utilizando los mismos modelos, precisiones y condiciones de ejecución.
La propuesta de Intel resulta especialmente interesante por la combinación de hasta 480 GB de memoria, arquitectura Xe3P y un consumo de 350W, pero su competitividad dependerá de algo más que estas especificaciones. El coste por token generado, la latencia, el rendimiento con múltiples usuarios y la madurez del software serán los factores decisivos para determinar si la D270 consigue hacerse un hueco en el mercado de aceleradores para inferencia.
Vía: TechPowerUp