Thinking Machines Lab ha dado a conocer Inkling 2 Mini, un modelo de inteligencia artificial de 26.400 millones de parámetros diseñado para ejecutar tareas de programación, razonamiento y agentes autónomos sin depender necesariamente de servidores externos. Gracias a una arquitectura que reutiliza determinadas capas de procesamiento, consigue mantener sus requisitos de memoria en aproximadamente 20 GB, permitiendo ejecutarlo sin conexión en Macs con al menos 32 GB de memoria unificada.
El modelo, presentado oficialmente el 20 de noviembre, utiliza una arquitectura denominada Looped Transformer y alcanza 20,1 puntos en el Artificial Analysis Intelligence Index. La propuesta, examinada también por Wccftech, busca ofrecer parte de las capacidades de modelos considerablemente mayores, como Inkling 2 Small, de 594.000 millones de parámetros, pero con unos requisitos de hardware mucho más accesibles.
Una arquitectura que reutiliza sus capas para mejorar el razonamiento
Fuente de la imagen: Thinking Machines.
La principal particularidad de Inkling 2 Mini se encuentra en su diseño basado en Mixture of Experts (MoE), combinado con una arquitectura de procesamiento recurrente. El modelo dispone de 24 capas Transformer, aunque no todas se ejecutan una única vez durante el procesamiento de cada token.
Su funcionamiento divide esas capas en cuatro bloques de seis. Los primeros seis y los últimos seis se ejecutan una vez, mientras que las doce capas centrales se recorren tres veces. Esto permite realizar 48 aplicaciones de capas por token utilizando únicamente los pesos almacenados de 24 capas.
El objetivo es aumentar la cantidad de cálculos internos sin incrementar proporcionalmente los parámetros que deben mantenerse en memoria. En lugar de depender exclusivamente de generar más tokens intermedios para resolver problemas, el modelo puede realizar operaciones adicionales antes de producir la siguiente parte de su respuesta.
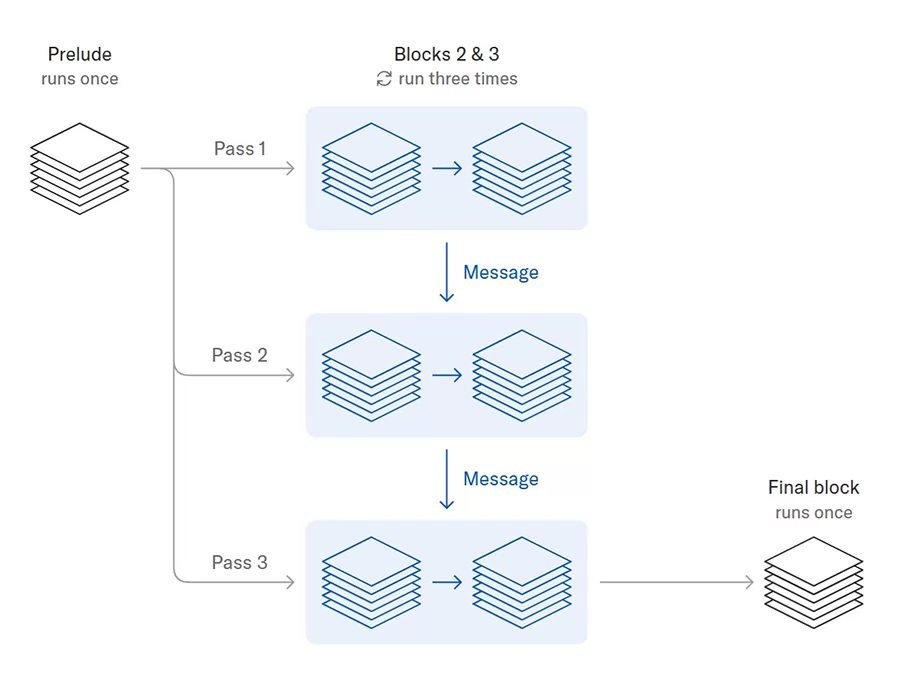
Inkling 2 Mini de Thinking Machines reutiliza sus 12 capas centrales tres veces, mientras que las seis iniciales y las seis finales se ejecutan una sola vez. Así, realiza 48 operaciones de capa por token utilizando únicamente 24 capas, aumentando su capacidad de razonamiento sin añadir más parámetros. Fuente de la imagen: Thinking Machines.
Aunque cuenta con 3.400 millones de parámetros activos por token, la reutilización de capas eleva el procesamiento efectivo a aproximadamente 5.400 millones de activaciones de parámetros. Esta diferencia no significa que el modelo almacene más pesos, sino que vuelve a utilizar parte de ellos durante la inferencia.
Thinking Machines explica que repetir las capas centrales produjo mejores resultados que repetir las últimas doce capas en 27 de 28 evaluaciones. La compañía considera que las capas intermedias desempeñan un papel especialmente importante en el razonamiento abstracto, mientras que las iniciales y finales participan en la interpretación de las entradas y la generación de respuestas.
Resultados competitivos en programación frente a modelos más grandes
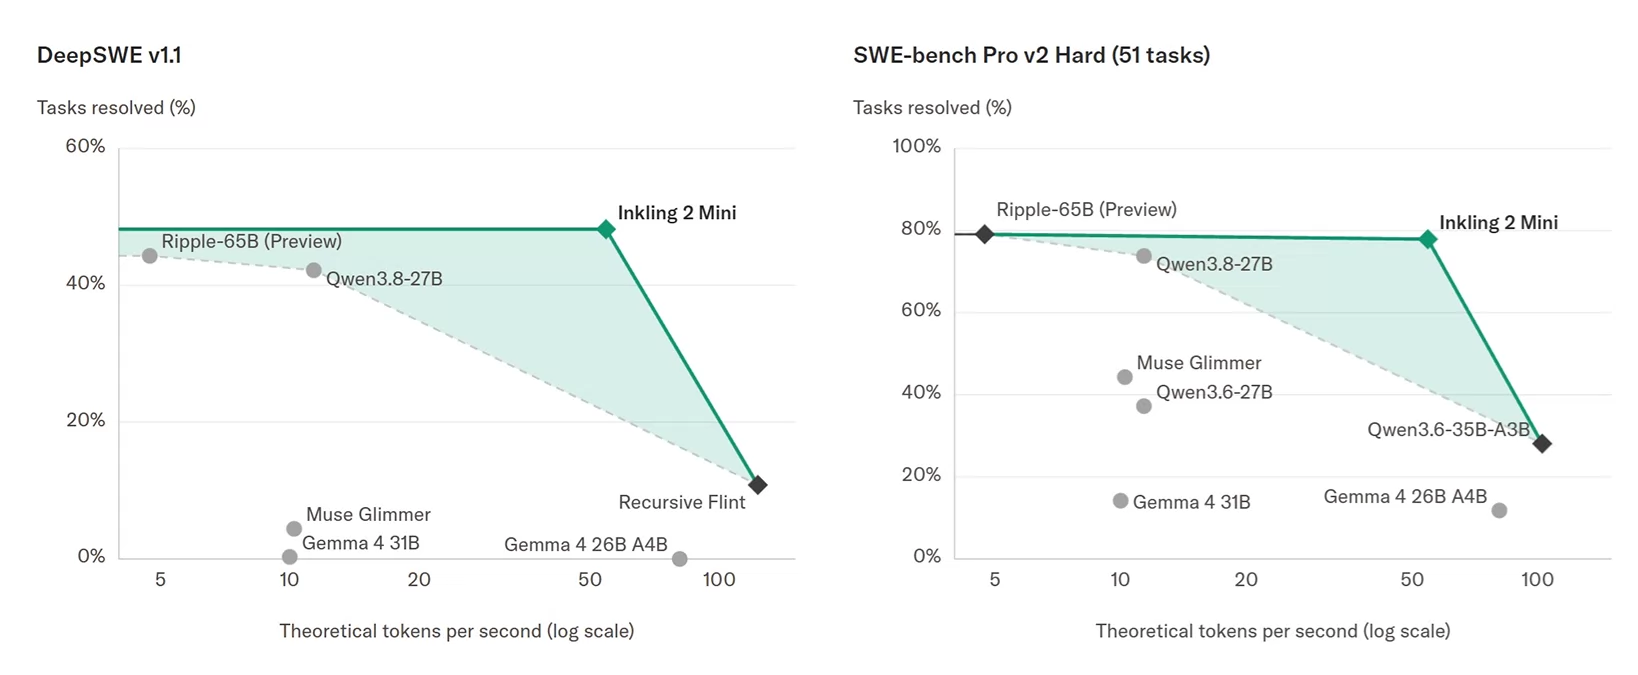
Inkling 2 Mini de Thinking Machines alcanza un 48,2% en DeepSWE v1.1 y un 77,9% en SWE-bench Pro v2 Hard, superando a varios modelos de IA de pesos abiertos y ofreciendo una mayor velocidad teórica de generación de tokens con un rendimiento similar en programación. Fuente de la imagen: Thinking Machines.
Las primeras evaluaciones muestran resultados especialmente interesantes en programación asistida y tareas ejecutadas mediante agentes de IA. Según las cifras publicadas por Thinking Machines, Inkling 2 Mini supera a varios modelos de tamaño similar en pruebas que requieren resolver incidencias de software y completar operaciones de forma autónoma.
Una de las comparaciones más destacadas corresponde a Qwen3.8-27B, frente al que consigue las siguientes puntuaciones:
| Benchmark | Inkling 2 Mini | Qwen3.8-27B |
|---|---|---|
| DeepSWE v1.1 | 48,2% | 42,2% |
| SWE-bench Pro v2 Hard | 77,9% | 73,8% |
| AA Intelligence Index v5.0 | 20,1 | 20,1 |
También alcanza 46,5% en Vals Index v2.2 y 79,2% en SWE-bench Verified, dos referencias adicionales para valorar su rendimiento. No obstante, las comparaciones dependen de las herramientas, configuraciones y procedimientos empleados, por lo que estos resultados no representan una superioridad universal frente a Qwen u otros modelos.
El entrenamiento incorpora otra particularidad técnica. Thinking Machines utilizó la plataforma NVIDIA GB300 Grace Blackwell Ultra, aprovechando la aceleración de operaciones de baja precisión mediante NVFP4.
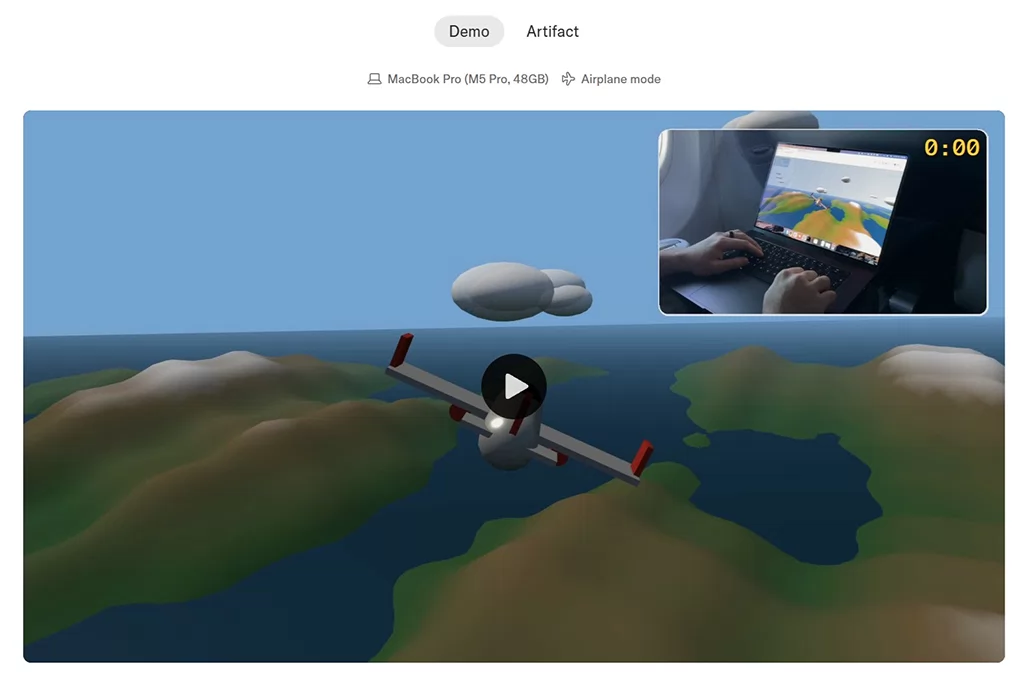
Thinking Machines muestra cómo Inkling 2 Mini genera un simulador de vuelo jugable sin conexión a Internet en un MacBook Pro con chip M5 Pro y 48 GB de memoria unificada, demostrando sus capacidades de programación con IA ejecutada localmente.
En concreto, 20 capas utilizan pesos entrenados en precisión NVFP4 de 4 bits, mientras que las cuatro últimas recurren a MXFP8 de 8 bits. El fabricante distribuye estos pesos en las mismas precisiones empleadas durante el entrenamiento, evitando las pérdidas adicionales que podría introducir una conversión posterior.
Esta combinación contribuye a reducir los requisitos de almacenamiento del modelo sin depender exclusivamente de técnicas tradicionales de cuantización aplicadas después del entrenamiento.
Funciona sin conexión en MacBooks y admite un millón de tokens de contexto
Una de las características más atractivas de Inkling 2 Mini es su capacidad para ejecutarse localmente en hardware de consumo. El modelo se distribuye mediante un archivo de aproximadamente 20 GB, con soporte oficial para MacBook, Mac mini y Mac Studio equipados con Apple silicon y al menos 32 GB de memoria unificada.
La ejecución puede realizarse mediante Ollama, mientras que también se ofrece compatibilidad con el ordenador de IA NVIDIA DGX Spark. Para otras plataformas con GPU dedicada, Thinking Machines recomienda 32 GB de VRAM o más, aunque existen versiones cuantizadas alternativas que pueden modificar estos requisitos.
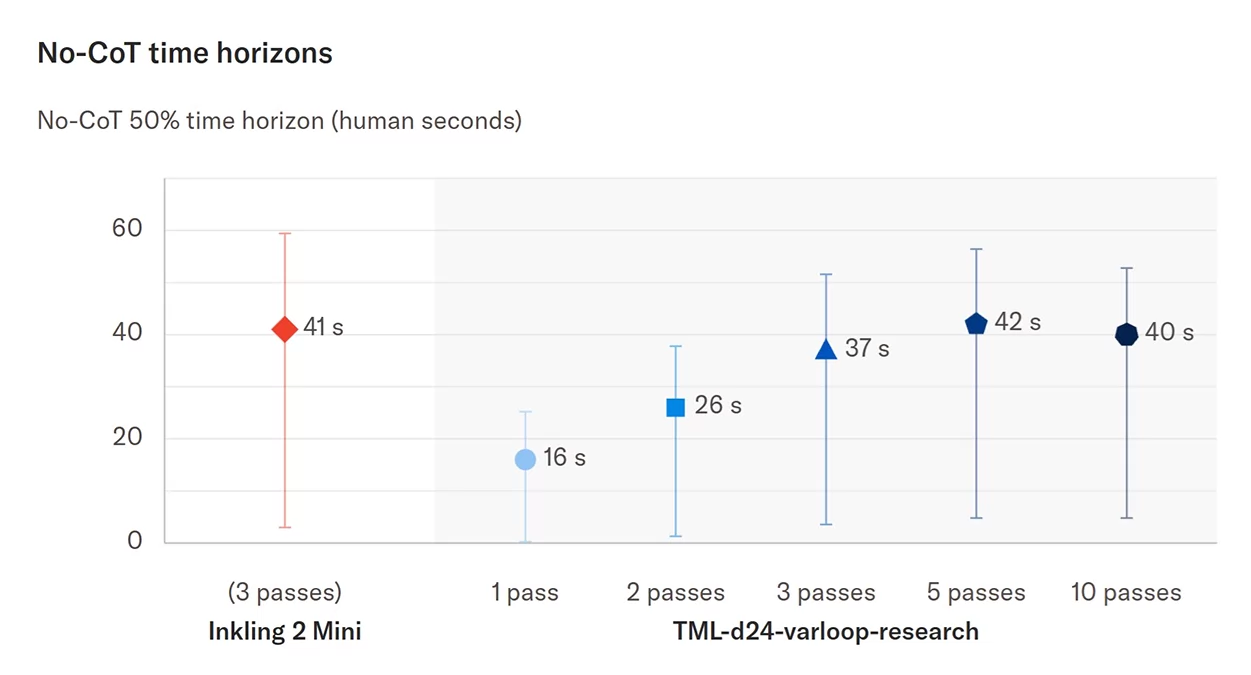
La investigación de Thinking Machines demuestra que repetir las capas Transformer mejora el razonamiento sin generar una cadena de pensamiento explícita. El horizonte de tareas resueltas aumenta de 16 segundos con una pasada a 37 segundos con tres, antes de que las mejoras comiencen a estabilizarse. Fuente de la imagen: Thinking Machines.
El modelo admite entradas de texto e imágenes, genera respuestas de texto y ofrece una ventana de contexto de hasta un millón de tokens. Sin embargo, esta capacidad máxima no significa que pueda utilizarse íntegramente con 32 GB de memoria, ya que los contextos extensos necesitan recursos adicionales para almacenar la información temporal de la inferencia.
Para demostrar su funcionamiento, investigadores de Thinking Machines ejecutaron Inkling 2 Mini en un MacBook Pro con M5 Pro y 48 GB de memoria, completamente desconectado de Internet durante un vuelo. Según la compañía, el modelo consiguió crear un simulador de vuelo jugable en unos minutos, una demostración destinada a mostrar sus capacidades de programación local.
También presentaron Thinkyville, una pequeña localidad virtual con 20 personajes controlados por el mismo modelo, ejecutándose en un único MacBook sin conexión. Aunque ambas demostraciones resultan interesantes, no sustituyen las pruebas independientes sobre velocidad de generación, consumo y rendimiento sostenido.
Thinking Machines investiga los límites del razonamiento interno
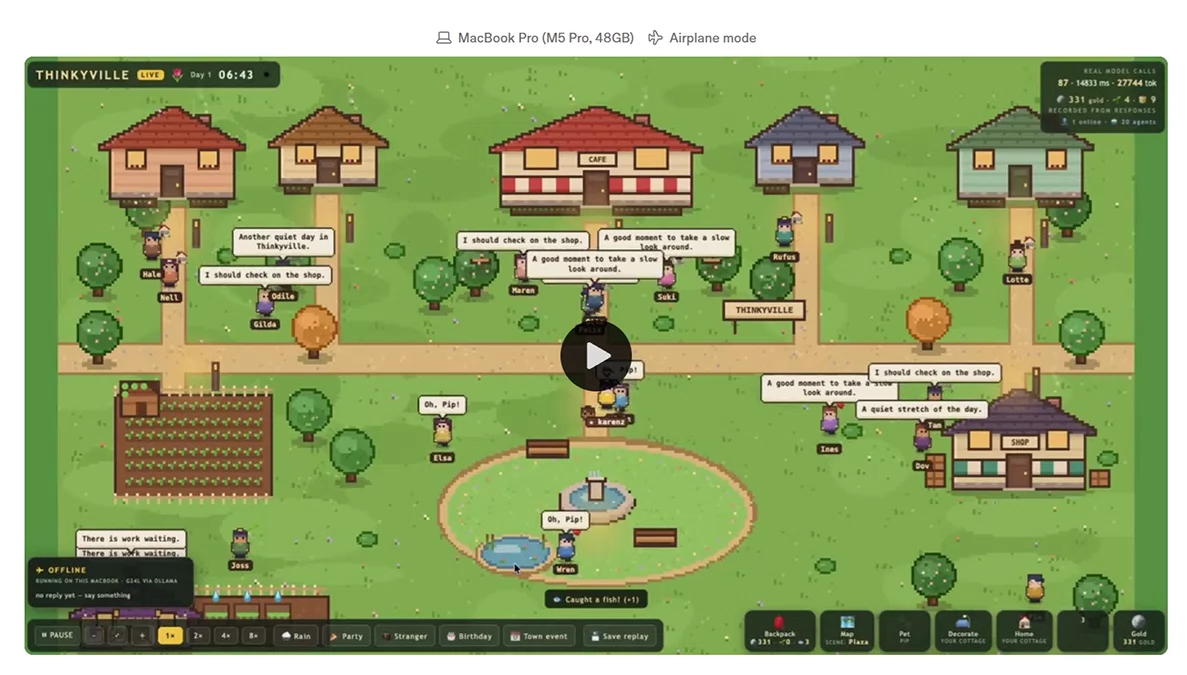
Inkling 2 Mini de Thinking Machines controla a los 20 habitantes autónomos de Thinkyville, una ciudad de estilo pixel art que funciona sin conexión en un único MacBook Pro con 48 GB de memoria unificada. Los personajes planifican sus actividades, interactúan entre sí y responden a los mensajes del jugador. Fuente de la imagen: Thinking Machines.
La reutilización de capas introduce una cuestión adicional: cuánto razonamiento puede realizar un modelo sin reflejarlo explícitamente en su cadena de pensamiento o Chain of Thought (CoT). Esta característica puede mejorar la eficiencia, pero también dificulta conocer determinados pasos internos mediante la simple lectura de las explicaciones generadas.
Para estudiar el problema, Thinking Machines desarrolló TML-d24-varloop-research, una variante experimental que permite modificar el número de repeticiones. A diferencia de Inkling 2 Mini, cuyas tres pasadas están fijadas, este modelo de investigación facilita comparar diferentes profundidades de procesamiento.
En sus experimentos, el horizonte de tareas resueltas sin generar una cadena de pensamiento aumentó de 16 a 37 segundos de tiempo humano equivalente al pasar de una a tres repeticiones. Esta métrica representa la dificultad de las tareas que el modelo puede resolver con una fiabilidad determinada, no el tiempo que tarda en responder.
Los investigadores también observaron una reducción de los tokens utilizados para expresar el razonamiento, aunque sus pruebas no detectaron una pérdida significativa de legibilidad ni una tendencia clara hacia comportamientos más difíciles de supervisar. La compañía reconoce que estos resultados son preliminares y podrían cambiar en modelos de mayor tamaño.
Tampoco todas sus capacidades destacan por igual. Inkling 2 Mini presenta dificultades en conversaciones de múltiples turnos y tareas con numerosas restricciones simultáneas, donde otros modelos, incluido Qwen3.8-27B, obtienen mejores resultados.
El modelo ya está disponible con pesos abiertos bajo licencia Apache 2.0, mediante Hugging Face y Ollama. Los desarrolladores también pueden utilizar Tinker, la plataforma de Thinking Machines para inferencia y ajuste fino.
Inkling 2 Mini representa una alternativa interesante para ejecutar agentes de IA avanzados sin depender constantemente de servicios en la nube, especialmente cuando la privacidad o la disponibilidad sin conexión son prioritarias. Su principal aportación es aumentar el procesamiento interno reutilizando parámetros ya almacenados, aunque su rendimiento real y las implicaciones de esta arquitectura todavía necesitan investigaciones y pruebas adicionales.
Vía: Wccftech