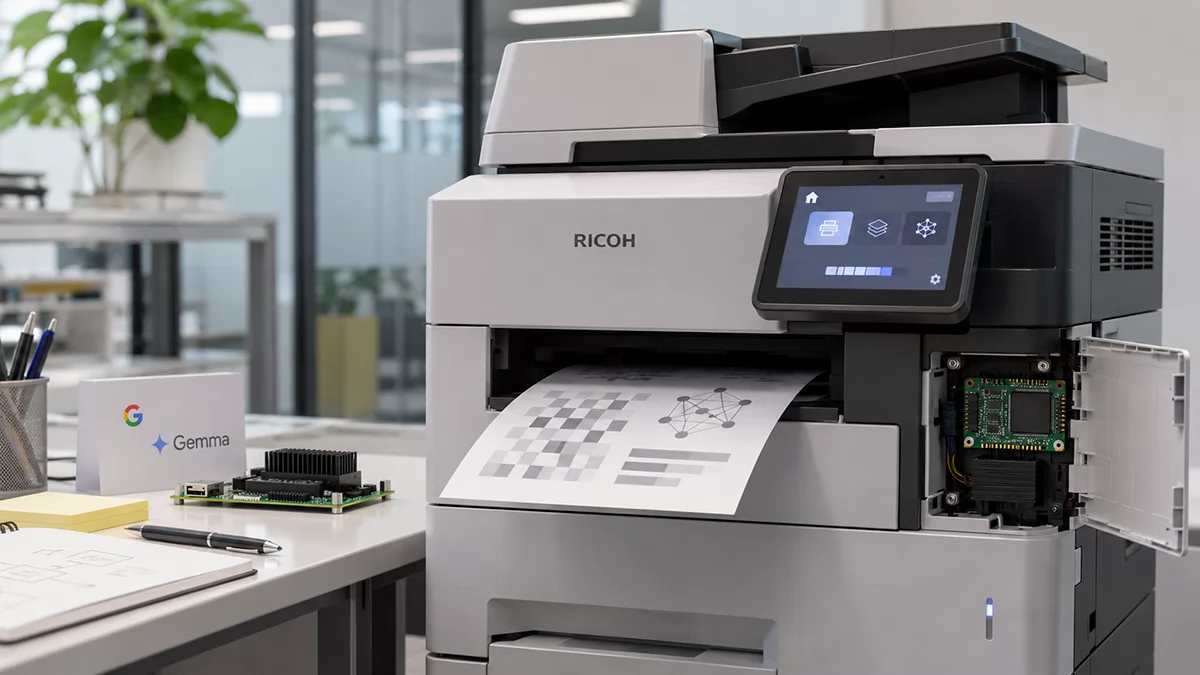
Google Gemma 3 270M, un modelo de inteligencia artificial con 270 millones de parámetros, ha conseguido ejecutarse directamente en una impresora de oficina Ricoh mediante PostScript. El experimento, realizado por Omar Sanseviero, demuestra que es posible realizar inferencia local utilizando apenas 14,1 MB de memoria RAM durante la ejecución, sin recurrir a procesadores externos.
La demostración, compartida por Sanseviero en X y recogida por Wccftech, utiliza una versión cuantizada del modelo y un pequeño motor de inferencia. Sin embargo, la velocidad real es mucho menor de lo que sugiere la información publicada por el medio, ya que el propio investigador habla de aproximadamente un minuto por token.
Gemma 3 270M funciona dentro de una impresora gracias a PostScript
La particularidad del experimento es que no ha sido necesario modificar el firmware de la impresora ni conectar placas de procesamiento adicionales. Todo el procedimiento utiliza PostScript, un lenguaje empleado habitualmente para describir documentos que también permite ejecutar operaciones de programación dentro de los dispositivos compatibles.
PostScript es un lenguaje Turing completo, lo que significa que puede expresar cálculos generales mediante instrucciones, condiciones y estructuras de control. Esta característica permite utilizar su intérprete para operaciones que van mucho más allá de preparar páginas para imprimir, aunque no esté diseñado específicamente para ejecutar modelos de inteligencia artificial.
Con ayuda de Carbon, Sanseviero preparó un pequeño motor de inferencia y una versión cuantizada de Gemma 3 270M, integrándolos en un único archivo de impresión PostScript. La ejecución tuvo lugar dentro del propio dispositivo, utilizando sus recursos de procesamiento y memoria en lugar de delegar las operaciones en un ordenador conectado.
El modelo utiliza 18 capas Transformer, que deben procesarse para generar cada nuevo token. Aunque sus 270 millones de parámetros representan una configuración relativamente pequeña dentro de los modelos de lenguaje actuales, siguen suponiendo una carga considerable para un dispositivo concebido principalmente para gestionar documentos.
La ejecución utiliza 14,1 MB de RAM mediante carga dinámica de capas
Uno de los aspectos más relevantes es el consumo máximo de 14,1 MB de memoria registrado durante la ejecución. La impresora disponía de 244,6 MB de memoria virtual asignada al entorno PostScript, por lo que el experimento consiguió mantener una parte relativamente pequeña de esos recursos ocupada simultáneamente.
Para conseguirlo, el sistema utiliza carga dinámica de capas, un procedimiento que introduce y retira componentes del modelo de la memoria conforme avanza el procesamiento. De esta manera, no necesita mantener todos los pesos cargados al mismo tiempo, evitando superar los límites disponibles.
La distinción resulta importante porque 14,1 MB representan el consumo máximo de memoria de ejecución comunicado, no el tamaño completo del modelo. Los parámetros deben seguir estando disponibles en el archivo correspondiente y accederse a ellos durante las distintas etapas del cálculo, aunque no permanezcan todos residentes en RAM.
Este procedimiento permite intercambiar capacidad de memoria por tiempo de procesamiento, una solución útil cuando el hardware dispone de pocos recursos. Sin embargo, acceder repetidamente a los datos también introduce una penalización considerable, especialmente cuando el procesador carece de aceleradores diseñados para operaciones matriciales.
La velocidad real ronda un minuto por token, no 61,3 tokens por segundo
Las cifras de rendimiento requieren una aclaración importante. Wccftech presenta el resultado como 61,3 tokens por segundo, pero la publicación original de Omar Sanseviero en X habla expresamente de unos 60 segundos por token. Son magnitudes completamente diferentes y no deben utilizarse indistintamente.
La información también recoge 184 segundos para procesar la entrada inicial, formada por cuatro tokens correspondientes a la instrucción inglesa «Read the fine». El tiempo de preparación evidencia las limitaciones del sistema, aunque los datos publicados sobre la decodificación no permiten reconstruir con suficiente certeza todas las métricas de ejecución.
La demostración terminó con la impresión física de la respuesta «Read the fine print», completando así la frase inicial. Aunque se trata de una operación sencilla, confirma que el dispositivo pudo ejecutar el modelo y producir una salida mediante el mismo mecanismo utilizado habitualmente para imprimir documentos.
Por tanto, el logro no reside en alcanzar una velocidad competitiva con PCs, smartphones o aceleradores de IA, sino en demostrar que un modelo Transformer puede funcionar en un entorno extremadamente limitado. El resultado tampoco supone que una impresora convencional pueda convertirse en un asistente de inteligencia artificial práctico sin modificaciones adicionales.
El experimento muestra las posibilidades y límites de la IA local
Gemma 3 270M pertenece a la familia de modelos compactos de Google, desarrollada para facilitar aplicaciones con requisitos de procesamiento relativamente contenidos. Su menor número de parámetros permite explorar escenarios donde modelos de miles de millones de parámetros resultarían inviables, aunque también limita la complejidad de las tareas que puede resolver.
La prueba ilustra cómo la cuantización y una gestión cuidadosa de la memoria pueden reducir los requisitos de ejecución. Sin embargo, estas técnicas no eliminan la necesidad de realizar los cálculos del modelo, por lo que la capacidad del procesador continúa condicionando directamente el tiempo de respuesta.
También conviene distinguir la posibilidad técnica de ejecutar IA local de su utilidad en condiciones reales. Un dispositivo puede disponer de un lenguaje suficientemente flexible para realizar inferencia sin contar con la potencia, la eficiencia energética o las funciones necesarias para ofrecer una experiencia satisfactoria.
El experimento tampoco demuestra que cualquier impresora compatible con PostScript pueda reproducir exactamente los mismos resultados. La disponibilidad del intérprete, sus límites de memoria, las restricciones del firmware y la capacidad de procesamiento pueden variar considerablemente entre fabricantes y modelos.
En definitiva, la principal aportación de esta demostración es ejecutar Gemma 3 270M dentro de una impresora utilizando únicamente sus recursos internos. Los 14,1 MB de memoria muestran hasta dónde puede reducirse el consumo durante la inferencia, pero el tiempo necesario para generar respuestas confirma que todavía estamos ante una prueba experimental, no una aplicación práctica de la IA en impresoras.
Vía: Wccftech